1.2 MySQL 体系结构与存储引擎
1.2 MySQL 体系结构与存储引擎
本节摘要:MySQL 采用分层设计:上层负责解析与优化 SQL,下层的存储引擎插件负责真正的读写。本节沿着一条 SELECT 语句的旅程讲清四层结构,再用对照表拆解 InnoDB 与 MyISAM 的选型差异。位置:承接 1.1 的关系模型,往下为第 4 章索引原理、第 7 章参数调优铺路。
一条 SQL 的完整旅程
评审会第二环节,DBA 抛了个问题:"你们说查询慢,慢在哪一层?"全场安静。要回答这个问题,得先知道一条语句从进门到出门经过哪些关卡。
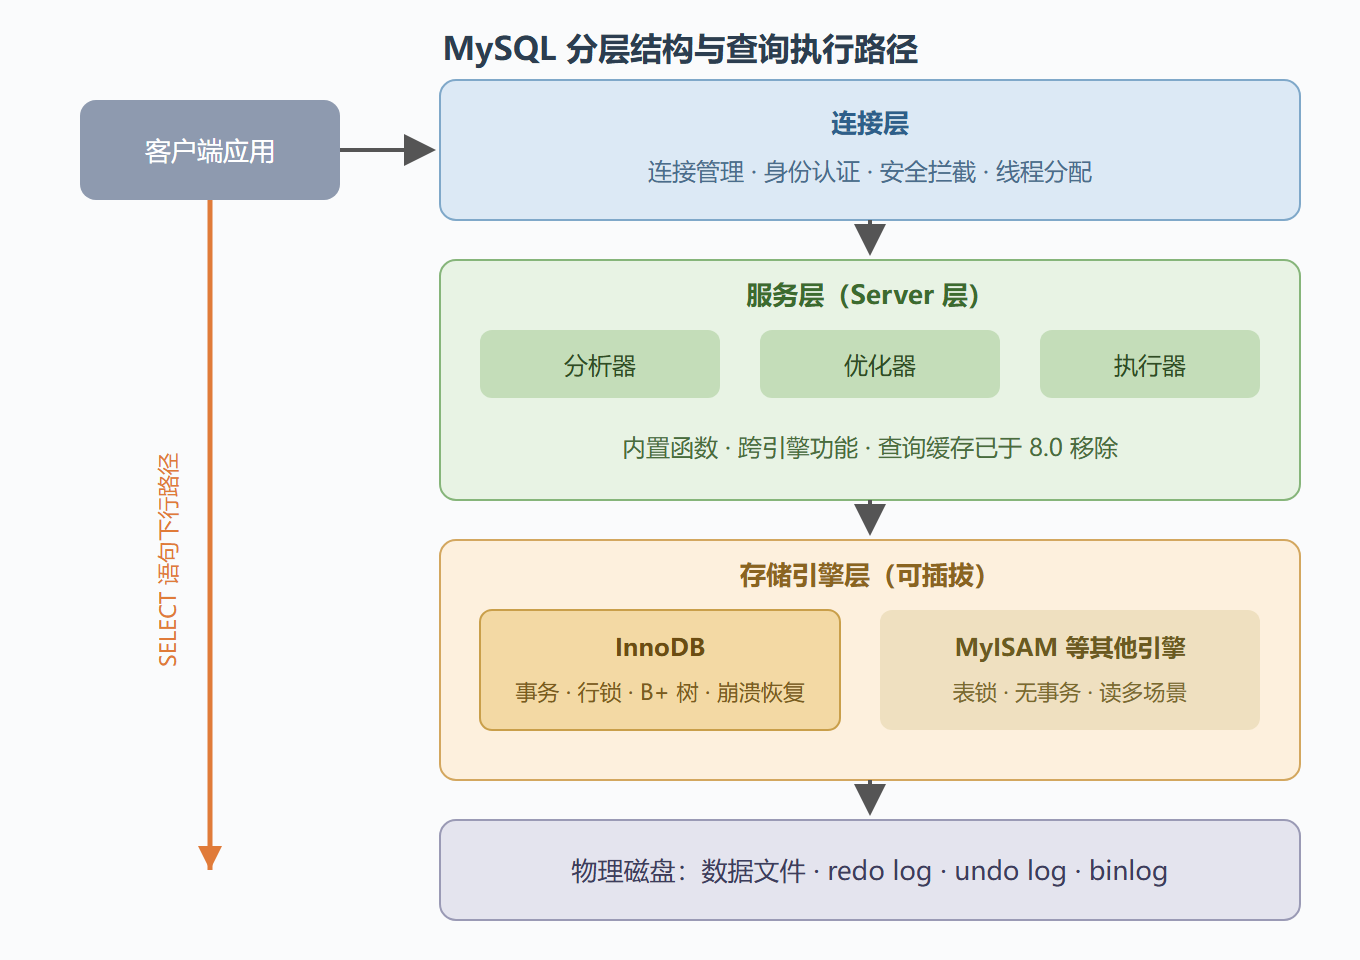
以 SELECT name FROM customer WHERE customer_id = 1; 为例。它先进入连接层:MySQL 核对用户名密码,检查这个连接有没有查询权限,然后把它分配到一个工作线程。接着进入服务层:分析器把 SQL 拆成语法树,认出这是一次单表等值查询;优化器估算各种执行路径的成本——走主键、走二级索引还是全表扫——选出它认为最便宜的一条。然后才轮到存储引擎层:InnoDB 按服务层的指令去缓冲池找数据页,命中内存就直接返回,没命中就触发磁盘 IO。最后数据沿着原路返回给客户端。
分层带来的直接好处是可插拔。存储引擎对服务层暴露统一的接口,服务层不关心底下是 B+ 树还是哈希表。你在评审会上说"这张表用 InnoDB",本质上是在说"这一块数据的读写,委托给 InnoDB 这家分包商"。一个库里的不同表可以用不同引擎——这个自由度既是灵活性的来源,也是很多混乱的源头。
图 2 · MySQL 分层结构与一条查询的路径
InnoDB 与 MyISAM:一次评审实录
评审会上最常打起来的话题就是引擎选型。还原一段真实对话——
评审委员:"日志表,只写只读不更新,用 MyISAM 省空间,行吗?"
设计者:"可以考虑,但这张表同时被运营后台实时统计访问,MyISAM 的表锁会让统计查询阻塞写入。"
评审委员:"那 InnoDB 加空间换稳定?"
设计者:"是。另外 InnoDB 的崩溃恢复是自动的,MyISAM 断电后要人工 repair,凌晨三点没人想干这个。"
翻译成选型对照表:
| 维度 | InnoDB | MyISAM |
|---|---|---|
| 事务 | 支持 ACID,redo/undo 完备 | 不支持 |
| 锁粒度 | 行级锁,并发写友好 | 表级锁,写时全表阻塞 |
| 外键 | 支持 | 不支持 |
| 崩溃恢复 | 自动,基于 redo log | 需人工修复,可能丢数据 |
| 聚簇索引 | 数据即主键索引 | 索引与数据分离 |
| 适用场景 | 绝大多数 OLTP 业务 | 只读归档、临时报表 |
我的立场很明确:默认 InnoDB,除非你能证明 MyISAM 在你的场景里快得有实际意义。MySQL 5.5 起官方默认引擎就是 InnoDB,这不是偶然——互联网业务对"不丢数据"和"高并发写"的需求,远大于 MyISAM 那点读取优势。8.0 之后 MySQL 甚至移除了查询缓存,进一步强化了 InnoDB 为中心的设计。
易错点:评审会上听过的三个错误论断
"MyISAM 不用事务,所以写入更快"——只对批量纯插入成立。行锁让 InnoDB 在并发读写混合场景反而远胜表锁的 MyISAM,"快"必须结合并发模型谈。
"引擎是建表时随手选的,后面再换"——换引擎意味着重建整张表,千万级大表要停机数小时。引擎选型必须在建表评审阶段就敲定,这正是本节在全书开篇位置的原因。
"buffer pool 越大越好"——它确实是 InnoDB 性命的根(第 7 章详谈),但设得比物理内存还大,会引发系统级换页,性能断崖式下跌。任何参数都吃资源,没有免费午餐。
评审清单与要点回顾
- 四层结构:连接层管身份,服务层管解析优化,引擎层管存储,磁盘管最终落地;
- 可插拔是双刃剑:同库异引擎自由度高,但运维心智负担翻倍,能统一就统一;
- 默认 InnoDB:事务、行锁、崩溃恢复三张牌,除非极端读多写少,不值得冒险;
- 查询路径决定优化层次:连接数问题看连接层,执行计划问题看服务层,IO 问题看引擎层——先定位层,再动手调;
- 崩溃恢复能力是隐形成本:评估引擎时把"凌晨三点谁来修表"也算进去。
至此表怎么被处理、被存放已经清楚,下一节落到最细的粒度——每个字段的类型与约束该怎么定。
评审追问集:引擎与架构的三个深水问题
追问一:redo log 和 binlog 不都是日志吗,为什么要有两份? 这是最能区分理解深度的问题。redo log 是 InnoDB 引擎层的物理日志,记的是"某个数据页做了什么改动",空间固定、循环覆盖,职责是崩溃恢复——保证已提交的事务不丢。binlog 是服务层的逻辑日志,记的是"数据变成了什么样",追加写、写满换文件,职责是复制与归档——从库重放、时点恢复都靠它。一份管"自己崩了怎么回来",另一份管"别人怎么变成和我一样",职责不同缺一不可。事务提交时两者用内部两阶段提交保持一致,答出这一层就是评审加分项。
追问二:一条 UPDATE 也要过优化器吗? 要,而且比 SELECT 更值得看。UPDATE 走哪条索引直接决定锁多少行:条件能走索引,锁的是匹配的行;走不了索引,RR 级别下扫过的行可能全部加锁,"改一行"升级成"锁一片"。评审会审写操作 SQL 时,第一个动作就是给 UPDATE 也跑一次 EXPLAIN——很多人不知道 EXPLAIN 同样适用于 UPDATE 和 DELETE,8.0 还能用 EXPLAIN ANALYZE 观察实际执行代价。
追问三:怎么快速看当前实例的引擎分布? 两条命令组合:SHOW ENGINES; 列出可用引擎与支持状态;再查 information_schema 的 tables 表,按 ENGINE 分组统计业务库里各引擎的表数量。如果查出同一业务库里 InnoDB 与 MyISAM 混杂,评审结论通常就是"统一迁移"——引擎混用意味着事务边界不统一、备份策略分裂,运维成本翻倍。迁移用 ALTER TABLE 表名 ENGINE=InnoDB,低峰执行,本质是重建表;大表则按 3.1 节的在线改表流程走。
本节要点回顾
- redo 与 binlog 各司其职:前者管崩溃恢复,后者管复制归档,两阶段提交绑定两者;
- 写操作同样要看执行计划:UPDATE 的索引选择决定锁范围,评审会不豁免任何语句;
- 引擎分布要定期盘点:information_schema 一条查询就能暴露混用风险,统一引擎省的是双倍运维。
继续往下,就进入字段级的设计细节。