1.3 数据类型与约束设计
1.3 数据类型与约束设计
本节摘要:字段类型与约束是建表时"定下来就最难反悔"的部分——改类型意味着重建表或锁表。本节按整数、定点小数、字符串、时间四大类给出选型规则,再讲六种约束的防线位置,最后用一个真实返工案例说明"最小够用"原则。位置:第 1 章收束点,直接服务于第 2 章的表结构设计。
为什么类型定了就难改
评审会第一轮打回第一版订单表,理由清单里最刺眼的一条是:所有数值字段一律 BIGINT,所有字符串一律 VARCHAR(255)。设计者的辩解是"留余量总没错"。DBA 的回应很直接:"余量不是免费的。索引要变胖、内存页利用率要下降、JOIN 时比较成本要涨。三千万行的表,每个字段多浪费 20 字节,全表多出 600 MB,缓冲池一半被你这些'余量'吃掉了。"
更麻烦的是修改成本。InnoDB 下把 VARCHAR(255) 改成 VARCHAR(50) 通常是 inplace 操作,但把 INT 改成 BIGINT、把 VARCHAR 改成不同字符集的 CHAR,往往要重建整张表。千万级大表重建期间的锁与主从延迟,是线上事故级别的动作。类型是表结构里刚性最强的决定,评审会上最该抠的就是它。
四大类类型的选型规则
图 3 · 数据类型选型决策图
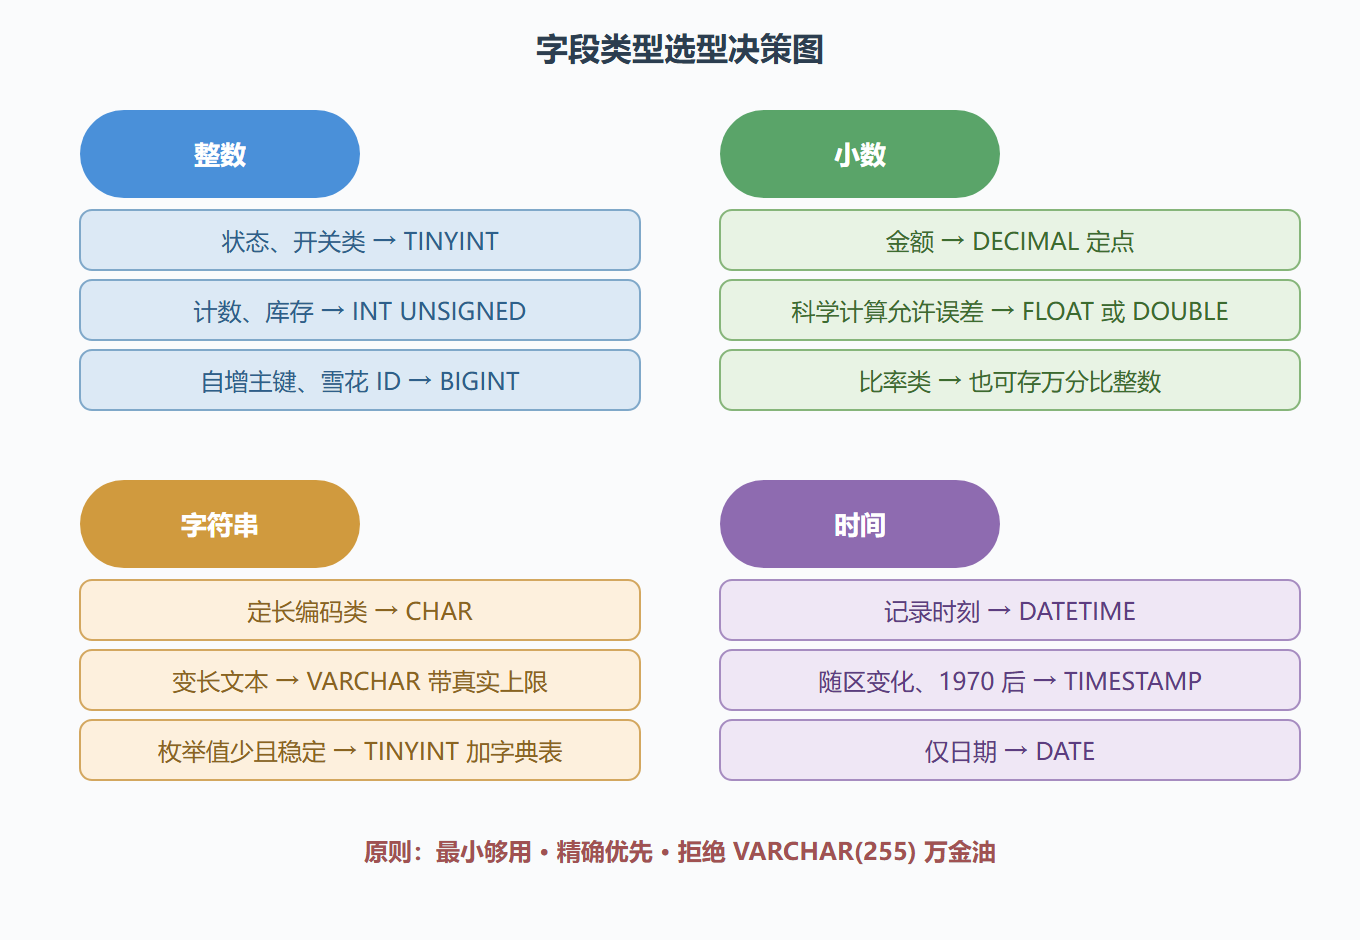
几条规则需要展开。整数按范围从 TINYINT(1 字节,-128 到 127)到 BIGINT(8 字节)递增,状态字段用 TINYINT 足矣;自增主键直接 BIGINT UNSIGNED——你不希望三年后碰到自增上限再做无锁扩容。小数的关键是 FLOAT 和 DOUBLE 是近似值,0.1 + 0.2 不等于 0.3,金额字段用它对账时差的每一分钱都是事故。DECIMAL(10,2) 精确到分且不丢精度,是金额的唯一正解。字符串最常见的坏味道就是无脑 VARCHAR(255):手机号 CHAR(11)(定长省一个长度字节)、省市区编码 CHAR(6)、邮箱 VARCHAR(64) 够用。上限填真实业务上限,让数据自己替你做一道输入校验。时间上 DATETIME 存的是字面量、不受时区影响,TIMESTAMP 占 4 字节但只覆盖 1970 到 2038 年且随连接时区转换——2038 问题未解之前,面向未来的表建议 DATETIME。
六种约束:每道防线守什么
约束是数据库替你值班的保安,六种各守一道门:
CREATE TABLE inventory ( sku_id BIGINT UNSIGNED NOT NULL COMMENT 'SKU 编号', warehouse VARCHAR(32) NOT NULL COMMENT '仓库', stock INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '在库数量', status TINYINT NOT NULL DEFAULT 1, safe_line INT UNSIGNED NOT NULL DEFAULT 10, PRIMARY KEY (sku_id, warehouse), -- 复合主键 CHECK (stock >= 0), -- 检查约束 CONSTRAINT ck_status CHECK (status IN (1, 2, 3)), CONSTRAINT ck_safe CHECK (safe_line <= stock) ) ENGINE=InnoDB;
主键守"行不重";UNIQUE 守"列值不重"(如手机号);NOT NULL 守"必须有值",顺带让优化器敢走更优计划;DEFAULT 免去应用层重复填零;CHECK(8.0.16 起真正生效)把业务规则写进表里——库存不能为负这种规则,写在这里比指望每个 INSERT 的代码都记得检查可靠得多。外键守表间引用,上一节已谈过取舍。
约束放数据库还是应用? 评审会上的共识句式:能用一条 CHECK 表达的规则放数据库,因为它是最后一道闸;涉及外部数据或流程的规则放应用,因为数据库看不见上下文。两层校验不是重复,是纵深。
演练:CHECK 约束拦截负库存
背景:防止并发扣减后库存变负。操作:
UPDATE inventory SET stock = stock - 100 WHERE sku_id = 8001 AND warehouse = 'SH01'; -- 结果:ERROR 3819 Check constraint 'ck_stock' is violated.
解读:即使应用层 bug 或人工 SQL 失误写入了超扣语句,数据库在存储引擎层拒绝提交,数据底座不破。变式:真正的并发扣减还应在 WHERE 里加 AND stock >= 100 形成原子竞争,CHECK 是兜底不是唯一手段——这个话题第 6 章讲锁时还会回来。
评审追问集:类型设计的三个深水问题
追问一:UNSIGNED 到底要不要用? 有两派观点。支持者说库存、计数这类天然非负的字段用 UNSIGNED 能把 INT 的上限翻倍到 42 亿;反对者说 MySQL 的 UNSIGNED 在运算时减出负数会报错,跨库迁移到不支持的数据库还要返工。我的建议按字段语义定:库存、计数用 UNSIGNED,差额类字段(可能为负的余额变动)用 SIGNED。关键是评审时说出理由,而不是默认跟着建表模板走。
追问二:VARCHAR(50) 和 VARCHAR(255) 明明都是变长,差在哪? 差在索引与排序的内存账上。索引的 key_len 按类型上限计算,utf8mb4 下 VARCHAR(255) 的索引键长是 1022 字节起步,而 VARCHAR(50) 只有 202 字节——索引页能放更多键,树更矮,缓存命中率更高。排序场景同理,sort buffer 按定义长度预留。所以"变长所以随便写"是错觉,上限该按真实业务写。
追问三:时间字段要不要配自动更新? updated_at DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP 让数据库替你维护"最后修改时间",审计与缓存失效判断都受益。代价是每次 UPDATE 都多一次列更新,且应用侧 ORM 若也在管同一字段会互相打架。团队约定取其一:要么数据库管,要么应用管,别两头都写。
易错点与评审清单
- 金额永远 DECIMAL,运算可在应用层转分为整数,存储层别用浮点;
- CHAR 与 VARCHAR 的区别是填充与开销:CHAR 定长截尾填充,VARCHAR 按实际长度加 1–2 字节记录长度,变长数据硬塞 CHAR 是反向优化;
- NULL 的代价被低估:可为 NULL 的列在索引统计、比较运算、聚合函数里处处是坑,能用 NOT NULL 加默认值就别放任 NULL;
- 字符集要统一:库、表、连接三处统一 utf8mb4,混用 latin1 迟早出乱码事故,emoji 存不进 utf8 也是经典翻车点。
评审委员对本章的最后提问通常是:这张表的每个字段,你能说清"为什么是这个类型、为什么是这个上限"吗?答得清,第一轮评审就过了。带着这份字段清单,我们进入第 2 章——从单表走向整体设计。