4.3 复合索引与覆盖索引
4.3 复合索引与覆盖索引
本节摘要:复合索引是"把多个查询模式编码进一棵树"的艺术,列顺序就是编码方式;覆盖索引则更进一步,让查询全程不回表。本节推导最左前缀原则、演示列顺序的决策过程,并用一个真实调优案例把两项技术合起来用。位置:索引设计的核心策略课,第 5 章 EXPLAIN 的所有指标都在验证本节的决策。
最左前缀:从排序方式推导出来
复合索引 (a, b, c) 的排序规则是:先按 a 排,a 相同再按 b 排,b 相同再按 c 排——像字典先按首字母、再按第二个字母排。理解了排序方式,哪些查询能用上这棵树就是纯逻辑推理:
WHERE a = 1能用(只看首字母);WHERE a = 1 AND b = 5能用(首字母加次字母);WHERE b = 5不能用(跳过首字母,b 在树里是散布的);WHERE a = 1 AND c = 5只用到 a(b 缺位,c 无法在 b 未定时定位);WHERE a = 1 AND b BETWEEN 2 AND 9 AND c = 5用到 a 和 b(范围条件之后的部分失效,因为范围扫描后 c 的有序性已被打破);ORDER BY a, b能免排序(索引天然有序)。
评审会考题标配:"查询是 WHERE b = 5 AND c = 6,建了索引 (b, c),为什么 EXPLAIN 里 key 是空的?"答案就在上面第二条——这个索引其实能用,key 为空另有原因;但如果建的是 (a, b, c) 而 a 未出现,那就真用不上。先看列在不在前缀里,再谈失效。
列顺序怎么排:等值在前,范围在后,选择性佐证
决策三步。第一步,把查询里等值条件的列放前面;第二步,范围条件的列放等值之后;第三步,同等条件下把选择性高的放前面。用一个真实需求走一遍:订单列表页高频查询是"某客户某状态下的订单,按时间倒序"。
-- 候选写法 SELECT order_id, amount, created_at FROM orders WHERE customer_id = 10086 AND status = 2 ORDER BY created_at DESC LIMIT 20;
分析:customer_id 和 status 都是等值,created_at 是排序。最优索引是 (customer_id, status, created_at)——前两列等值定位后,第三列在剩余集合内天然有序,ORDER BY 直接被索引消化,不用 filesort。如果建反成 (status, customer_id, created_at) 也能用(等值交换顺序仍可匹配),但把 created_at 放到 status 前面就毁了:范围或排序列夹在中间,后面的列全废。
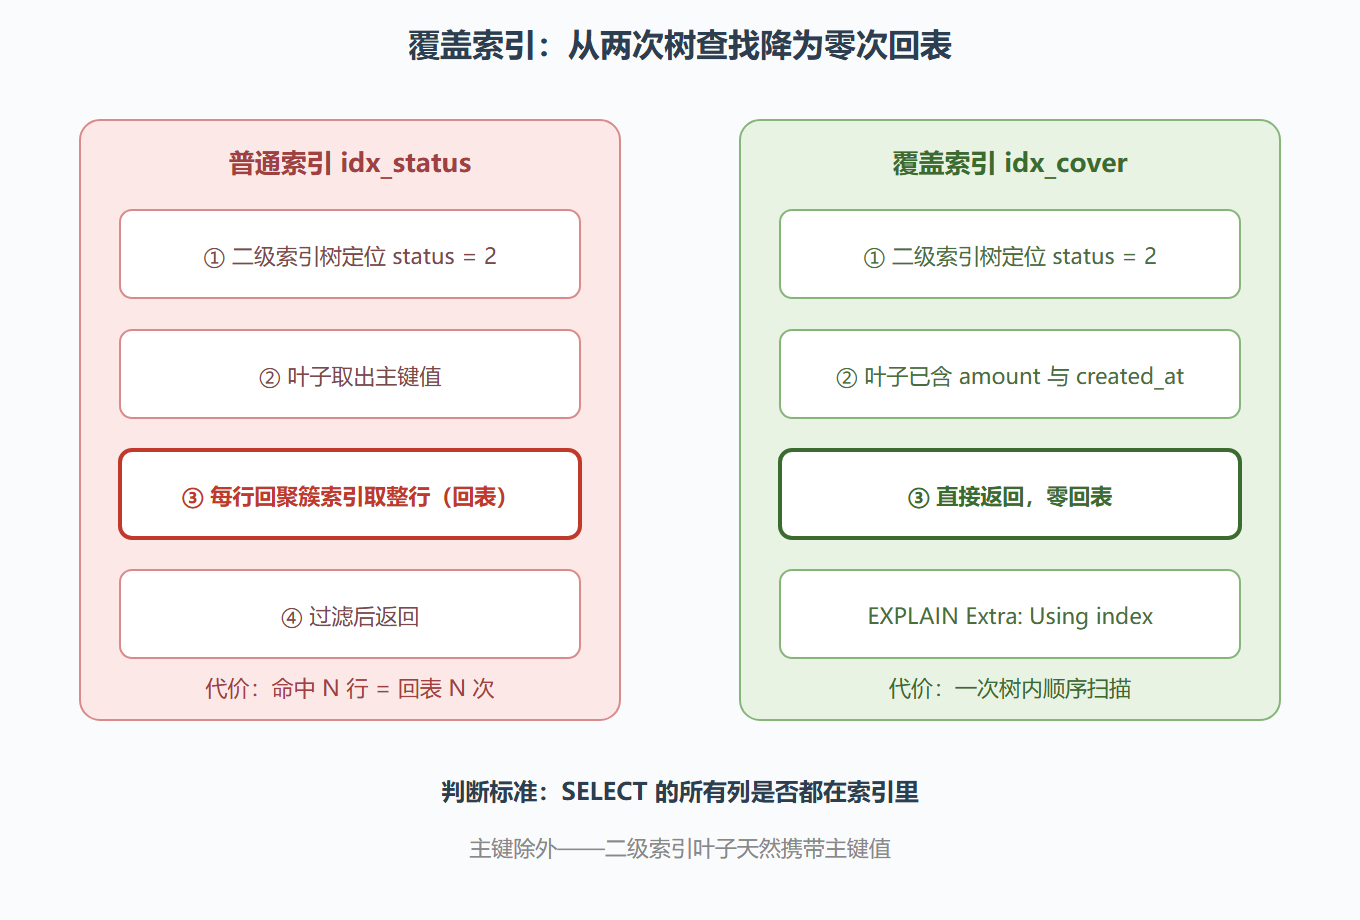
图 8 · 覆盖索引消除回表的执行对比
完整演练:一条 1.8 秒查询的收敛
背景:订单列表页接口 P95 达 1.8 秒,业务要求压到 200ms 内。语句如下:
SELECT order_id, amount, created_at FROM orders WHERE customer_id = 10086 AND status = 2 ORDER BY created_at DESC LIMIT 20;
操作与结果:当时表上只有单列索引 idx_customer,EXPLAIN 显示 type=ref、rows=37000,因为命中该客户的订单有三万七千条,全部回表后再排序取 20 条。分两步改。第一步加复合索引 (customer_id, status, created_at),type 变 ref、rows 降到 2100、filesort 消失,P95 降到 400ms。第二步注意到 SELECT 三列恰好都是索引列(order_id 是主键,索引叶子自带),升级为覆盖索引场景——EXPLAIN 的 Extra 出现 Using index,零回表,P95 最终 90ms。解读:一次调优吃下三段收益——等值定位、免排序、免回表,全部来自本节的两件武器。变式:若业务还要返回用户昵称(不在索引里),覆盖被打破,那就评估把昵称做冗余列(第 2 章反范式)进索引尾部,或接受回表但确保扫描行数已被前两列压到百级。
易错点与评审清单
- 按列出现顺序建一堆单列索引:应合并设计成少数复合索引;一个设计好的复合索引常常同时服务三四个查询模式;
- 索引列里放长 TEXT:整个索引跟着膨胀,长文本要么前缀索引要么别进索引;
- 覆盖索引无限加列:索引里塞十来个列后,它自己变成一张小表,写入税翻倍——覆盖索引列数控制在三到五列;
- 忘了范围列之后全失效:把 created_at 这类范围列放中间,等于砍掉后面的兄弟列,顺序要重排。
要点回顾:最左前缀是排序方式的逻辑推论,可以推理不需要背;等值在前、范围在后、选择性佐证;覆盖索引的判据是 SELECT 列全在索引中,EXPLAIN 看 Using index;一个索引服务多个查询模式,才算把空间税交得值。策略学会了,下一节专收"为什么明明建了索引却不用"的账。
覆盖索引判定与改造演练
覆盖索引的判定标准只有一条:查询需要的每一个列,都在同一棵索引树里。命中时执行计划的 Extra 列出现 Using index,意味着连主键树都不用回。
看一组对照。订单表 orders 上有复合索引 (customer_id, status, created_at),主键 id。
-- 查询一:只取索引列,Extra 出现 Using index,无需回表 EXPLAIN SELECT status, created_at FROM orders WHERE customer_id = 88001; -- key: idx_customer_status_created Extra: Using where; Using index -- 查询二:多取一个不在索引里的 total_amount,回表开启 EXPLAIN SELECT status, created_at, total_amount FROM orders WHERE customer_id = 88001; -- key: idx_customer_status_created Extra: Using where
第二条语句的 Extra 少了 Using index,多出来的代价是:每命中一条二级索引记录,就拿着主键回主树取一次 total_amount。命中一万条就是一万次随机 IO——这正是"看起来走了索引却依然慢"的典型来源。
改造有三条路,评审会上按代价从小到大依次考虑:
- 砍列:确认 total_amount 是否真要返回。列表页往往只需要状态与时间,金额是详情页才看的字段,拆成两条 SQL 即可;
- 扩索引:把 total_amount 加进索引尾部,变成
(customer_id, status, created_at, total_amount)。代价是索引变宽、写入变慢、占用更多空间,且改变了原有索引的最左前缀匹配行为,需要回归验证; - 接受回表:如果命中行数本来就只有几十条,回表成本可以忽略,此时为覆盖而扩索引属于过度优化。
量化回表代价的估算口径:回表次数约等于二级索引命中的行数,单次成本约等于一次主键树的随机查找。单表命中行数百量级时不必纠结,上万量级且该 SQL 高频时,覆盖索引的收益才开始显著。
还有一个容易踩的细节:SELECT * 天然与覆盖索引无缘。只要有一个列不在索引里,整条语句就退回回表路径。评审会上看到高频接口写成 SELECT *,第一条意见永远是"把要用的列写出来"——这既是覆盖索引的前提,也是减少网络传输与后续加列风险的通用做法。