4.4 索引失效场景
4.4 索引失效场景
本节摘要:索引建了不代表会用。八类高频失效写法各有物理成因——让树无法定位、让比较失去有序性、让成本核算逆转。本节逐类演示:失效 SQL、EXPLAIN 症状、修正写法。位置:第 4 章的实战验收,也是评审会 SQL 审查环节的速查表。
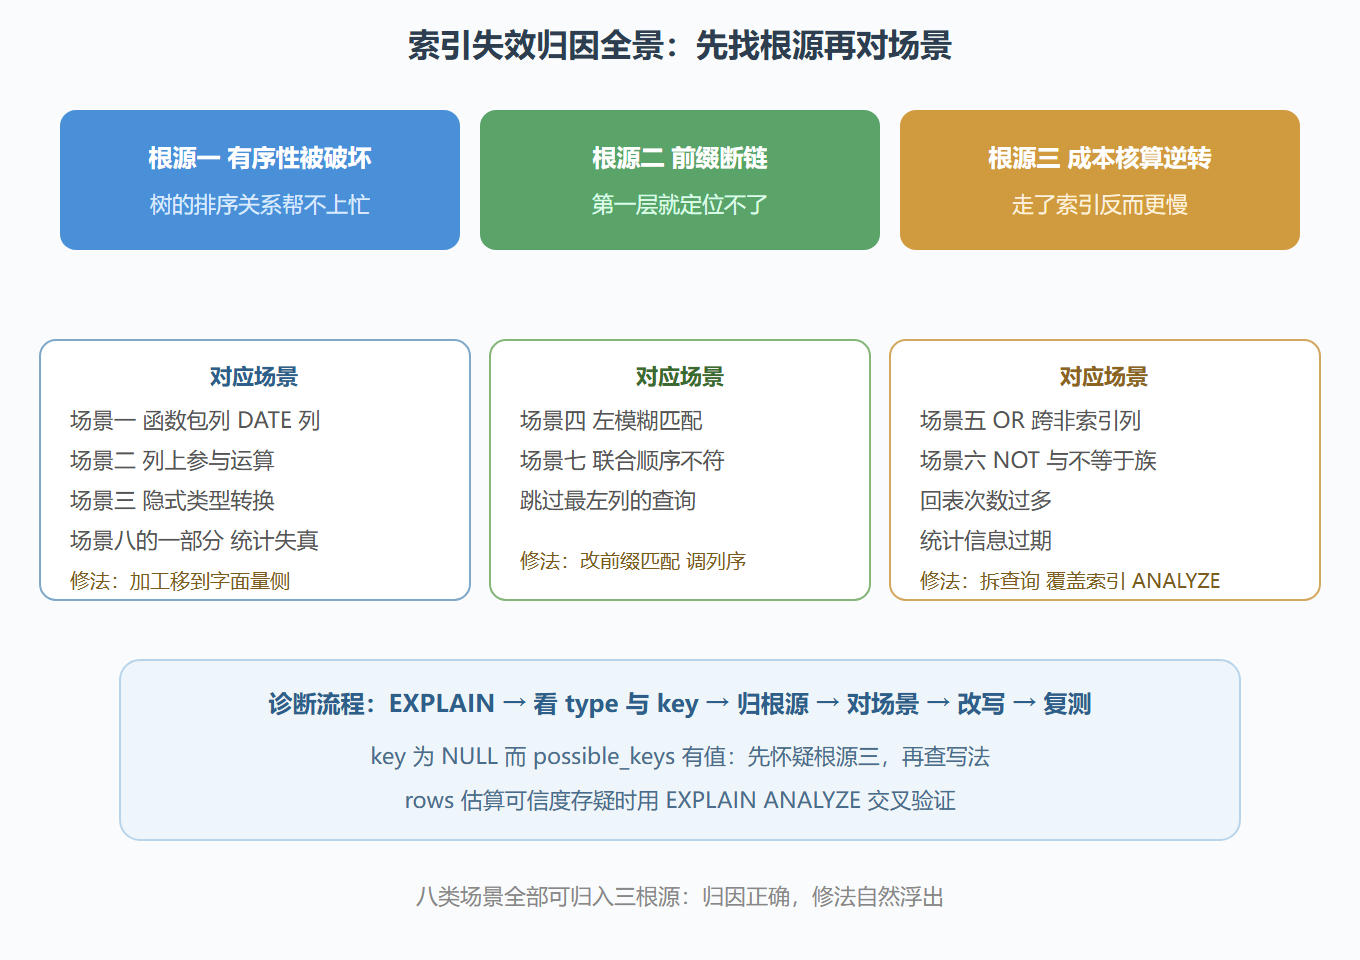
图 15 · 索引失效归因全景:三个根源八条岔路
为什么会失效:三个物理根源
先把失效归成三个根源,再逐类对号入座,比死记八条更有迁移力。根源一:破坏了有序性——对索引列做运算、函数包裹、隐式类型转换,树上的排序关系对比较对象不再成立。根源二:前缀断了——最左列缺席、左模糊匹配,树的第一层就没法定位。根源三:优化器判定不走更快——回表次数太多、区分度太低、统计信息过期,走索引反而慢。第三类最容易被误解,它其实不是"失效",是优化器的理性选择。
八类场景逐条过
场景一:列上包函数。WHERE DATE(created_at) = '2024-06-01',对每行调用函数后比较,树的有序性帮不上忙。修正:改写为范围条件 created_at >= '2024-06-01' AND created_at < '2024-06-02'。通用口诀:函数包列不如范围改写,8.0 也可以建函数索引兜底。
场景二:列参与运算。WHERE order_id + 1 = 1000,等价但不可索引。修正:把运算移到常量一侧 WHERE order_id = 999。
场景三:隐式类型转换。phone 是 CHAR(11),写 WHERE phone = 13800001111,MySQL 把每行的字符串转成数字比较,索引失效;更阴险的是反过来(字符串列与数字列比较)还可能匹配到错误结果。修正:字符串列一律字符串字面量 WHERE phone = '13800001111'。
场景四:左模糊。WHERE title LIKE '%键盘%',前缀未知,树无从定位。修正:能改前缀匹配 LIKE '机械%' 就改(走前缀索引);真需要任意位置匹配的,上全文索引或搜索中间件。
场景五:OR 跨非索引列。WHERE customer_id = 1 OR remark = '加急',remark 无索引,OR 意味着两路扫描取并集,优化器干脆全表。修正:无索引条件单独拆查询或给 remark 建索引;UNION ALL 改写也常被采用。
场景六:NOT 与不等于族。!=、NOT IN、IS NOT NULL 通常要扫大半个索引,优化器常弃用。它们不"违规",只是天然低选择性——遇到这类条件,换思路:改写成 IN 正向枚举,或用覆盖索引把扫索引的成本降下来。
场景七:联合索引顺序不符。索引 (a, b) 而查询只给 b。修正:调索引列序或补等值条件。这是设计问题不是写法问题,回到 4.3 的决策三步。
场景八:统计信息失真。表刚灌完大批数据没做 ANALYZE,优化器拿着旧统计误判成本。修正:ANALYZE TABLE orders; 刷新;长期方案是监控索引统计的更新频率。
演练:用 EXPLAIN 定位一次失效
背景:报表接口突然变慢,语句是 SELECT * FROM orders WHERE DATE(created_at) = CURDATE();。操作与诊断:
EXPLAIN 前两列关键输出: type: ALL ← 全表扫描 key: NULL ← 索引没被使用 rows: 21000000 ← 扫描两千一百万行 Extra: Using where 归因:created_at 被 DATE() 包裹 → 场景一 修正后 EXPLAIN: type: range ← 范围扫描 key: idx_created rows: 3521 Extra: Using index condition
结果:扫描行数从两千一百万降到三千五百,响应从 4.6 秒到 30ms。解读:诊断顺序永远是 type → key → rows → Extra,type 的等级序列(system > const > eq_ref > ref > range > index > ALL)就是健康刻度,ALL 出现在大表上必须给出理由。变式:如果修正后 key 仍为 NULL 但 possible_keys 有值,检查统计信息(场景八)或回表成本估算(根源三),别急着怪写法。
评审速查清单与要点回顾
把八类场景压成评审会上的一分钟口头检查单:函数包列?列上运算?类型不匹配?左模糊?OR 跨非索引列?NOT 族?联合顺序?统计过期?四个问题有任一命中,这条 SQL 进待改清单。
- 失效三根源:有序性被破坏、前缀断链、成本核算逆转,归因比背清单重要;
- 修正是改写不是硬上:函数改范围、运算移常量、类型对齐、模糊改前缀;
- type 等级是健康刻度:大表出现 ALL,要么补索引要么给出业务理由;
- 失效排查要配 EXPLAIN 实证:猜测不算数,key 和 rows 说了算。
索引的故事到这里讲完,下一章我们把 EXPLAIN 的每个字段展开——你会看到一个完整的"查询体检报告"怎么读。
排错演练:五条慢 SQL 逐条改
下面五条都来自同一张订单表 orders,主键 id,二级索引 (customer_id, status, created_at)。每条先给原句,再给改法与依据。
其一,索引列上套函数。
-- 原句:对 created_at 套函数,B+ 树有序性失效,全表扫 SELECT * FROM orders WHERE DATE(created_at) = '2026-08-01'; -- 改法:改成范围条件,让索引保持连续区间扫描 SELECT * FROM orders WHERE created_at >= '2026-08-01 00:00:00' AND created_at < '2026-08-02 00:00:00';
其二,隐式类型转换。 customer_id 是 varchar,却传了数字。
-- 原句:字符串列与数字比较,MySQL 对索引列做隐式转换,索引失效 SELECT * FROM orders WHERE customer_id = 88001; -- 改法:类型对齐,传字符串 SELECT * FROM orders WHERE customer_id = '88001';
这一条在生产上极隐蔽:语句能跑、结果也对,只是永远全表扫。评审会的做法是把表结构的列类型贴进代码评审清单,凡是有数字与字符串混用的入参一律退回。
其三,违背最左前缀。 索引是 (customer_id, status, created_at),查询只给了 status。
-- 原句:跳过首列,无法用上复合索引 SELECT * FROM orders WHERE status = 'PAID'; -- 改法一:补上首列条件(业务上确实能拿到 customer_id 时最优) SELECT * FROM orders WHERE customer_id = '88001' AND status = 'PAID'; -- 改法二:status 是独立高频维度时,为它单独建索引 ALTER TABLE orders ADD INDEX idx_status (status);
其四,范围条件后的列用不上。 复合索引中,范围条件(>、<、BETWEEN)之后的列只能当过滤项,不能继续走索引定位。若查询是 customer_id = ? AND created_at > ? ORDER BY status,排序仍需额外代价,此时应把等值列尽量前置、把排序目标放在范围列之前。
其五,前导模糊匹配。 LIKE '%keyword' 无法利用索引有序性,只有 'keyword%' 可以。真要支持任意位置匹配,走全文索引或外部检索组件,不要指望 B+ 树。
五条改完,评审会补一条流程意见:每次上线新 SQL,都把执行计划随工单一起提交。索引失效极少是设计失误,绝大多数是后来改了一行代码、换了一种写法,而没人再看执行计划。