6.2 主从复制与读写分离
6.2 主从复制与读写分离
本节摘要:主从复制把主库的数据变更实时搬运到从库,读写分离在此之上把读流量分出去。本节讲清 binlog 三种格式的取舍、复制链路的两线程模型、延迟的成因,以及写后读一致性的三种策略。位置:6.1 并发地基之上的第一级架构扩展,也是高可用方案的起点。
复制链路:一笔写入如何到达从库
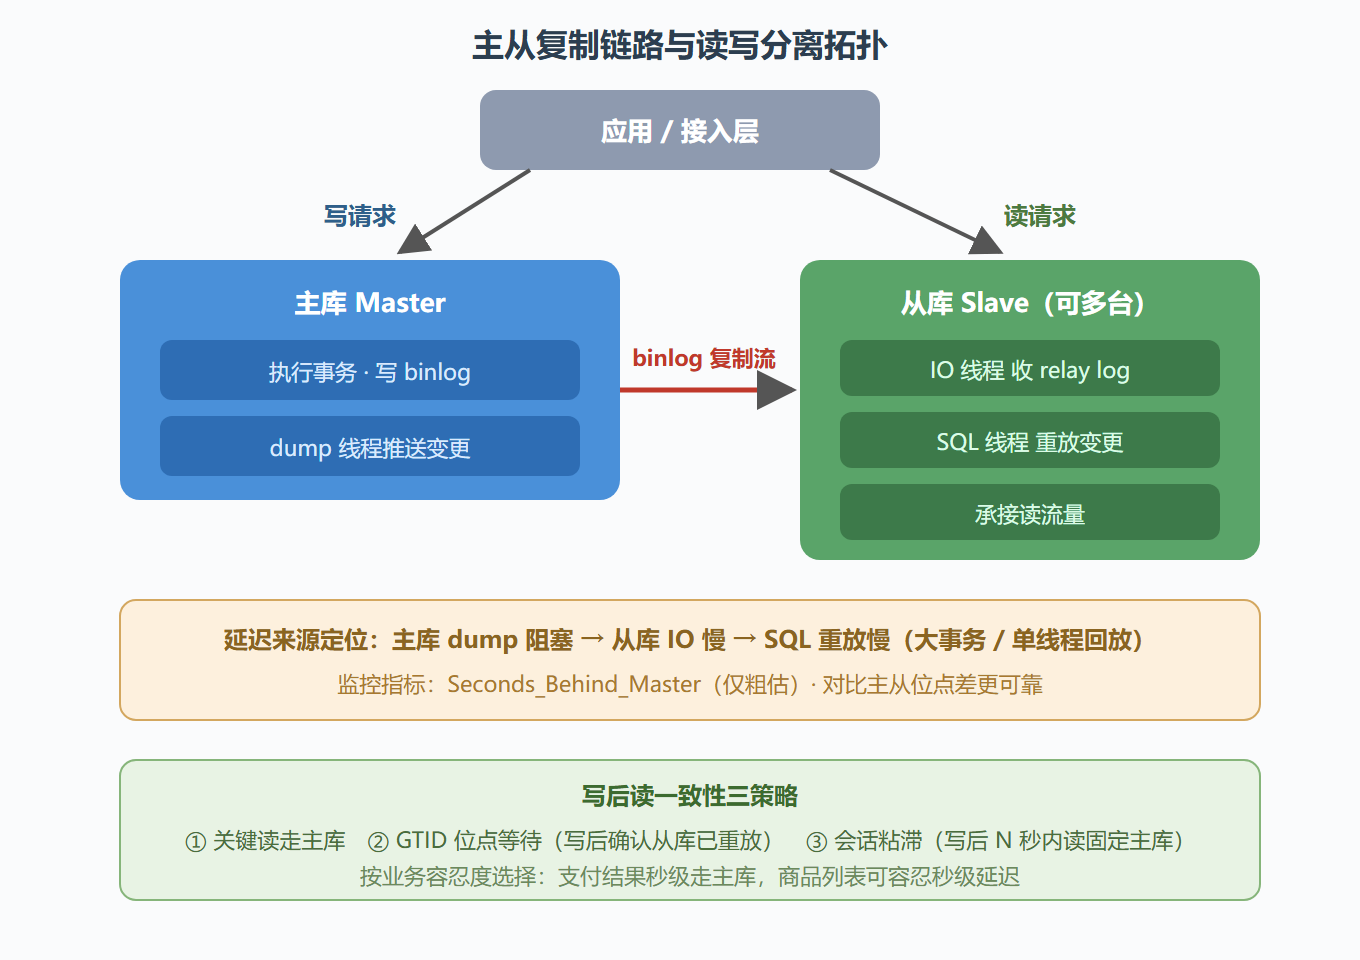
评审会问"主从复制的原理",能讲清三段式的不多。完整链路是:①主库执行事务,把变更写进 binlog(二进制日志,记录的是"做了什么"或"数据变成了什么");②主库的 dump 线程把 binlog 内容推送给从库;③从库的 IO 线程接收并写入本地 relay log(中继日志);④从库的 SQL 线程重放 relay log 里的变更。理解这条链,延迟问题就有了定位坐标系:主库提交快但 dump 慢?从库 IO 慢?还是 SQL 重放慢?
binlog 三种格式决定重放的忠实度:STATEMENT 记 SQL 语句本身,日志小,但 NOW()、UUID() 这类非确定性函数在从库重放会得到不同结果;ROW 记每行数据的前后镜像,忠实可靠但日志大,是 8.0 的默认;MIXED 混合两者按需切换。现状共识:默认 ROW,配合 binlog_row_image 控制日志量。ROW 还有一个隐藏福利——数据误删时可从 binlog 反向恢复,这在 7.1 备份节还会回来。
图 11 · 主从复制链路与读写分离拓扑
延迟是常态,方案是关键
复制是异步的,延迟是必然的,问题是多大与怎么办。常见成因按频率排:从库机器规格低于主库(单线程重放追不上多线程写入)、从库上的大查询拖住 SQL 线程、主库大事务(一条语句改一百万行,从库要整体重放完)、从库数量过多摊薄主库 dump 带宽。对症下药:8.0 的并行复制(基于 WRITESET 的多线程重放)解决追不上;大事务拆小解决重放慢;级联复制缓解主库推送压力。
读写分离落地后最大的坑是写后读不一致:用户刚下单,跳转到订单页查不到——写进了主库,读打到了延迟 200ms 的从库。三种策略按业务容忍度选,如图底部所示。我的建议是先做策略③(会话级粘滞)做兜底,再对支付、余额等强一致场景显式走策略①,策略②留给中间件层统一实现。
演练:搭一主一从并验证延迟
背景:测试环境搭建主从,验证读写分离前的复制链路。操作四步:
-- 主库:创建复制账号(最小授权,仅 REPLICATION SLAVE) CREATE USER 'repl'@'10.0.%' IDENTIFIED BY '复制专用密码'; GRANT REPLICATION SLAVE ON *.* TO 'repl'@'10.0.%'; -- 主库:查看当前位点(8.0 推荐 GTID 模式,这里演示传统模式) SHOW MASTER STATUS; -- 输出 File: binlog.000042 Position: 88213 -- 从库:指向上游(IP 与位点按实际填写) CHANGE MASTER TO MASTER_HOST = '10.0.1.10', MASTER_USER = 'repl', MASTER_PASSWORD = '复制专用密码', MASTER_LOG_FILE = 'binlog.000042', MASTER_LOG_POS = 88213; START SLAVE; -- 从库:检查复制状态 SHOW SLAVE STATUS; -- 关键字段:Slave_IO_Running: Yes Slave_SQL_Running: Yes -- Seconds_Behind_Master: 0
结果:两项 Running 均为 Yes、延迟为 0,链路就绪。验证动作:主库建一张临时表,从库立刻能查到。解读:真出问题时按"先看两个 Running、再看延迟、再对位点"排查;IO 线程 No 多为网络或账号问题,SQL 线程 No 多为重放冲突(常见于从库被误写,从库必须设 read_only)。变式:GTID 模式用 MASTER_AUTO_POSITION = 1 替代手工对位点,换主、补从都省心,新搭建一律建议 GTID。
易错点与评审清单
- 从库不设 read_only:误写从库导致复制中断(SQL 线程报主键冲突),恢复要重建,成本极高;
- 把 Seconds_Behind_Master 当精确值:它只在重放事件时更新,主库空闲时会显示 0 的假象,关键场景用位点差或心跳表校验;
- 读写分离全靠业务代码 if else:接入选型(代理中间件或客户端 SDK)要在架构评审定案,散落各处的读写路由是事故温床;
- 所有从库同规格假设:读流量不均匀时部分从库先挂,负载均衡层的健康检查与权重配置(下一节)要与从库规格匹配。
要点回顾:复制链路四段式,binlog 格式默认 ROW;延迟定位按 dump、IO、重放三段排查;写后读一致三策略按业务容忍度选择;从库必设 read_only,GTID 优于位点。读写分了流,单库写入的容量天花板还在,下一节把数据切开。
复制延迟的定位与处置
读写分离最大的坑不在架构,而在延迟:刚写入的数据,从库读不到。用户下单成功却看不到订单,是这个架构下最高频的投诉。
先看延迟数字,再看数字可信度。
SHOW SLAVE STATUS\G -- Seconds_Behind_Master: 0 -- Slave_SQL_Running_State: Waiting for dependent transaction to commit
Seconds_Behind_Master 为 0 不等于真的没延迟:它衡量的是从库当前执行的事务时间戳与系统时间的差,若从库 SQL 线程正在等待并行事务提交,这个字段可能显示为 0 而实际已经积压。更可靠的做法是打点对比:在主库写一张心跳表(每秒更新一次时间戳),在从库读这个时间戳,差值才是真实的业务可感知延迟。
延迟的来源按出现频率排序:
- 从库单线程回放跟不上主库并发写入。主库几百个连接并发提交,从库默认单线程按序回放,必然积压。解法是开并行复制,按库或按事务组并行;
- 从库扛了不该扛的查询。一个大表的统计查询跑满从库 CPU,回放线程抢不到资源。解法是把分析类查询剥离到独立的专用从库,别和在线读混在一起;
- 大事务。主库一个事务删了 200 万行,从库必须完整回放这 200 万行才能继续,期间的延迟无法避免。解法是在业务侧把大事务拆成小批量;
- 从库硬件弱于主库。采购时"从库可以差一点"的想法,会在流量峰值时以延迟的形式还回来。
处置时的业务侧手段(按侵入性从低到高):
- 写后读走主库:对一致性敏感的操作(下单后跳转详情页、修改资料后刷新),显式路由到主库。代价是需要业务代码感知,通常通过数据源注解或框架层标记实现;
- 延迟阈值感知路由:监控到从库延迟超过阈值(如 1 秒)时,把读流量临时切回主库或摘掉该从库。代价是需要一套健康检查与动态路由机制;
- 延迟窗口内降级提示:前端提示"数据同步中,请稍后刷新",是最不优雅但最省事的做法,适用于低频、非核心场景。
评审会上的默认结论通常是:读写分离默认开启,但对"写后立即读"的场景必须显式指定主库。这条规则写进开发规范,比事后逐个接口排查成本低得多。