6.3 分库分表
6.3 分库分表
本节摘要:当单库写入吞吐或单表行数触到天花板,就要把数据切开:垂直拆分按业务边界分库分表,水平拆分按分片键把同构数据散到多个物理库。本节讲拆分的触发时机、分片键与路由算法的选择、跨分片查询与全局 ID 两大衍生难题。位置:复制解决读扩展之后,突破写容量的手段,也是架构复杂度陡增的分水岭。
先问要不要拆
评审会必须先拦住"为了简历拆库"的冲动。触发拆分的真实信号只有几类:单表行数过大导致 DDL 与备份以小时计(经验值:B+ 树三层装不下的数亿行)、单库写入 QPS 顶到磁盘与锁的上限(读写分离已救不了写)、单机存储物理上限、以及业务隔离需求(交易与日志必须物理隔离)。判断口诀:读的问题先找索引和缓存,写的问题才谈拆分;量不到,不拆。拆分引入的复杂度——跨分片查询、分布式事务、全局 ID、扩容搬迁——每一项都是长期成本,签收前想清楚。
垂直拆分:按业务切
垂直分库按业务域切:订单库、商品库、用户库各自独立实例,服务边界与数据库边界对齐,这是微服务化的自然结果。垂直分表按访问频率切:商品主表放高频字段,详情大字段挪到扩展表,把缓冲池留给热数据。垂直拆分风险低、收益立竿见影,且不引入跨行事务的复杂度——先垂直后水平是标准次序,很多系统垂直拆完就够用了好几年。
水平拆分:分片键定生死
水平拆分把同一张表的数据按某个列的值散到多个库表。三要素:分片键、路由算法、分片数量。分片键的选择标准一句话:让最高频的查询路径带上它。订单系统高频查询是"查我的订单",分片键选 customer_id;SaaS 系统选租户 ID;日志类选时间。
图 12 · 水平分片路由与跨片查询代价
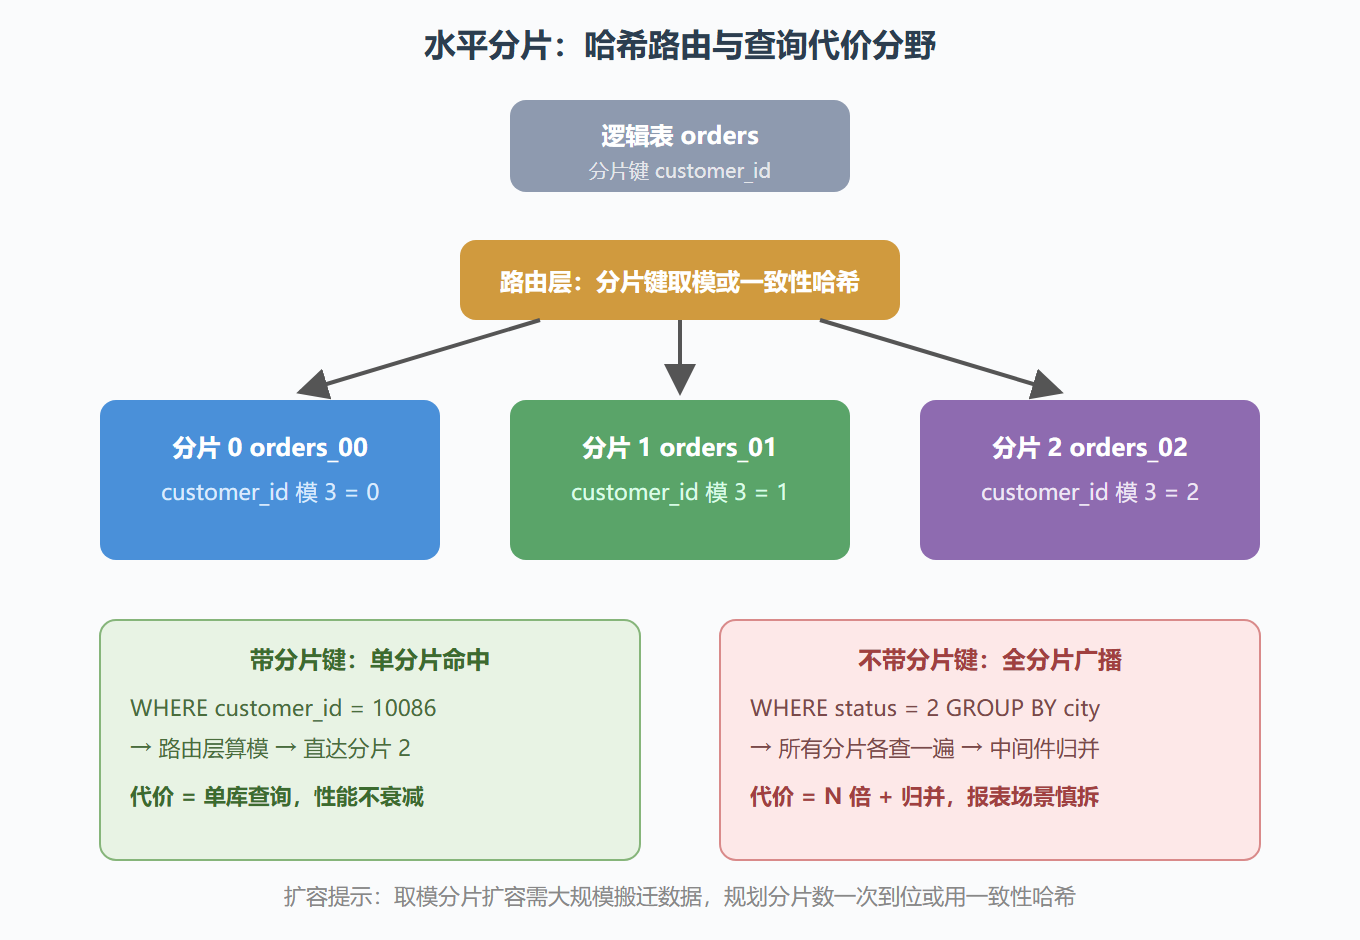
路由算法两种主流:取模哈希(customer_id mod N)数据均匀但扩容要大规模搬迁;范围路由(按时间或 ID 区间)扩容只加新片,但热点集中(最新分片最热)。折中方案是一致性哈希或基因法(让订单 ID 内嵌分片基因,既能按订单查也能按客户查)。分片数量一次规划到位(比如 32 片映射到若干物理库),用逻辑片与物理库解耦,将来扩容只搬逻辑片。
两大衍生难题
跨分片查询:不带分片键的查询要广播全部分片再归并,如图右下。缓解手段按优先级:二级索引映射表(记录订单 ID 与分片的对应关系)、异构索引库(同步一份数据按查询维度组织,类搜索中间件思路)、冗余双写(订单同时按 customer_id 和 merchant_id 两套分片各写一份)。分布式事务:跨分片写入要么走柔性事务(消息最终一致,3.3 与 6.2 的思路组合),要么用 XA(性能代价大)。评审会标准答案:尽量避免设计出需要跨分片强一致的业务流程,域内闭环是分片友好设计的核心。
全局 ID:自增主键在分片后必然冲突。主流方案:号段模式(应用批量领号段缓存使用)、雪花算法(时间戳加机器号加序列,趋势递增对 B+ 树友好)。注意雪花对时钟回拨敏感,选型时确认中间件的处理策略。
易错点与评审清单
- 分片键选了"查询少用的列":等于把所有高频查询都变成广播,拆完比拆前还慢,选键前先统计真实查询分布;
- 一步到位拆成几百片:片数过多运维翻倍,先按未来三到五年容量规划,留逻辑片弹性即可;
- 忘记同步拆索引与容量计划:每个分片的索引、缓冲池、备份窗口要重新核算,不能拿单库时代的老口径;
- 跨片 JOIN 想当然:两个分片键不同的表 JOIN 是分布式难题,设计阶段就让强关联表共享分片键(订单与订单明细都按 customer_id 分)。
要点回顾:先问要不要拆,读瓶颈不归分片管;先垂直后水平;分片键让高频路径带上它;路由算法在均匀与扩容间权衡;跨片查询与全局 ID 是两笔先算清的账。数据分好了,下一节把整套系统编排成"坏一台也不停服"。
演练:从 2 片扩到 8 片,数据怎么搬
分片方案选定后,真正的考验在扩容。假设订单表按 customer_id 分了 2 片,如今容量告急要扩到 8 片,取模规则从 mod 2 变成 mod 8。
方案一:停机搬迁(最简单,也最不推荐)。 停写 → 全量导出 → 按新规则重新导入 → 校验 → 切流量。整个过程可控,但停机时长等于数据量除以搬迁速度,亿级行通常以小时计,多数业务接受不了。
方案二:双写 + 影子迁移(主流)。 分四步:
- 双写开启:应用同时按新旧两套规则写入,写旧片保证在线业务不受影响,写新片为迁移做准备。同时开启增量同步——把双写开始之后旧片产生的变更,实时追到新片;
- 存量搬迁:分批把双写开始之前的历史数据按新规则搬到新片,每搬一批校验一批(行数、主键集合、关键字段校验和)。批次要小,避免长事务拖垮线上;
- 一致性校验:全量对比新旧两片的记录。常用做法是逐片按主键区间做校验和比对,不一致的行记录下来单独重搬;
- 灰度切读与停写旧片:先小流量读新片,观察一段时间无异常后全量切读,再停掉旧片写入,最后下线旧分片。
每一步都要能回滚:双写可关、同步可停、读流量可切回。整个方案的核心不是搬迁技术,而是每个阶段都有明确的验证手段与回退开关。
方案三:借道中间件。 ShardingSphere、Vitess 一类组件把路由、搬迁、校验封装成工具,能省掉大量自研工作。代价是引入一层依赖与它自身的运维复杂度。评审会上的判断标准:团队有没有能力自研并长期维护这套搬迁逻辑?没有的话,中间件是更理性的选择。
分片键选错了还能救吗
分片键是分库分表里最难改的决定——改键等于重做一次全量搬迁。若发现选错了(比如按 customer_id 分,但高频查询其实是按 merchant_id 查商家订单),有三条补救路径,代价递增:
- 异构索引表:另建一张映射表,记录 merchant_id 到分片位置的对应关系,查询先查映射表再定位分片。本质是空间换时间,写路径多一次插入;
- 冗余双写:同一份数据按两个分片键各写一份,两个查询维度都能本地命中。代价是存储翻倍、一致性维护复杂,只适合数据量可控的场景;
- 重选分片键整体搬迁:成本最高,但一劳永逸。通常借业务低峰期,走上面那套双写迁移流程。
复盘这类事故的结论往往很朴素:分片键的选择应该由查询分布统计说话。上线前把核心查询 SQL 全量捞一遍,统计每个查询维度的出现频次,占比最高的那个维度就是分片键的候选。凭经验拍脑袋选的键,八成会后悔。