6.4 高可用与负载均衡
6.4 高可用与负载均衡
本节摘要:高可用的目标不是"不出故障",而是"出故障时业务无感或分钟级恢复"。本节讲故障切换的三代方案演进、负载均衡的两种接入形态、以及容灾层级的思考框架。位置:第 6 章收官——把复制、拆分等组件编排成完整的可用性体系。
可用性是算出来的,更是演练出来的
先校准概念。可用性 99.95% 意味着全年停机不超过约 4.4 小时;99.99% 就是 53 分钟以内。但工程师很快会学到:故障不按年均匀分布——它专挑大促前夜、版本发布日、周五下班前出现。所以高可用的工程重点是两个数字:RTO(故障到恢复的时长)与RPO(最多丢多少数据)。复制方案的选型本质是给这两个数定价:异步复制 RPO 可能丢秒级数据、RTO 分钟级;半同步复制 RPO 趋近零但写入延迟上升。评审会要的答案不是"越高越好",而是"这个业务付得起哪个价"。
故障切换的三代方案
第一代:主从手工切换。 主库挂了,运维登上来执行 CHANGE MASTER 换主、应用改配置。RTO 以半小时计,适合内部系统。它的价值在于让团队理解切换的每一个动作——自动化方案的每一步都是对它的封装。
第二代:编排自动切换。 在主从之上加仲裁组件(如 MHA 类工具或云平台的托管高可用):持续探测主库心跳,判定故障后自动完成"从库提升为主、其他从库改挂新主、VIP 或 DNS 漂移"。RTO 压到分钟级内。要点是防脑裂——仲裁必须有多数派确认,避免网络分区时新旧主同时对外写入(那比宕机严重得多)。
第三代:组复制与云托管。 MySQL 官方的 MGR(Group Replication)基于 Paxos 协议多节点多数派提交,自动选主、自动故障转移,配合 MySQL Router 或 InnoDB Cluster 形成整套方案;云数据库的托管高可用则把这一切封装成"一个配置项"。取舍:MGR 要求多节点写入语义的适配、运维学习曲线陡;云托管把复杂度外包,但带来平台绑定。团队自运维能力强走 MGR,追求稳态效率走云托管,两者都比第二代省心。
负载均衡:流量怎么分
负载均衡解决"多个从库怎么分流量、写流量永远进主库"。两种形态:
| 维度 | 代理型(ProxySQL 等) | 客户端型(驱动或框架层路由) |
|---|---|---|
| 部署位置 | 独立中间层 | 应用进程内 |
| 故障转移 | 中间层统一处理 | 各应用实例各自处理 |
| 额外延迟 | 多一跳网络 | 无 |
| 运维心智 | 多一套组件要维护 | 逻辑散在应用配置里 |
| 典型场景 | 多语言多团队共享接入 | 单一技术栈的中小规模 |
选型口诀:多团队异构技术栈用代理型统一收口;单一栈追求低延迟用客户端型。无论哪种,都需配置健康检查(探活失败自动摘除)与读权重(从库规格不同则权重不同,避免小从库被打挂——6.2 留下的伏笔在此收口)。
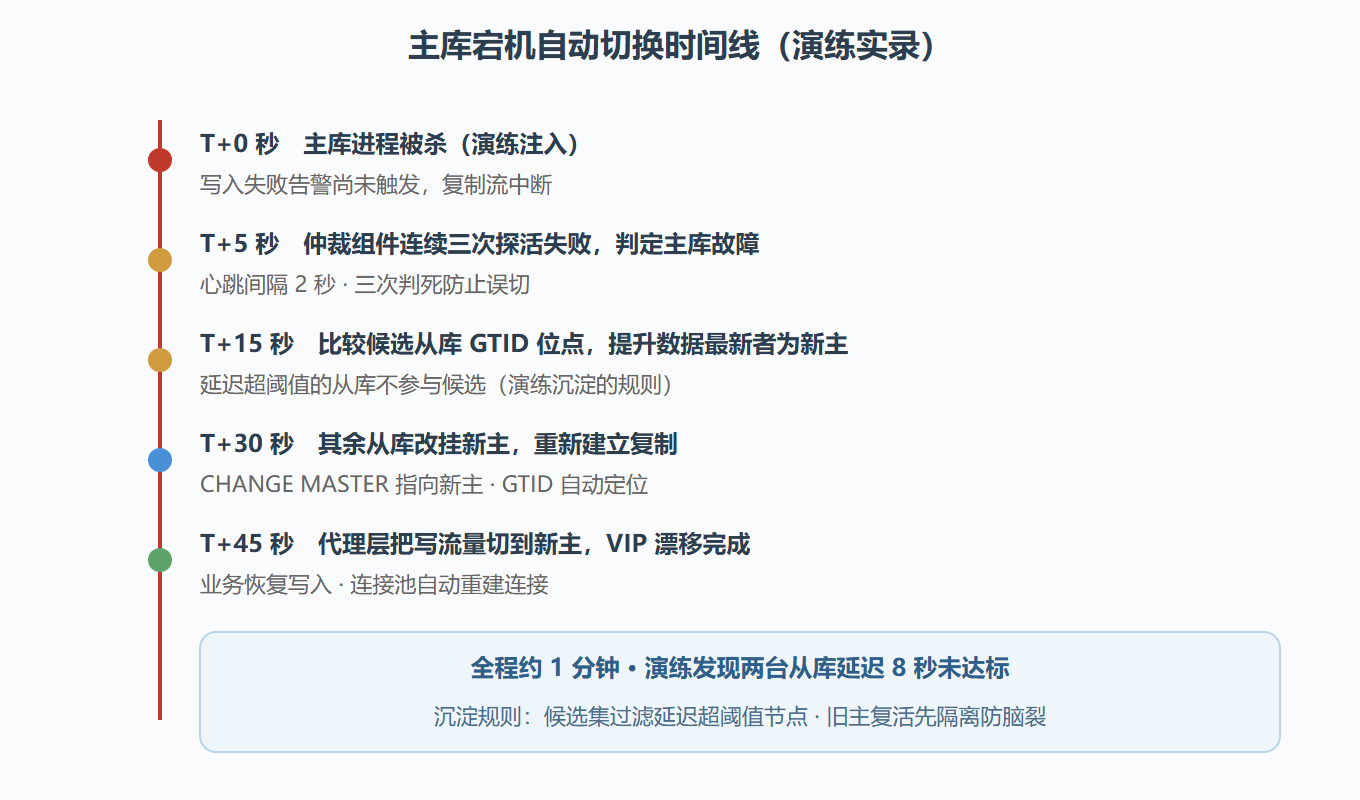
图 16 · 主库故障自动切换时间线
演练:一次主库宕机的切换复盘
背景:大促压测中人为 kill 掉主库进程,检验自动切换链路。时间线与动作:T+0 主库进程被杀;T+5 秒仲裁组件连续三次探活失败判定故障;T+15 秒选出数据最新的从库(比较 GTID 位点)执行提升;T+30 秒其余从库改挂新主;T+45 秒代理层把写流量路由到新主,VIP 漂移完成;业务恢复写入,全程约 1 分钟。检查清单逐项过:切换期间有无数据丢失(对比新旧主位点——丢失窗口等于复制延迟,这就是大促前要求延迟趋零的原因);有无脑裂(旧主复活后必须先隔离人工确认,防止双主写入);应用连接池是否自动重连。解读:演练暴露真问题——这次演练发现两台从库延迟 8 秒未达标,切换预案追加"延迟超阈值的从库不参与选主"规则。演练的价值就在这类规则的沉淀。变式:更严苛场景引入半同步复制,让选主候选集的数据零差异,代价是主库提交要等至少一个从库确认。
易错点与评审清单
- 高可用只有架构没有演练:切换脚本三年没跑过,真故障时连文档都是错的,演练要进常规排期;
- 仲裁组件单点:仲裁挂了等于高可用失效,仲裁本身要三节点部署;
- 连接池不设失败重连:切换完成后应用还攥着死连接重试,表象是"切换完业务仍超时",配置好连接池的连接校验与重建策略;
- 把容灾混同于高可用:同机房切换叫高可用,跨机房跨地域叫容灾,后者要考虑数据同步方式与专线成本,先想清楚业务需要哪一级。
要点回顾:用 RTO 与 RPO 给方案定价而不是空谈百分比;切换方案三代演进,防脑裂是底线;负载均衡代理型收口、客户端型低延迟;切换演练每季度至少一次,规则从演练里长出来。架构层到此齐备,第 7 章进入让这套体系长期健康运行的运维面。
一次主库故障切换的完整演练
高可用方案的价值,只有在真正切过一次之后才成立。下面是一套演练记录(以一主两从 + 自动切换组件为例)。
故障注入:在主库所在机器上制造网络分区,模拟主库不可达。观察三个时间点:检测耗时、决策耗时、切换后服务恢复耗时。三者相加就是实际的 RTO(恢复时间目标)。
切换动作的四个阶段:
- 确认主库真的挂了。这一步最容易被忽略也最容易出事——网络抖动导致的假死,若误判为主库故障而切换,会引发双写。做法是要求多个探测点(从库、独立监控节点、应用侧)在连续多个周期内一致判定主库不可用,才进入下一阶段;
- 选新主。标准不是"谁先响应",而是"谁的数据最全"。比较各从库的 binlog 位点,选出同步位点最新的那个。位点落后的从库被排除,即使它响应最快。若有从库延迟严重(Seconds_Behind_Master 很大),直接出局;
- 补数据。新主可能缺失原主已提交但尚未同步过来的少量事务。若原主可达(只是被隔离),尝试把这部分 binlog 抢救回来补到新主,这一步决定了 RPO(数据丢失量)是零还是秒级;
- 切流量与重建复制。把写流量指向新主,其余从库重新挂到新主下开始复制。原主恢复后,作为从库重新加入,且必须以只读方式加入,由人工确认后再决定要不要切回去。
演练中最常暴露的三个问题:
- 应用没有重连能力:连接池缓存了旧主地址,切换后应用持续报错直至重启。解法是连接层支持地址动态刷新,或前端用 VIP / 代理层屏蔽后端变化;
- 切换后自增主键冲突:新主的自增起点没有调开,原主恢复后产生重复 ID。解法是切换后显式设置自增步长与偏移量,或干脆用全局 ID 生成器,不依赖数据库自增;
- 没有演练过的脚本等于没有脚本:演练中不少团队的切换脚本是第一次真正执行,参数错误、权限不足、依赖命令缺失等问题集中爆发。
演练收尾要留下的三件东西:一次完整的耗时记录(各阶段 RTO 明细)、一份问题清单与修复排期、以及下一次演练的时间。高可用的成熟度不取决于方案文档写得多漂亮,而取决于演练次数与最近一次演练距今多久。
容量层面的另一半是负载均衡:读流量按权重分配,权重依据从库规格设定;从库健康检查失败即自动摘除,恢复后先小流量预热再全量加回——预热的目的是让缓冲池重新加载热数据,避免刚加回就被打垮。