7.2 性能监控与参数调优
7.2 性能监控与参数调优
本节摘要:监控回答"现在健康吗",调优回答"还能更快吗",两者共用同一套指标语言。本节建立连接、吞吐、缓冲池、复制、锁五层监控体系,再按机理解释核心参数的调法——重点是让参数调优从"抄配置"变成"算资源"。位置:运维三本账的效益账,第 5 章查询优化的全库级延伸。
监控体系:五层指标与阈值
抄来的监控大盘之所以没用,是因为指标之间没有层次。健康的监控按"从外到内"分五层,每层回答一个问题:
连接层——"进得来吗":Threads_connected、Threads_running、连接等待错误数。阈值经验:连接数常驻超 max_connections 的 80% 告警;Threads_running 长期大于 CPU 核数的两倍说明并发压力已在排队。
吞吐层——"干得动吗":QPS、TPS、慢查询条数(接第 5 章慢日志)。趋势比绝对值重要:环比突增 50% 要么是业务放量要么是慢查询爆发,两者处置完全不同。
缓冲池层——"命中高吗":缓冲池命中率(健康线 99% 以上)、脏页比例、刷脏速率。命中率掉到 95% 以下,说明工作集超出内存,要么加内存要么检查有没有全表扫把热数据挤出去了。
复制层——"跟得上吗":主从延迟(6.2 讲过用位点差校验)、IO 与 SQL 线程状态。延迟告警分级:5 秒警告、30 秒严重,读写分离业务的用户体验直接挂钩。
锁层——"卡住了吗":锁等待次数与时长、死锁频率。锁等待秒级增长的实例通常伴随长事务,去 information_schema 的 innodb_trx 抓现行。
图 13 · 监控指标分层与告警联动
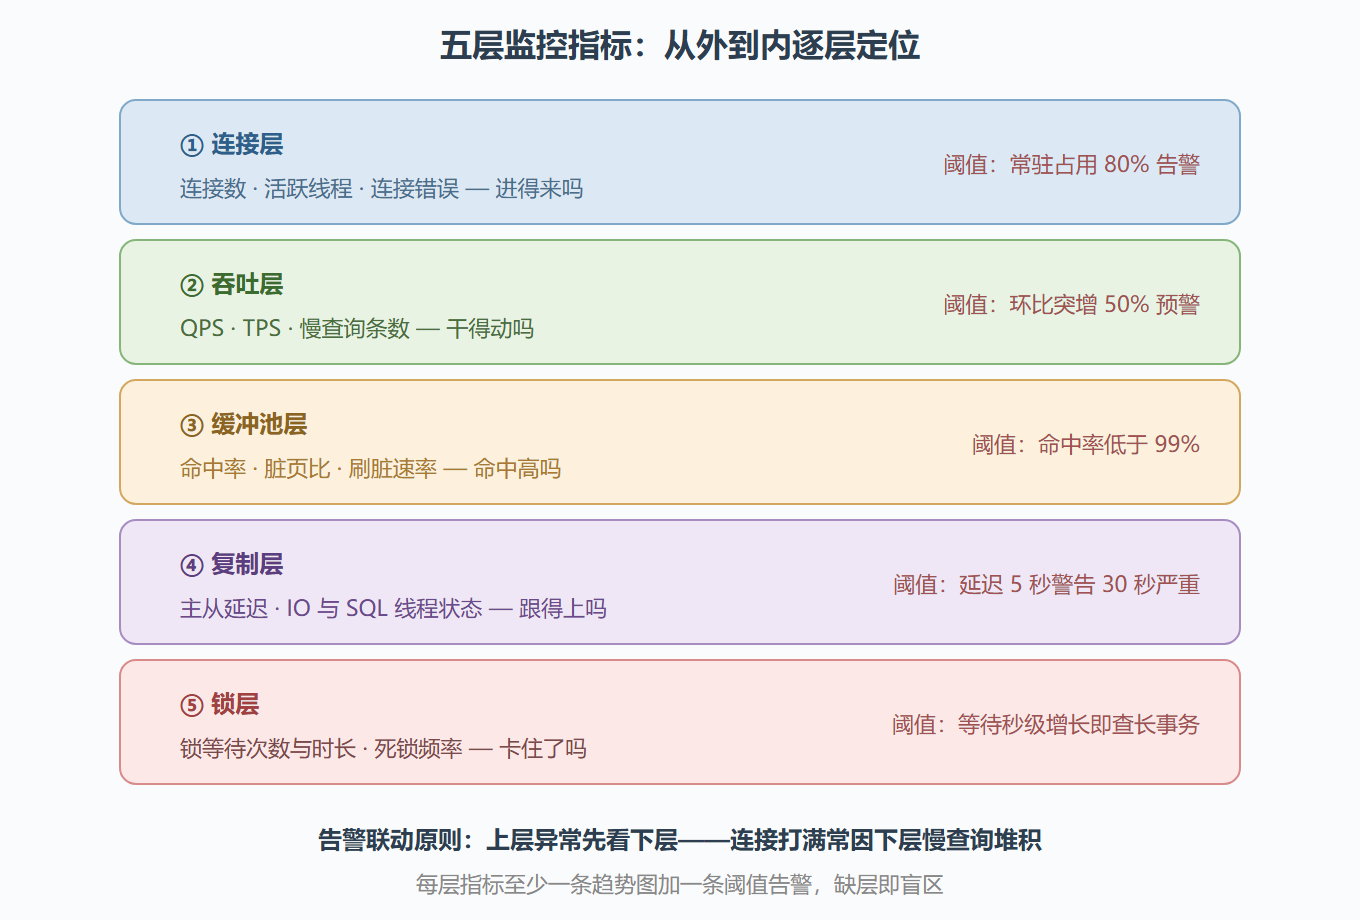
告警联动有个经验法则:上层异常先看下层。连接打满十有八九是慢查询堆积(每条查询占着连接不撒手),此时扩连接数是治标伤本——连接数上限调高只是让更多慢查询一起进来把 CPU 也拖死。
参数调优:按机理算资源
参数调优的第一课是放弃"抄一份大厂配置"。参数的最优值是硬件规格、数据规模、业务负载的函数,别人家的答案解不了你的题。三个最重要的参数逐个说机理。
innodb_buffer_pool_size:数据与索引的内存缓存,InnoDB 性能的第一变量。调法不是拍脑袋,是算工作集:数据总量减去冷数据(归档表、日志表),剩下就是要进 buffer pool 的量,给它留够,再加 20% 余量,且不超过物理内存的 60% 到 70%(给连接内存与系统留空间)。验证靠命中率——调完观察缓冲池命中率是否稳在 99% 以上,掉了就继续加内存或减工作集。
innodb_flush_log_at_trx_commit 与 sync_binlog:著名的"双一配置"。前者控制 redo 刷盘时机(1 表示每次提交刷盘),后者控制 binlog 刷盘(1 表示每次提交刷文件系统)。双双为 1 是最安全档:崩溃最多丢一条事务边界内的数据,代价是每次提交两次 IO。金融与交易系统守双一;内容类站点可接受前者设 2(每秒刷盘,宕机可能丢一秒)换吞吐。评审会标准句式:丢一秒数据在业务上值多少吞吐,让业务方回答。
innodb_io_capacity 与刷脏:告诉 InnoDB 你的磁盘能吃多少 IO(SSD 通常 2000 到 10000)。设低了刷脏不及时、脏页堆积触发猛烈刷盘造成性能锯齿;设高了抢业务 IO。调法是压测观察刷脏曲线平滑度。
演练:一次有据可依的调优
背景:新上线的 64GB 内存实例,默认 buffer pool 只有 128MB,高峰命中率 92%,磁盘 IO 飙高。操作与核算:业务数据 80GB,其中归档表 30GB 常年不查,工作集约 50GB;预留 30% 给连接与系统,可分配约 45GB,设 innodb_buffer_pool_size = 45G(8.0 支持在线调整,不用重启)。结果:命中率三天内爬升到 99.7%,磁盘读 IO 降 80%,高峰 CPU 下降 15 个百分点。解读:这次调优全程没有"经验值 70%"之外的玄学——每一步都是工作集核算加效果验证。变式:如果命中率到 99% 但吞吐仍不达标,别再盯着 buffer pool,回到第 5 章看慢查询排行——内存救不了烂 SQL。
易错点与评审清单
- 一次改一串参数:调优要单变量推进,改一批参数出效果根本无法归因,还可能互相抵消;
- 忽视连接级 buffer 参数:sort_buffer_size、join_buffer_size 是每连接分配,设 64MB 乘 500 连接就是 32GB,这类参数要保守;
- 监控只装不配阈值:有曲线没告警等于人肉盯屏,阈值要分层分级并定期校准(业务量涨了老阈值天天误报,大家就会习惯性忽略);
- 调优不做基线记录:改前改后的关键指标截图存档,否则下次调优连历史依据都找不到。
要点回顾:五层监控从外到内,上层异常先查下层;buffer pool 按工作集算不是按比例抄;双一配置的取舍让业务方报价;单变量推进、基线留痕、效果验证三步缺一不可。效益账记完,最后一本账是安全账——权限、审计与故障排除。
从指标到参数的映射清单
监控给出的是现象(缓冲池命中率低、锁等待高、临时磁盘表多),调优要回答的是"改哪个参数、改成多少、改完怎么验证"。下面这张映射表是评审会上常用的速查口径。
| 观测到的现象 | 可能原因 | 涉及参数 / 动作 | 验证方式 |
|---|---|---|---|
| 缓冲池命中率长期低于 99% | 热数据装不下 | innodb_buffer_pool_size(物理内存的 50%~70%,与同机其他服务协商) | 观察命中率与磁盘读 IOPS |
| 写入卡顿时而出现 | 刷脏跟不上 | innodb_io_capacity(按磁盘实际 IOPS 设定)、innodb_flush_neighbors | 观察 checkpoint age 与脏页比例 |
| 大量磁盘临时表 | 排序/分组内存不足 | sort_buffer_size、join_buffer_size、tmp_table_size(按连接数核算总内存) | Slow log 中 Created_tmp_disk_tables |
| 连接数打满 | 连接池配置或慢查询堆积 | max_connections(治标)、排查慢 SQL 与连接未释放(治本) | Threads_connected 与连接来源分布 |
| 死锁告警频繁 | 事务内加锁顺序不一致 | 非参数问题,改业务加锁顺序与事务粒度 | 锁监控中的死锁日志 |
| binlog 写盘成为瓶颈 | 每次提交都刷盘 | sync_binlog 与 innodb_flush_log_at_trx_commit 的组合权衡 | 观察写入 TPS 与 fsync 耗时 |
参数调整的通用原则(比具体数值更重要):
- 一次只改一个参数。同时改三个,变好了不知道是谁的功劳,变差了不知道该回滚哪个;
- 先算内存账。凡是 *_buffer_size 这类"每连接分配"的参数,总占用约等于参数值乘以最大连接数。把 sort_buffer_size 从 2MB 调到 8MB,在 500 个连接下意味着多占 3GB——这是把实例拖向 OOM 的经典操作;
- 区分全局与会话。临时验证可以在会话级设置,确认有效后再写进配置文件,避免一上来就全局生效;
- 留基线。改之前记录关键指标(QPS、响应时间 P95、命中率),改之后在同样的业务时段对比,否则无法判断效果。
找瓶颈的现成工具:sys schema 与 performance_schema。 前者把后者的原始数据整理成人能读懂的视图,比如按总耗时排序的语句统计、未使用索引的清单、全表扫描语句清单。日常巡检从这三张视图开始,通常几分钟就能定位到第一优先级的优化对象。
调优的终点不是把参数调到"最优值"——脱离业务负载谈最优没有意义。真正可持续的做法是:留一套基线、建几条告警、让每一次变更都可回滚、可对比。