7.3 权限审计与故障排除
7.3 权限审计与故障排除
本节摘要:安全账的两页:权限与审计决定"谁能碰生产、碰了留不留痕",故障排除决定"出事时多快止血"。本节给出权限收敛的落地步骤、审计日志的开启方法,以及四类高频故障的排查决策树。位置:全册收束,前三十三章的防与治在这里合成闭环。
权限收敛:一次落地的完整清单
3.3 节讲过最小授权的原则,本节讲它在存量系统里怎么落。现实是:多数系统的权限是历史累积的——离职员工账号还在、废弃服务的账号还能写库、某次排障临时开的全库权限忘了收。收敛四步走:
第一步,摸底。列出全部账号及其权限与来源网段:SELECT user, host FROM mysql.user; 逐个 SHOW GRANTS,导成台账。第二步,分类:应用账号、只读分析账号、运维账号、临时账号四类,台账上每个账号标注负责人与用途,对不上号的直接进回收清单。第三步,收敛:回收孤儿账号、把 root 从应用配置里清除(应用改专用账号)、临时权限在工单里设定过期时间。第四步,固化:权限变更走工单双人复核,台账随变更更新,每季度复审一次。
审计日志是权限体系的摄像机。8.0 企业版有官方审计插件,社区常用方案是开启 general_log 抽样或用中间件记录——关键是覆盖高危操作(DDL、DELETE、TRUNCATE、授权变更),记录操作人、时间、语句、来源 IP。审计日志要异地存储且运维不可改——能被改的审计等于没审。
故障排除:四类高频场景的决策树
图 14 · 故障排查决策树:四类高频场景
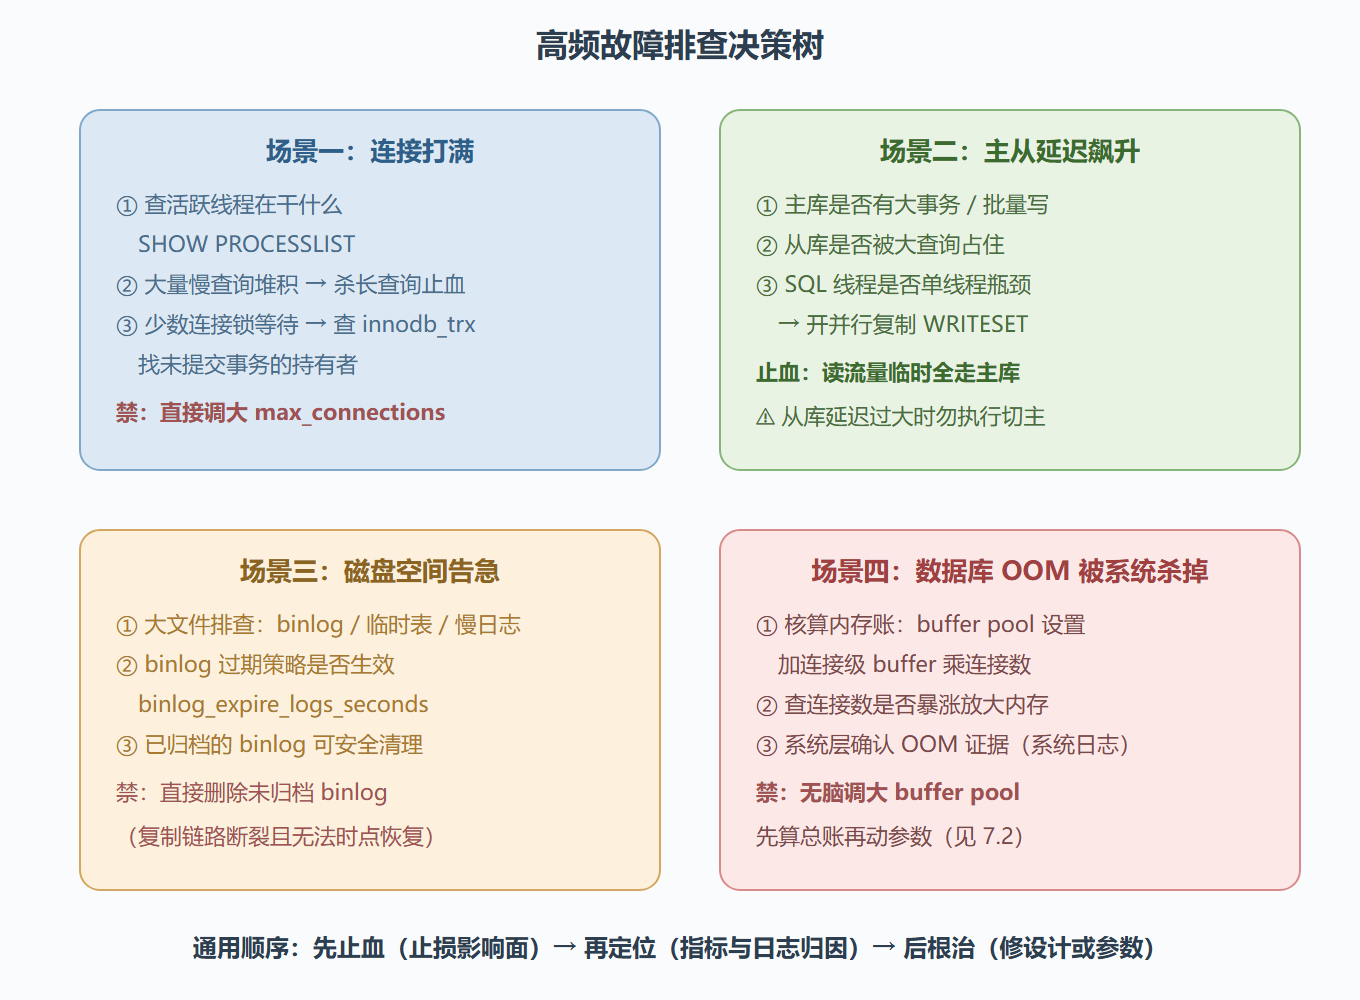
决策树之外,故障处理的第一动作永远是通知与留痕:故障群里同步现象与预期影响,操作命令逐条记录——没有留痕的止血动作会让事后复盘变成互相猜疑。止血与根治的边界也要清楚:杀查询、切流量、降级是止血;改索引、调参数、改代码是根治。止血动作可以激进,根治动作必须走评审。
演练:一次"连接打满"的完整处置
背景:周四下午告警——应用大面积报"获取连接超时"。操作按决策树走:
-- ① 看连接都在干什么 SHOW PROCESSLIST; -- 输出大量 Time 在 40 秒以上的 SELECT ... WHERE status = 2 ORDER BY ... -- ② 确认元凶:这些语句的执行计划 EXPLAIN SELECT ... ; -- type: ALL,全表扫描(新版本发布漏了索引迁移)
止血:批量终止超时查询,应用侧熔断降级该接口,连接池陆续释放,三分钟内恢复。定位:确认该语句是本次发布新增,新库表环境漏建了第 4 章设计的那条复合索引。根治:补索引(低峰执行),并把"发布检查单"加上"SQL 上线前 EXPLAIN 巡检"一条。复盘的关键发现:连接超时的表象之下是慢查询堆积——连接数是果不是因。按果调参(调大连接数)只会让更多慢查询进场,把 CPU 也拖死;按因处置才是运维的专业性所在。变式:若 SHOW PROCESSLIST 显示的是大量 Sleep 连接,方向完全不同——查应用连接池配置(最大连接数、空闲回收),那是应用侧的账。
易错点与评审清单
- 止血后不复盘:故障闭环的最后一环是复盘文档——时间线、根因、改进项、负责人、期限,缺项的复盘等于没做;
- 审计日志与业务日志混存:审计要防篡改,存储与权限必须独立;
- 故障预案只存在于个人经验里:处置手册进团队知识库,决策树按真实故障持续修订;
- 权限收敛一刀切引发布障:回收账号前先确认调用方,凌晨账号下线引发的应用故障比权限风险本身还难看。
要点回顾:权限收敛四步——摸底、分类、收敛、固化;审计覆盖高危操作且异地防改;四类故障各有决策树,通用顺序是止血、定位、根治;连接打满先查慢查询,磁盘告急先护 binlog;复盘文档是故障处理真正的交付物。全册三十三章至此走完——从建表评审会的第一张 ER 图,到最后一份故障复盘,愿你下次评审会上既能建好表,也能守住库。
最小权限清单与一次越权复盘
权限管理的第一原则是最小权限:给刚好够用的权限,不多给一分。落到 MySQL 的粒度上,典型清单如下。
-- 应用账号:只对业务库有 DML,不给 DDL、不给 DROP CREATE USER 'app_order'@'10.20.%' IDENTIFIED BY '***'; GRANT SELECT, INSERT, UPDATE, DELETE ON db_order.* TO 'app_order'@'10.20.%'; -- 只读账号:给报表与分析用,限制来源网段 CREATE USER 'rpt_reader'@'10.30.%' IDENTIFIED BY '***'; GRANT SELECT ON db_order.* TO 'rpt_reader'@'10.30.%'; -- 运维个人账号:按需临时提权,操作完回收,杜绝共用高权限账号 GRANT SELECT, PROCESS, REPLICATION CLIENT ON *.* TO 'ops_zhang'@'10.10.%';
三条硬规则:应用账号不给 DDL(表结构变更走审核流程,由专用变更账号执行);账号限定来源网段('%' 意味着任何地方都能连,等于没有网络层防护);禁止共用账号(共用账号出了事无法定位到人,审计形同虚设)。
一起真实越权复盘:某业务库中订单金额被批量修改,审计日志无法定位操作者,因为应用与人工操作共用一个高权限账号。事后整改分三步——拆分账号(应用账号、运维个人账号、临时变更账号)、开启审计插件记录全量语句与来源 IP、把 DDL 权限收归变更系统。整改后出现同类问题,五分钟内就定位到了具体语句与来源。
故障排查三板斧
数据库"变慢"是一大类模糊告警,排查要按固定顺序收敛。
第一斧:看进程。 当前在跑什么、卡在哪。
SELECT id, user, host, db, command, time, state, LEFT(info, 80) AS sql_text FROM information_schema.processlist WHERE command != 'Sleep' AND time > 3 ORDER BY time DESC LIMIT 20;
看三样东西:time 很大的语句(跑得久的)、state 集中在某个值(比如大量 Sending data 说明在扫数据、大量 Waiting for lock 说明在等锁)、以及 info 里是否出现 DDL(表结构变更会阻塞同名表的读写)。
第二斧:看锁。 谁持锁、谁在等。
SELECT waiting_pid, waiting_query, blocking_pid, blocking_query FROM sys.innodb_lock_waits;
锁等待的表现是"平时很快的语句突然全慢",与索引缺失导致的慢在现象上明显不同——后者是稳定慢,前者是突然慢。
第三斧:看资源。 CPU、IO、连接数、复制延迟。CPU 打满多半是烂 SQL 或并发失控;IO 打满多半是大查询刷盘或刷脏;连接数打满要先区分是真的需要那么多连接,还是连接没被正确释放。
三板斧之外,有一条常被忽略的经验:先看变更再看系统。绝大多数突发故障的诱因是最近一次变更——上线、改参数、跑批量、加索引。"最后一次改动是什么"这个问题,往往比任何监控图表都更接近真相。因此变更留痕要与监控同等重视:什么时间、谁、改了什么、回滚方式是什么。这四行记录,能把平均排查时间压缩一大半。