1.2 文本预处理与特征工程
1.2 文本预处理与特征工程
本节摘要:文本预处理是把原始脏文本变成模型可用输入的工序,包括清洗、分词(含子词切分 BPE、WordPiece、SentencePiece)、停用词过滤、词干提取与词形还原;特征工程则把文本转成数值向量,分稀疏表示(词袋、TF-IDF、N元组)与稠密表示(词向量)两路。本节从一个被脏数据拖垮的分类器讲起,给出每道工序的取舍标准和踩坑清单。
本节目标
阅读完本节,你应当能够:
- 设计一条面向客服语料的清洗流水线,说明每道工序过滤什么、可能误伤什么;
- 解释子词切分为什么能同时缓解未登录词和词表爆炸两个问题;
- 区分词干提取与词形还原,并说明"别删停用词里的否定词"这类工程细节的依据;
- 用 TF-IDF 的中文表述解释一个词为何"在本文档高频、全语料低频才算重要";
- 为小数据任务和高语义任务分别选择合适的表示方法。
一、被脏数据拖垮的分类器
一个真实教训。某团队做客服工单自动分类,模型练了两周,测试集准确率死活卡在七成出头。排查最后发现问题不在模型:训练语料直接抓自网页工单,里面混着大量超链接、"【满意请五星好评】"的模板尾巴、表情符号,甚至客服系统的自动签名档。模型花了大量容量去学这些与业务无关的噪声。清洗掉这三类垃圾再训练,同一套模型,准确率直接上到八成五。
这就是预处理的意义。它不产出"智能",却决定智能的上限。模型读到的一手文本远比想象的脏:网页残留的超文本标签、用户随手敲的错别字、"hhhhhhh"式的笑声、全角半角混排的标点、聊天里粘进来的表情图。预处理就像自来水厂的格栅与沉淀池——第一道工序不够好,后面的净化工艺再先进也是在过滤泥汤。
预处理和特征工程合起来回答一个问题:怎么把"一句话"变成"一串数字"。这道转换的设计,比多数人预想的更影响最终效果。
二、清洗:滤掉泥沙,别滤掉语义
清洗的第一原则是:每一道过滤都要问"它会不会误伤"。常见的清洗动作和它们的隐患如下表。
| 清洗动作 | 处理对象 | 潜在误伤 |
|---|---|---|
| 去除网页标签与链接 | 抓取语料中的标记残留 | 无明显风险 |
| 表情符号转文字 | 聊天表情、颜文字 | 情感任务里表情恰是强信号,转译而非删除 |
| 大小写统一 | 英文混杂语料 | 命名实体识别中大小写是线索,"Apple"与"apple"可能需要区分 |
| 错别字纠正 | 拼写错误 | 纠错器改错方向可能引入新错,需谨慎评估 |
| 数字与符号归一化 | 订单号、金额、时间 | 转成占位符保留结构,如统一替换为数字占位,而非删掉 |
注意最后一条的取向:对客服语料,订单号"12345"本身没有语义价值,但"出现了一个订单号"这个结构信息很有价值——所以做法通常是替换为占位符,而不是一删了之。同样的逻辑适用于问号感叹号:删掉标点会抹掉情绪强度线索,情感分析任务里这些恰恰是特征。
三、切分:从词到子词
清洗完,文本要切成模型操作的基本单元。英文有空格天然分词,中文则需要词典和统计模型帮忙,"我想查快递"要切成"我/想/查/快递"。但现代 NLP 的主流已经从"词级"走向"子词级":把词拆成更小的片段。
为什么?两个压力。一是未登录词:新品牌、拼写错误、生造词,词表里没有,词级切分直接抓瞎。二是词表爆炸:词级词表动辄几十万,向量存储和计算都吃紧。子词切分两头解:高频词保持完整,低频词拆成碎片拼装。"查订葱"里"葱"是错字,词级处理无从下手;子词级把"订"和近似片段拼起来,仍能保留大部分语义信息。
三种主流子词算法值得一提。字节对编码从字符出发,每次合并语料中最频繁的相邻对,逐步长出常见词;词片算法是它在 BERT 系模型里的变体;句元Piece则把切分完全当作无监督统计问题,对中文、日文这类无空格语言更友好。三者细节不同,思想一致:切分频率由数据决定,常见保留整体、罕见拆成零件。
💡 关键直觉:子词切分像图书馆的编目策略——畅销书整本入库(高频词保留),冷门书按章节拆存(低频词拆碎),新书来了总能找到位置(未登录词可拼装)。
四、停用词、词干与词形:删什么、留什么
切分之后还有两道经典工序,各自暗藏取舍。
停用词过滤删掉"的、是、了、在"这类高频虚词,压缩维度、突出实词。但要小心两类词。第一类是否定词:"不好用"删掉"不",情感 polarity 直接反转——做情感分析时,否定词必须保留。第二类是疑问词:客服场景里"怎么""为什么"往往是意图的核心信号,删掉它们,"怎么退货"和"退货失败"就难以区分了。实用原则:停用词表要按任务裁剪,不要整表照抄。
词干提取与词形还原都为了合并同一词的不同形态,但路线迥异。词干提取是机械截断:把 running、runs、ran 一律削到 run 一类的词干,速度快,但会削出无意义的碎片——经典错例是把 better 削成 bet 一类的残根,把 friendly 削得面目全非。词形还原查词典、看词性,把 better 还原成 good,把 ran 还原成 run,准确得多,代价是依赖词典资源、速度慢。中文几乎没有屈折变化,这两道工序主要服务英文或多语言混合语料;中文对应的问题是"客服/客户服务/客户支持"这类同义归并,靠的是同义词典或后面讲的词向量。
| 工序 | 机制 | 速度 | 准确性 | 中文场景需求 |
|---|---|---|---|---|
| 词干提取 | 规则截断词缀 | 快 | 会产出残根 | 基本不需要 |
| 词形还原 | 词典加词性 | 慢 | 还原到字典形式 | 基本不需要 |
| 同义归并 | 同义词典或词向量 | 中 | 依赖词典质量 | 高频需求 |
五、稀疏表示:数数也有讲究
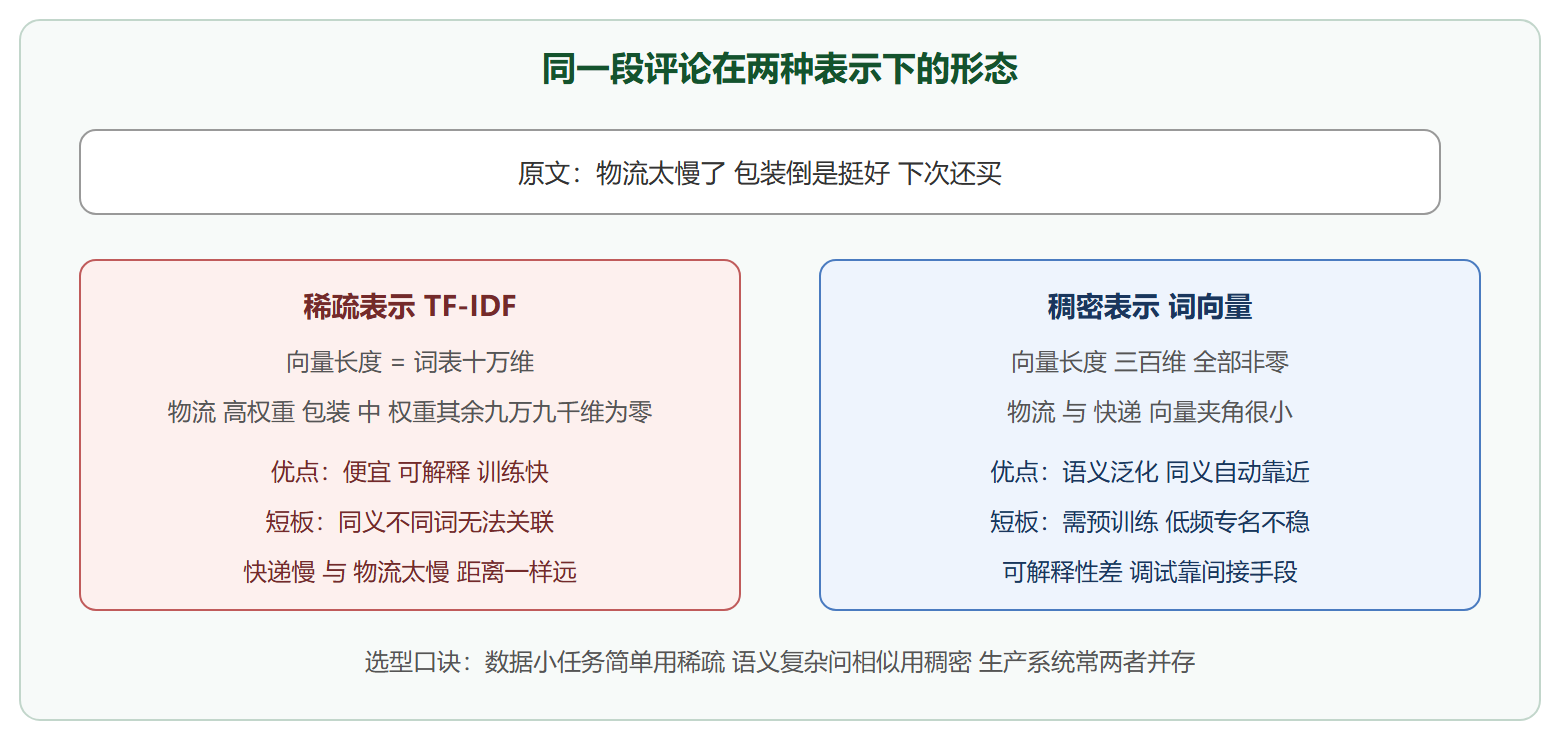
切好的词元要变成向量。第一路是稀疏表示,向量长度等于词表大小,绝大多数位置为零。
词袋模型最简单:数每个词出现几次(或是否出现),完全丢弃词序。"我退货失败了"和"失败了我退货"向量完全相同。它的短板由此而来——词序信息没了,"不发货"和"发货不"这类靠语序区分的语义无法保留;维度高且稀疏,词汇表一大就难处理。
N元组是对词袋的直接修补:把相邻两三个词捆成单元再计数,"退货运费""物流很慢"这类短语特征得以保留。代价是组合爆炸——单元数量随 N 指数增长,实战很少超过三元。
**词频与逆文档频率(TF-IDF)**在计数上加权,回答"什么词才算重要"。它的逻辑用一句话讲:一个词在某文档里出现得多,同时在整个语料里出现得少,它对这篇文档才重要。查询意图里的"催""投诉",在一篇工单里高频、在语料整体低频,权重就高;而"的""是"到处都有,逆文档频率趋近于零,权重被压下去。TF-IDF 至今仍是检索、关键词提取的主力,便宜、可解释、难打败。
稀疏与稠密表示对比
预处理流水线的顺序本身就是一层知识:清洗在前、切分居中、表征在后,乱序就会出事故——先做词向量再清洗,脏词的向量会污染整片语义空间;先去停用词再做命名实体识别,「新华」这类实体开头词可能已被误删。另一个容易忽视的点是预处理要跟着任务走:情感分析里「不」字是关键否定词,绝不能当停用词去掉;而主题模型里它确实贡献寥寥。不存在全局最优的预处理配置,只存在与下游任务匹配的配置——把这条纪律写进项目文档,能省掉后来者无数「为什么这里删了这个词」的考古时间。
六、稠密表示与特征工程的合流
第二路是稠密表示:把词映射到几百维的低维连续向量,语义相近则向量相近,"物流"和"快递"自然靠拢。这条路彻底改变了特征工程的角色——过去工程师手工设计"是否含否定词""感叹号数量""句长"这类特征,现在大部分语义特征可以由词向量自动携带。第1.3节将专门讲词向量怎么训练出来。
但手工特征没有被淘汰,它在三个位置继续发光。一是可解释性要求高的场合:给业务方解释"分类依据是订单号缺失和连续追问次数",比解释一串向量数值容易得多。二是长文本统计特征:文档长度、可读性指标、实体密度,词向量不直接提供。三是领域信号:客服场景的"用户重复提问次数""是否提及金额",是任何通用表示都不懂的私有知识。
⚠️ 常见坑:把预训练模型当免洗金牌,语料不清洗直接喂。垃圾进、垃圾出在深度学习时代一样成立,而且更隐蔽——模型会把噪声模式一并学进去,测试集上还看不出来,上线遇到真实分布才崩。清洗这道工序,模型越强越不能省。
另一个高频错误是"预处理一刀切"。同一个系统里,情感分析需要保留否定词与标点,命名实体识别需要保留大小写与数字,检索需要保留同义扩展。正确做法是把预处理做成可配置的流水线,按下游任务开关各道工序,而不是全局一份配置。
一节小结
- 预处理决定上限:清洗、切分做得好不好,直接决定后续模型能到什么水平,模型再强也救不回喂进泥汤的语料;
- 子词切分(字节对编码、词片、句元Piece)同时缓解未登录词和词表爆炸,是现代 NLP 的默认选择;
- 停用词不能整表照删:否定词反转情感、疑问词承载意图,停用词表必须按任务裁剪;
- 词干提取与词形还原分别走机械截断和词典还原两条路,中文的核心问题换成同义归并;
- TF-IDF 的核心逻辑:词在单文档高频、全语料低频才算重要,至今是检索与关键词提取的主力;
- 稀疏与稠密并存:小数据简单任务用稀疏,语义相似任务用稠密,手工特征在可解释性与领域信号上仍不可替代。
下一节我们打开稠密表示的黑箱:词向量是怎么从大量文本中"学"出语义的,深度学习模型又为什么需要它。