1.3 词向量与深度学习基础
1.3 词向量与深度学习基础
本节摘要:词向量把离散词语映射到低维连续向量空间,使语义相近的词距离相近,其训练基础是分布式假设(一个词的意义由上下文决定),代表方法有 Word2Vec(CBOW 与 Skip-gram)、GloVe、FastText;深度学习模型则负责处理词向量构成的序列,从前馈网络的局限讲到循环神经网络的梯度消失,再到长短期记忆网络的门控设计与注意力机制。本节从"搜索引擎搜不到同义说法"的老问题切入,把这两块基石讲透。
你能学到什么
阅读完本节,你应当能够:
- 解释独热编码的三大缺陷(维度灾难、语义鸿沟、数据稀疏)以及词向量如何逐一化解;
- 区分 CBOW 与 Skip-gram 的预测方向,说明各自适合的数据规模与词频特点;
- 说出 FastText 用字符片段技巧解决未登录词问题的原理;
- 用因果链解释:RNN 为何梯度消失、LSTM 的三个门如何救场、注意力机制为什么更进一步;
- 判断一个任务该用前馈、循环还是卷积结构。
一、搜不到的"同义词"
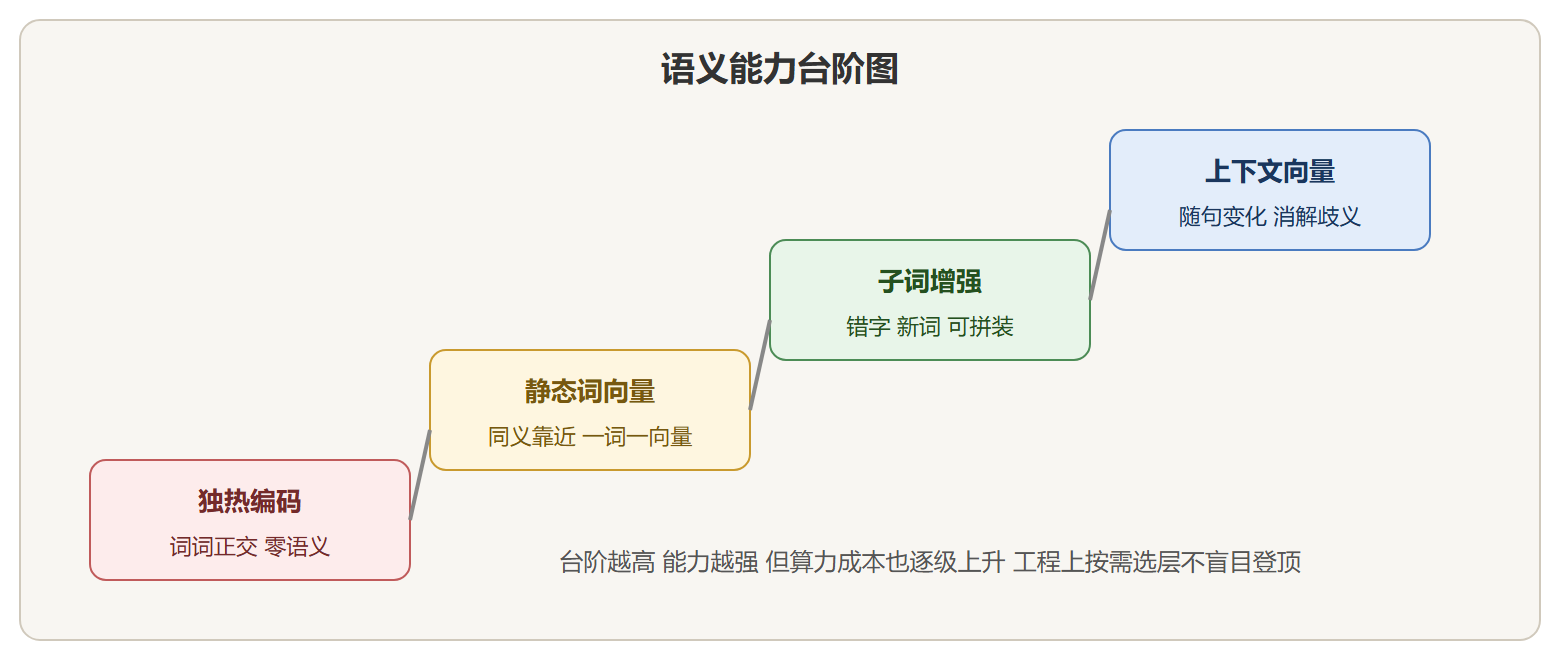
搜索引擎时代的老问题:用户搜"手机开不了机",知识库里那篇文档标题写的是"设备无法启动",全文没出现"开不了机"这五个字。精确匹配扑空,用户得到的是一堆不相关结果。根子在表示方法:独热编码下,每个词是词表长度的一维向量,只有自己那个位置是一,其余全零。任意两个词的向量都互相垂直——"手机"和"设备"、"开不了机"和"无法启动",在数学上毫无关系。这就是语义鸿沟:语言里近义的词,在表示空间里距离一样远。
独热编码还有两个毛病。维度灾难:词表十万,向量就十万维,存储和计算都吃不消。数据稀疏:向量里九成九以上是零,白白占地方。
词向量的解法是一次视角转换:不再问"这个词是哪一个",改问"这个词周围常出现什么"。语言学上这叫分布式假设——一个词的意义由它的上下文决定。"开不了机"周围总是围着"手机、黑屏、充电","无法启动"周围也总是围着"设备、黑屏、充电",两堆上下文高度重叠,学出来的向量自然靠近。语义相似度,第一次变成了可以计算的几何距离。
更妙的是,词向量空间还能做语义运算。经典例子:国王的向量减去男人的向量加上女人的向量,结果落在女王附近。性别、品类这类抽象关系,竟被编码进了向量方向。工程上这意味着"退货运费"和"运费险理赔"的距离可以量化,为第2章的语义匹配铺了路。
二、三代的训练法:从局部预测到全局统计再到字符拼装
Word2Vec 是第一代代表,两种训练模式方向相反。连续词袋(CBOW)用上下文预测中心词:把前后几个词的向量平均,去猜中间那个词。跳字(Skip-gram)反过来,用中心词预测周围的词。方向之差带来特性之差:CBOW 一次预测一个目标,训练快,适合大语料;Skip-gram 每个词要预测多个上下文,对低频词的刻画更充分——客服场景里恰恰充满低频但关键的说法("闪退""跳屏"),这正是 Skip-gram 在这类语料上常胜出的原因。
GloVe 换了条路:先统计全语料的词共现矩阵——每两个词在多大窗口内共同出现过多少次,然后让词向量的点积去拟合共现频率的对数。Word2Vec 学的是局部窗口的预测,GloVe 学的是全局的统计规律。两者在多数任务上表现相当,GloVe 在大语料、主题稳定性上略有优势,Word2Vec 在小语料、新领域适应上更灵活。
FastText 在 Word2Vec 上加了一层字符片段:每个词除了整体向量,还拆成一串字符片段各自有向量,词向量是片段向量的和。妙处立刻显现——训练集里没见过的词(未登录词),只要它的字符片段见过,就能拼出一个像样的向量。用户把"登录"打成"登陆",词级模型直接失效,FastText 靠片段重叠仍能算出两者相近。客服场景错别字成灾,这个特性几乎是刚需。
| 方法 | 训练信号 | 低频词表现 | 未登录词 | 典型场景 |
|---|---|---|---|---|
| Word2Vec CBOW | 上下文预测中心词 | 一般 | 不能 | 大语料快速训练 |
| Word2Vec Skip-gram | 中心词预测上下文 | 较好 | 不能 | 客服等低频关键术语多 |
| GloVe | 全局共现统计 | 中等 | 不能 | 大规模静态语料 |
| FastText | 子词片段加上下文 | 好 | 能拼装 | 错别字多、新词多 |
这一代词向量的共同局限是"一词一向量":静态。可语言里"苹果"在"吃苹果"和"苹果发布会"里明明是两个意思,静态向量只能给一个折中的位置。解决它的是上下文词向量——同一个词在不同句子里动态计算不同向量,BERT 系模型是这一代代表。它们的具体机制超出本节范围,但你要知道分水岭在哪:静态向量解决"词与词像不像",上下文向量解决"这个词在这里是什么意思"。
从独热到上下文向量:四代表示的能力边界
三、序列的难题:前馈网络为何不够用
有了词向量,还要有模型去处理"一句话"这个序列。先看最朴素的方案:把句子里所有词向量平均成一个向量,喂给前馈神经网络(信息从输入层单向流到输出层,不回头)分类。这个方案便宜得惊人,在短文本意图粗分类上居然够用——但它的天花板也很明显:平均操作抹掉了词序,"发货不成功"和"不发货成功"被平均成同一个向量,语义却相反。
前馈网络的根本局限在于"无记忆":它假设输入之间彼此独立,而句子里第几个词说了什么、前面提到过什么,它一概不知。要理解序列,模型需要携带状态的"滚动记忆"。
四、循环、门控与注意力:三层递进的解法
**循环神经网络(RNN)**引入了滚动状态:处理每个词时,网络不仅看当前输入,还接收上一步的隐藏状态,输出新的隐藏状态传给下一步——像一条传送带,句子的前文信息顺着状态一路传到末尾。序列标注(实体识别)、早期机器翻译都靠它。但传送带有个致命弱点:序列一长,开头的信息传到结尾时已经衰减殆尽。技术根源是梯度消失——训练时误差信号沿时间步反向传播,每传一步乘一次小于一的系数,几十步之后梯度趋近于零,模型根本学不到远距离的依赖。反过来梯度也可能爆炸,让训练直接发散。一条两百字的投诉,RNN 读到最后已经忘了开头提到的订单号。
**长短期记忆网络(LSTM)**给传送带加了三道闸门。遗忘门决定旧状态丢弃多少,输入门决定新信息写入多少,输出门决定对外暴露多少;旁边另设一条独立的细胞状态通道,信息可以在其中近乎无损地直通远处。三道门各司其职,长距离依赖得以保留——LSTM 之所以叫"长短期记忆",正因为它同时维护短期的工作记忆和长期的细胞记忆。门控循环单元(GRU)是它的简化版,把三道门并为更新、重置两道,参数更少、训练更快,多数任务上效果与 LSTM 相当。工程上两者常按算力预算互换。
注意力机制换了个思路:既然要翻遍整条传送带找相关信息,不如让每个词直接"看"句子里所有词,按相关性加权取用。处理"它的电池耐用吗"时,"它"对句中其他词计算相关权重,发现与"手机"最相关,就此完成指代消解——不需要信息沿时间步缓慢传递,一步直达。注意力不独占某个模型,它是可嵌入各类模型的技术。进一步,堆叠多头注意力(多组注意力并行关注不同侧面)去掉循环结构的模型,就是 Transformer——第4.3节大语言模型的地基。
💡 关键直觉:这一演进链的每一步都在回答同一个问题——"怎么让远处的信息过得来"。RNN 靠接力,LSTM 给接力队员配上保险箱,注意力干脆取消了接力,改用对讲机全员直连。
五、训练机制一瞥:模型怎么学
深度学习模型的训练是一个迭代循环,四个角色各司其职。损失函数量化预测与真实的差距,分类任务常用交叉熵;优化器根据差距对参数的梯度去更新权重,随机梯度下降一脉里 Adam 最常用;反向传播是计算梯度的核心算法,把误差从输出层逐层传回输入层。训练数据里,词向量可以随任务联合训练,也可以用预训练好的初始化后微调——后者正是"预训练与迁移学习"思想的雏形:在大语料上学到的语义知识,平移到自己的小任务上,几万条标注就能达到过去几十万条的效果。这一思想后来放大成 BERT、GPT 乃至大语言模型,是整个 NLP 十年来最重要的转折。
训练之外还有推理。工程上常在部署前做模型压缩:知识蒸馏让小模型模仿大模型的输出,剪枝删掉不重要的连接,量化把参数精度从高降到低——三个动作都是为了把延迟和成本压下来,第2.4节与第4.2节会回到这些手段。
⚠️ 常见坑:两个。其一,在小语料上从零训练词向量,语义质量极差——语料不够时应该用预训练向量起步,而不是硬训。其二,无脑选 LSTM 或 Transformer:几千条样本、短文本、强基线(TF-IDF 加线性分类器)就能打平的任务,上深度模型只会增加调试负担。模型复杂度要和数据规模、任务难度匹配,这是比任何单一算法都重要的判断力。
核心回顾
- 分布式假设是词向量的根:词义由上下文决定,上下文重叠的词向量自然靠近,语义相似度变成几何距离;
- CBOW 快而 Skip-gram 利低频词,FastText 靠字符片段解决未登录词,是错别字场景的刚需;
- 静态向量一词一向量,无法消歧;上下文向量(BERT 系)让同一个词随语境变化,是两代技术的分水岭;
- 序列模型演进的主线是"让远处信息过得来":RNN 接力、LSTM 门控保险、注意力全员直连,Transformer 是注意力的完全体;
- 预训练加微调是十年来最重要的范式:大语料学通用语义,小标注做任务适配,这一思想通向大语言模型。
下一节把词向量和这些模型组装成八类实战任务:分类、识别、匹配、摘要、生成、问答,每一类都有"输入—输出—算法—坑"的四要素速查。