2.3 列族门派:为海量写入而生
2.3 列族门派:为海量写入而生
巡礼第三站是列族门派——五大门派里离"日常 Web 开发"最远、离"超大规模基础设施"最近的一派。它不像键值、文档那样容易上手体验,但理解它的思想(宽表、查询优先建模、顺序写优化)对任何规模的系统设计都有启发。
历史动因:Bigtable 的工业落地
列族门派的族谱在 1.2 节已经埋过伏笔:2006 年 Google 的 Bigtable 论文。这篇论文要解决的是网页索引的存储——数十亿网页、每个网页有几十上百个属性(标题、链接、锚文本、抓取时间……),写入以每天数亿次计。传统行式存储有三个不适:一行里大量属性为空(稀疏),浪费存储;写入模式是批量追加而非随机更新;数据量注定要分摊到成千上万台机器。
Bigtable 的答案是稀疏的、分布式的、持久化的多维有序映射,俗称宽表:数据按行键有序存放,行内按列族分组,列族下再按列限定符展开,每个单元格带时间戳。HBase 在 2007 年前后由模仿 Bigtable 的开源项目演化而来并进入 Apache 基金会;Facebook 在 2008 年基于 Dynamo 的分布式思想重写了 Bigtable 式数据模型,产出 Cassandra,2009 年开源。两兄弟自此代表了这一派的两个分支。
数据模型:把行铺开成列
用一张概念图对比行式与列族思维的差异:
关系型行式思维(一行是一个记录,按行存储): 行1: [id, name, addr, phone, email, tag1, tag2, ...] ← 大量 NULL 列族思维(按行键排序,列按需存在,单元格带版本时间戳): 行键 "user1001" ├─ 列族 basic: name=山丘 (t=1003) │ addr=杭州 (t=1003) ├─ 列族 contact: phone=13800000000 (t=1003) │ email=a@example.com (t=1001) ← 旧版本仍可读 └─ 列族 tags: hobby=climbing (t=1002)
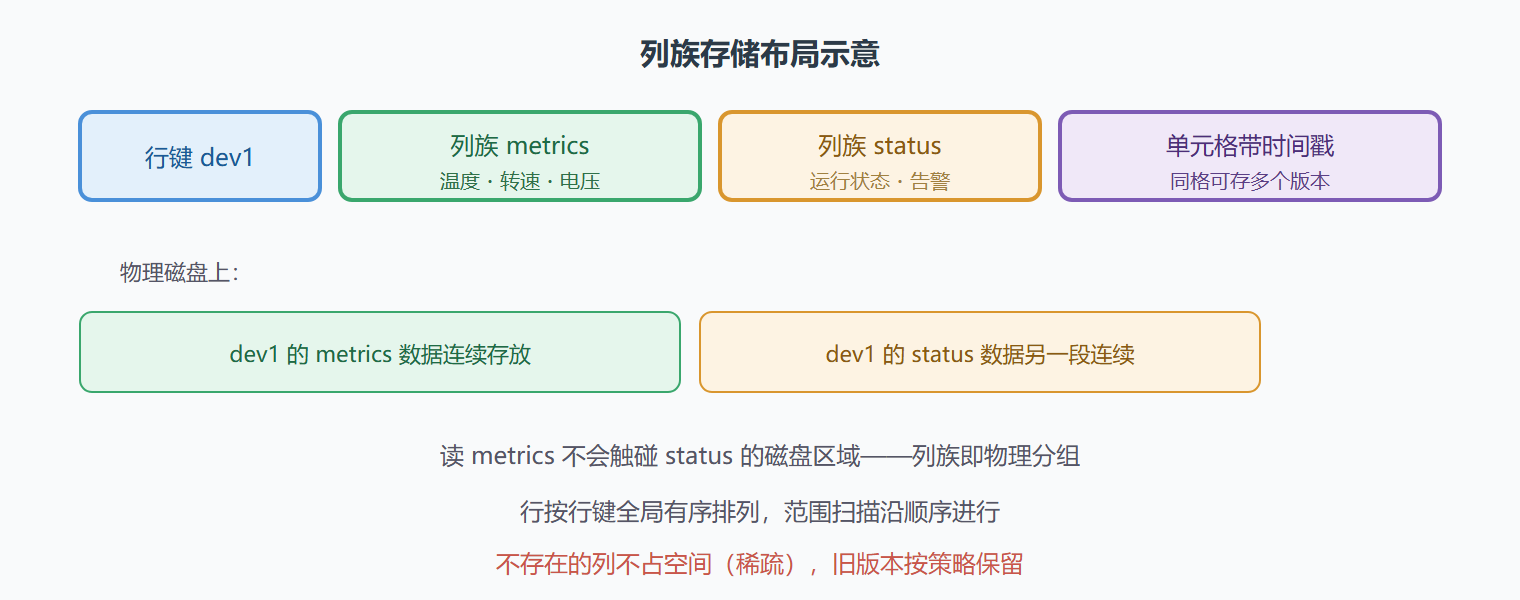
三个要点。其一,列族是物理分组单元:同一列族的数据在磁盘上连续存放,读取某列族时不会拖出其他列族——这是"列"存储直觉的来源(按需读列而非整行)。其二,列可以稀疏存在:某行没有的列根本不占空间, billion 行级表里几百个可选属性也不浪费。其三,单元格多版本:每个值可带时间戳保留多个版本,天然适合"数据只追加、按时间读取"的场景。
最反直觉的一点:列族门派建模为查询服务。关系型建模先想"实体长什么样"再考虑查询,列族建模必须先列出所有已知查询,再倒推设计行键与列族——因为唯一的快速访问路径就是"按行键定位 + 行键范围扫描"。行键设计是整派最难也最重要的功夫,设计错了没有索引可救。
代表产品
| 产品 | 血统 | 定位与特色 | 典型场景 |
|---|---|---|---|
| Cassandra | Bigtable 模型 + Dynamo 协议 | 无主架构、多数据中心友好、写吞吐极高 | 消息投递记录、设备数据、用户行为流 |
| HBase | Bigtable 模型 + Hadoop 生态 | 有主架构、强一致读写、与 Hadoop 计算栈无缝 | 大规模离线分析底座、消息归档 |
两者的架构差异是选型分水岭:Cassandra 没有主节点,所有节点对等,任意节点可读写,网络分区时仍可写入(AP 倾向,第 3 章展开),跨机房部署成熟;HBase 依赖中心协调节点,读写一致性更强(CP 倾向),且与 Hadoop 生态的计算框架衔接顺畅。一句话粗记:要全球分布与写入吞吐选 Cassandra,要强一致与大数据分析选 HBase。
演练:设备时序数据的 Cassandra 建模
背景:一家工厂有 20 万台设备,每台每 10 秒上报一次温度与转速,要求按设备按时间段快速查询,并支持整月趋势统计;写入量约每秒 2 万条,增长无期。
操作:第一步确定主查询是"单设备某时间段的全部读数",据此设计表——分区键用设备编号,聚类列用采集时间,这样同一设备的数据物理上聚在一起,时间段查询变成一次范围扫描;第二步设定分区粒度,按"设备 + 月份"做分区键,防止单个分区无限膨胀(Cassandra 建议单分区控制在几百万行内);第三步写入用批量语句按分区分组提交,读端按设备 + 时间范围查询。
-- Cassandra 查询语言建表 CREATE TABLE device_metrics ( device_id text, month text, -- 形如 2026-08,控制分区大小 ts timestamp, temperature double, rpm double, PRIMARY KEY ((device_id, month), ts) ) WITH CLUSTERING ORDER BY (ts DESC); -- 典型查询:某设备某月的读数,时间倒序 SELECT * FROM device_metrics WHERE device_id = 'dev-88123' AND month = '2026-08' AND ts >= '2026-08-01' AND ts < '2026-09-01';
结果:写入稳定在目标吞吐以下且延迟平稳(顺序追加写的红利);单设备查询延迟毫秒级;整月趋势查询因为数据按时间有序聚簇,扫描效率高。
解读:注意建模过程是从查询倒推表结构——没有次级索引、没有关联查询,一切设计服务于那一个已知查询。若需求突然变成"查全厂某天温度超标的设备",这张表就要新增一张按时间分区的"倒排表"来支撑(写入双份),这就是列族门派的扩展方式:为新查询建新表,而非加索引。
变式:若设备数据还要支持任意属性的即席检索,应引入搜索门派(2.5)双写;若规模其实只有几千台设备,一张普通关系型表加好索引完全够用,不必上重型装备。
图:宽表的物理布局——行键有序、列族分组、多版本
易错点
两大高频翻车点。行键设计不当导致热点:用时间戳做分区键,所有写入都涌向同一个分区,集群其余节点干瞪眼;正确做法是把离散度高的字段(设备、用户)放进分区键。把列族当关系型用:指望它做关联、聚合、事务,结果处处别扭——这一派的天赋树点在"超量写入 + 范围扫描"上,其他需求请改道。
本节要点回顾
- 列族门派源自 Bigtable 论文,核心模型是稀疏宽表 + 列族分组 + 单元格多版本。
- 物理布局决定能力:同列族连续存放、列稀疏存在、按行键有序扫描。
- 建模为查询服务:先列查询,再设计行键,一查询一表是常态。
- Cassandra 与 HBase 的分水岭:无主 AP 对有主 CP,全球分布对大数据生态。
- 行键设计是唯一救命稻草,热点与扩表成本都在它身上。
第四站图门派:前几派都在优化"找到数据",这一派优化的是"顺着关系走"。