3.1 整体Encoder-Decoder结构
3.1 整体Encoder-Decoder结构
本节摘要:Transformer 沿用编码器-解码器框架处理序列到序列任务:编码器把输入序列加工成一组上下文相关的向量表示,解码器在这些表示与已生成内容的基础上自回归地逐词产出目标序列,两者通过交叉注意力衔接——取代了旧 Seq2Seq 的固定长度上下文向量。本节从顶层走通完整数据流,区分训练(教师强制、整句并行)与推理(自回归循环、逐词反馈)两种模式,并对比新旧两代 Encoder-Decoder 的连接方式差异。
学习目标
阅读完本节,你应当能够:
- 按顺序描述一段输入从词元到输出概率的完整数据路径;
- 说明训练与推理两种模式下解码器工作方式的差异及教师强制的含义;
- 解释交叉注意力如何取代固定上下文向量及其带来的性能差异;
- 对比 Transformer 与 RNN 版 Encoder-Decoder 在并行性、长程依赖、模块化上的不同;
- 说出解码器"输出右移一位"的目的。
一、两个塔的分工
先把角色分清。编码器是"读者":吃进源序列(如待翻译的英文句子),产出与输入等长的一组向量,每个向量是读完全句后对对应位置的深度理解。解码器是"作者":一边通过交叉注意力查阅编码器的产出,一边读自己已经写下的内容,逐词预测下一个词。两侧各自堆叠六层(原论文配置),每层都是第 2 章拆过的子层组合。
衔接两塔的是解码器每层的交叉注意力子层:查询来自解码器上一子层,键与值来自编码器最终输出。生成每个目标词时,解码器都能"回头翻阅"源序列的全部位置,按当前需要动态分配注意力。这与旧 Seq2Seq 形成关键差异:旧版把整句压成一个固定向量递给解码器,句子一长信息溢出;新版按词按需取用,长度压力被分散到每次检索里。
二、完整数据流:训练模式
训练时数据怎么流,逐站过一遍。第一站,输入端:源序列被分词器切成词元(第 4 章 4.1 节展开),查嵌入表变成向量,加位置编码,送入编码器。第二站,编码器六层:每层"多头自注意力加前馈",表示逐层精炼,顶层输出即上下文表示。
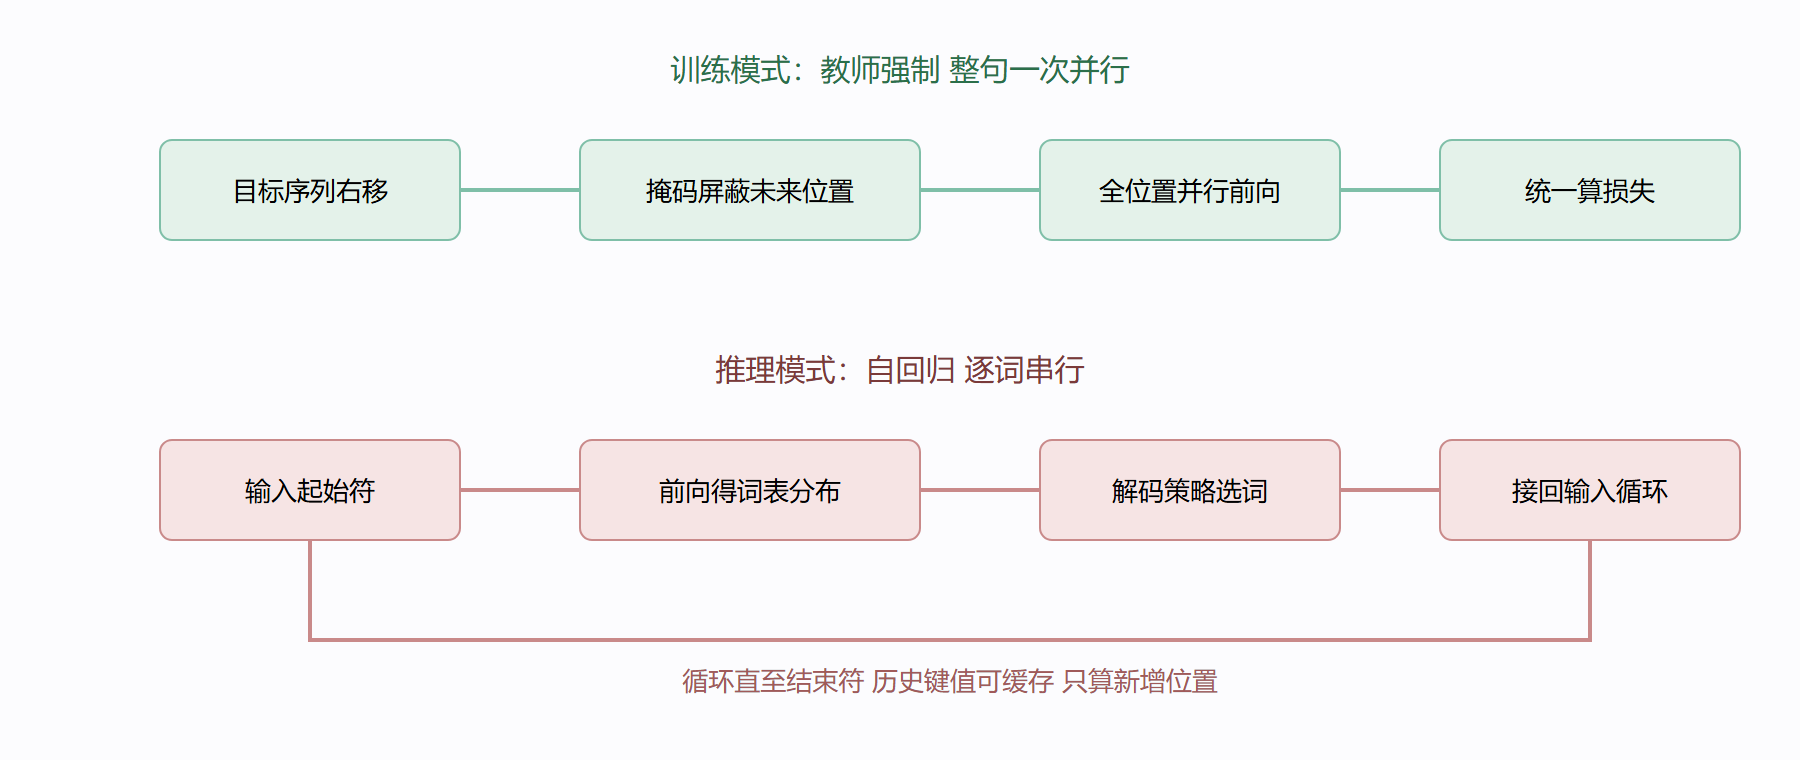
第三站是训练模式的关键机关:教师强制。目标序列(如法语译文)整体右移一位——句首补一个起始符,句尾去掉最后一个词——作为解码器的输入。这样第 t 个位置的解码器输入恰好是前 t 个词,配合掩码自注意力屏蔽未来,模型在第 t 个位置预测第 t 加一个词。整条目标序列的所有位置可以并行前向:一次前向同时得到全部位置的预测,再统一与真实目标算交叉熵损失。这就是"训练并行"的实现方式——不是靠魔法,是靠右移加掩码把因果约束伪装进矩阵运算。
第四站,输出端:解码器顶层输出经线性层映射到词表大小,softmax 成概率分布。损失用真实目标词比对,反向传播更新参数(第 4 章 4.2 节)。
三、完整数据流:推理模式
推理时没有目标序列可喂,解码器改为自回归循环。第一步,编码器处理源序列(只需一次,结果缓存复用)。第二步,解码器输入仅含起始符,前向得到词表分布,按某种解码策略(贪婪、束搜索等,详见 4.3 节)选出第一个词。第三步,把已生成的词接回解码器输入,再前向,选出第二个词。如此循环,直到选出结束符或达到最大长度。
注意训练与推理的不对称:训练整句并行、一步前向;推理逐词串行、步步前向。这是 Transformer"训练快、推理受制于序列长度"的根源,也是工程上各种缓存优化(缓存历史位置的键值、避免重复计算)的用武之地。每生成一个新词,只有新位置的计算是增量的,历史位置的键值可以复用——这个细节在第 4 章推理一节还会展开。
训练与推理数据流对比
四、与旧 Seq2Seq 的对比
把两代 Encoder-Decoder 并排看,差异集中在三点。连接方式:旧版是编码器末状态这一个固定向量,新版是编码器全部位置的表示、经交叉注意力按需检索。并行性:旧版编码解码都按时间步串行,新版训练全程矩阵并行。长程依赖:旧版靠隐藏状态接力,新版源序列内部、目标序列内部、跨序列三类依赖都是注意力直达。
还有一点结构性的差别:模块化程度。Transformer 每层由标准子层拼装,改造成本低——后来 BERT 抽掉解码器只留编码器做理解任务,GPT 抽掉编码器只留解码器堆栈做生成任务,都是在同一套零件库上做减法。这个"骨架可裁剪"的性质,是 Transformer 能长出一个模型家族的结构原因。
| 维度 | RNN 版 Seq2Seq | Transformer 版 |
|---|---|---|
| 两塔连接 | 单个固定向量 | 全部位置表示加交叉注意力 |
| 编码并行性 | 无 时间步串行 | 全序列矩阵并行 |
| 训练时解码 | 逐步展开 难并行 | 右移加掩码 整句并行 |
| 远距离依赖 | 逐步传递易衰减 | 三类依赖均一步直达 |
| 可裁剪性 | 结构耦合 改造难 | 模块化 催生编码器或解码器专用家族 |
⚠️ 常见误解两条。其一,以为"训练并行"意味着训练时解码器真的看不到顺序——顺序约束由掩码保证,并行只是把串行的因果计算重排进一次矩阵前向,数学上等价。其二,把教师强制与推理脱节的问题丢给架构——训练时解码器输入永远是真实的干净目标词,推理时却要吃自己生成的不完美输出,这种暴露偏差是所有自回归模型的通病,对策(如调度采样)属于训练策略层面,而非架构本身。
💡 阅读建议:找一张原始论文的架构图,对照本节数据流逐箭头标注"训练时此处是什么、推理时是什么"。标完一遍,整机视角就立起来了——后面两节的细节都有了挂靠点。
五、数据流的形状总账与两个专题
把全链路的张量形状记成一笔总账,调试时收益巨大。输入端:编号矩阵,批大小乘以序列长度(整数);嵌入后加一维模型维度,成三维浮点张量;编码器六层,形状全程不变;解码器同构,另接编码器输出作交叉注意力的键值(序列长度为源长,与目标长独立);塔顶线性层把模型维度换成词表大小,softmax 后仍是批大小乘以目标长乘以词表大小的三维张量。任何自定义改动(插层、改维度、接自定义头)都应先在这张账上推演形状,再动手写码。
专题一:批处理与变长序列。同一批内句子长短不齐须补齐到最长,代价是短句带着一堆填充位做无效计算,且填充位必须被掩码屏蔽(自注意力打分置负、损失计算跳过)。工程折衷是按长度分桶组批,同桶内长度接近,填充浪费最小化——吞吐优化里性价比极高的一招,常被新手忽略。
专题二:训练与推理的工程衔接。训练结束后进入推理,两处转换要做对:掩码行为不变(因果约束永远在场);dropout 关闭并配缩放(训练专属组件退出)。另一处常见疏漏是训练时模型接触的都是干净目标词,推理时却要消化自己的输出——前文提过的暴露偏差。缓解手段之一是训练后期混入部分模型自己的生成结果替代真实词,让模型提前适应"不完美前文";属于进阶技巧,知道其存在与动机即可。
⚠️ 一条容易被轻视的军规:交叉注意力的键值在推理时来自编码器的一次前向,务必缓存复用。逐词生成若每步都重跑编码器,长句场景的延迟会放大几十倍。这不是算法问题而是实现问题,code review 时值得专门核对。
💡 学习闭环建议:找任一开源 Transformer 的推理代码,对照本节数据流逐行标注"此处对应训练模式还是推理模式、此处张量形状是什么"。标完这份对照,第 3 章的顶层视角就完成了从纸面到代码的落地。
交叉注意力为什么放在解码器每层,而不是只放一次?
直觉上在解码器入口融合一次编码器信息似乎更省。但一次融合等于把源序列再压一遍成固定接口——恰是旧 Seq2Seq 固定向量瓶颈的翻版。层层交叉让每一层都能带着逐层精炼的查询重新取料:浅层取词法与表层对齐,深层取语义与语篇对应,抽取的粒度随表示深度同步进化。代价是每层多一次注意力计算,收益是信息无损的按需供给——这笔交易在翻译质量上的回报已被反复验证。
本节速览
- 两塔分工:编码器读入并精炼表示,解码器自回归产出,交叉注意力是唯一传声筒;
- 取代固定向量:按需检索全位置表示,长度压力分散到每次注意力里;
- 训练靠教师强制:目标右移加掩码,把串行因果伪装成整句并行的矩阵运算;
- 推理靠自回归循环:逐词前向、结果接回输入,历史键值可缓存增量计算;
- 训练推理不对称:训练一步整句、推理步步逐词,后者是推理优化的主战场;
- 三点碾压旧 Seq2Seq:连接方式、并行性、长程依赖,另有模块化带来的可裁剪性;
- 骨架可裁剪:BERT 与 GPT 分别只取编码器与解码器,同一零件库的减法设计。
顶层协作清楚了。下一节进编码器塔内部,看"双子层"如何把一个词加工成读完全句的表示。
常见疑问
问:编码器和解码器之间的信息只通过交叉注意力传递吗?
答:是的,交叉注意力是唯一的桥梁——解码器每一层的交叉注意力子层里,Query 来自解码器状态,Key 与 Value 来自编码器输出。这个设计的好处是解耦彻底:编码器只需产出高质量的源表示,解码器按需检索,两侧可以独立优化。后来的研究甚至证明这个桥可以做得更松(层间共享、稀疏连接),但「单一接口连接两大件」的思想没变过。
问:原论文的 N=6 是什么意思,为什么是六层?
答:N=6 指编码器与解码器各堆叠六层,这是原论文的实验配置——层数在那时是算力与效果的折中,并非魔法数字。后续模型从四层到上百层都有,层数已是纯粹的规模超参数。但「编码器 N 层、解码器 N 层、层内结构完全一致」这个堆叠范式被完整继承,读懂原架构就等于读懂了所有变体的骨架。