第3章 整体架构:编码器与解码器
章节摘要:零件讲透了,本章开始组装。Transformer 沿用经典的编码器-解码器框架处理序列到序列任务:编码器把输入序列转成一组上下文相关的向量表示,解码器在这些表示与已生成内容的基础上自回归地产出目标序列,二者通过交叉注意力衔接。本章先看整体数据流与训练、推理两种模式下的差异,再分别深入编码器层的双子层结构与解码器层的三子层结构,重点拆解掩码自注意力的因果约束。读完本章,原始论文那张架构图里的每一个方框都应不再是黑盒。
阅读收获
阅读完本章,你应当能够:
- 描述一段输入从词元到输出概率的完整数据路径,区分训练与推理两种模式;
- 说出编码器层的两个子层及各自的职责,追踪一个向量经过单层的形状变化;
- 解释解码器掩码自注意力的因果约束如何在训练中通过教师强制并行实现;
- 说明交叉注意力中 Query、Key、Value 的来源与编码器-解码器的信息衔接方式;
- 对比 Transformer 与 RNN 版 Encoder-Decoder 在连接方式上的本质差异;
- 指出最终线性层与 softmax 如何把解码器输出变成词表上的概率分布。
核心概念速览
编码器负责"读懂",解码器负责"写出",交叉注意力是两者之间唯一的传声筒。
编码器-解码器分层透视
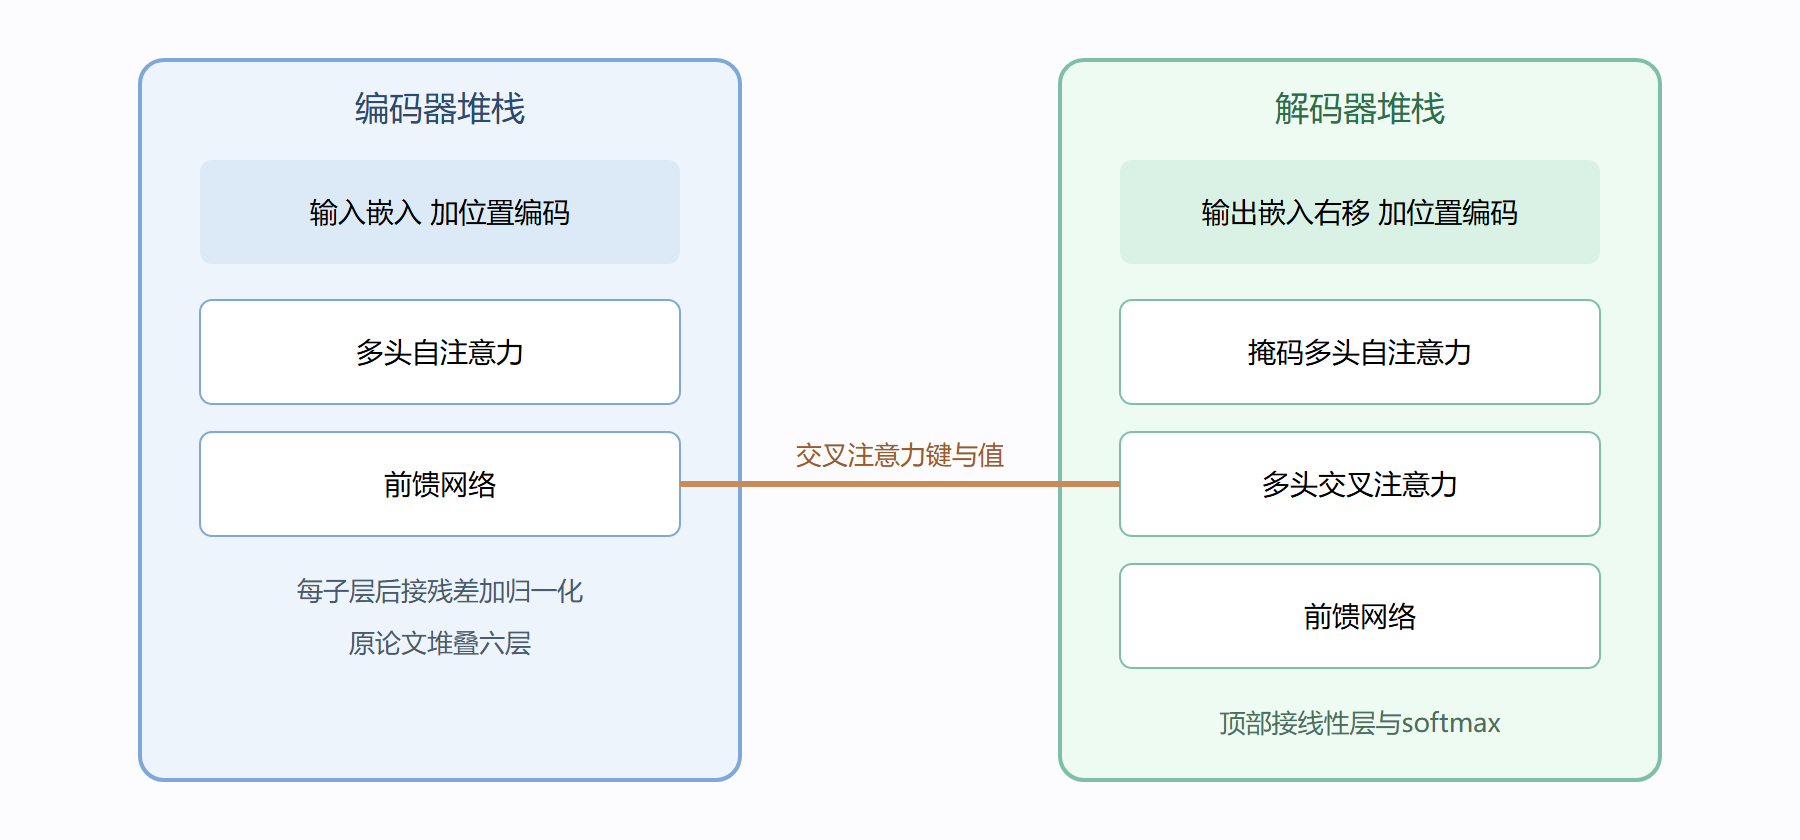
子章节导航
3.1 整体Encoder-Decoder结构
从顶层视角走一遍数据流:训练时教师强制带来的并行性、推理时自回归循环的逐步反馈,以及交叉注意力如何取代旧 Seq2Seq 那个固定长度的上下文向量。
3.2 Encoder模块详解
编码器把每个输入词元加工成"读过全句"的表示。本节追踪从嵌入、位置编码到六层堆叠的完整路径,并解释为什么同一个词在不同句子里会得到不同的向量。
3.3 Decoder模块详解
解码器层比编码器层多一个子层:掩码自注意力管住"不许偷看未来",交叉注意力负责"回看输入",前馈网络做最终加工。本节是理解文本生成因果性的关键。
子章节之间的逻辑关系
一句话论点:3.1 给出协作协议,3.2 与 3.3 分别是实现协议的两个当事方。
3.1 整体数据流与训练推理差异 | +----+----+ v v 3.2 编码器 3.3 解码器 两个子层 三个子层(多一个掩码自注意力) | | +--交叉注意力衔接--+
三节连读效果最好。若你已掌握第 2 章的组件细节,3.2 与 3.3 中唯一的新知识点分别是"层堆叠的信息提炼"与"因果掩码",其余内容都是旧零件的新位置。掩码这个话题会延续到第 4 章——训练时的教师强制掩码与推理时的自回归循环,是同一因果约束在两种模式下的两种实现。
本章常见问题
为什么机器翻译需要两座塔,分类任务却常用一座?
任务形态决定骨架。翻译有明确的源输入与目标输出,编码器消化源句、解码器产出目标,交叉注意力负责对接。分类任务的输出只是一个标签,不需要自回归生成,编码器单独足够——BERT 正是抽掉解码器的产物。反过来,开放式的对话写作没有固定源输入,纯解码器堆栈配因果掩码即可工作,GPT 走的就是这条路。骨架的取舍逻辑在 4.4 节的模型家族分类里会再次出现。
掩码是不是越少越好?它会不会限制模型能力?
掩码是因果约束的执行者,不是性能负担。训练阶段它保证"预测不能抄答案",推理阶段它对应的限制本来就无法绕开——生成第 t 个词时未来词尚不存在。真正值得注意的是训练与推理的分布差异:训练时解码器永远读干净的真实前文,推理时却要消化自己生成的可能有误的输出,这种不一致是所有自回归模型的通病,属于训练策略层面的研究课题,而非架构缺陷。
编码器和解码器的层数必须一样吗?
原论文两侧各六层,是当时的工程选择而非硬性规定。后续实践中两侧层数不对称的设计并不少见——例如解码器更深以增强生成能力,或编码器更深以强化理解。需要一致的约束只有接口:交叉注意力的键值维度要与解码器的查询维度对齐。理解了 3.1 节的数据流,这类变体设计都能自行推演。
前置知识与后续延伸
- 前置:第 2 章全部五节,尤其是 2.1 的自注意力流程与 2.5 的 Add & Norm 结构;对 softmax 概率分布的直观理解。
- 为后续铺垫:3.3 节的"线性层加 softmax 输出词表分布"直接通向 4.1 节的输出处理与 4.2 节的交叉熵损失;3.1 节的自回归生成循环是 4.3 节解码策略的舞台;编码器-解码器的取舍(只用编码器的 BERT、只用解码器的 GPT)则是 4.4 节理解开源模型家族分类的背景。
一个常见的检验方式:随机遮住架构图的一角,看自己能否凭因果链补全。能做到,说明架构已经内化;做不到,回到对应小节再看一遍推导。
编码器解码器分工表
| 维度 | 编码器 | 解码器 |
|---|---|---|
| 输入 | 完整源序列 | 已生成的目标序列前缀 |
| 注意力可见范围 | 双向,全句互通 | 因果掩码,只看左侧 |
| 每层子模块数 | 两个 | 三个(多一个交叉注意力) |
| 输出 | 源序列的上下文表示 | 下一个词的概率分布 |
| 典型代表 | BERT 系 | GPT 系(只保留解码器侧) |
读本章的要诀是「先分工后拼装」:3.1 看两大件怎么咬合(交叉注意力是唯一的桥),3.2 与 3.3 分别进两个车间看内部流水,最后回到 3.1 的总图确认自己能把整条数据路径讲一遍。能脱稿讲清「一句话从输入到输出经历了什么」,这一章就通了。