3.3 Decoder模块详解
3.3 Decoder模块详解
本节摘要:解码器由六个相同层堆叠,每层三个子层:掩码多头自注意力(屏蔽未来位置保证因果性)、多头交叉注意力(查阅编码器输出)、逐位置前馈网络,各子层被残差加层归一化包裹;塔顶接线性层与 softmax 输出词表分布。本节重点拆解因果掩码的实现与必要性、交叉注意力中查询与键值的来源、训练与推理两种工作模式,以及结束符驱动的生成终止机制。
你能学到什么
阅读完本节,你应当能够:
- 说出解码器层三个子层的名称、顺序与各自职责;
- 解释因果掩码的具体实现(下三角可见、上三角屏蔽)及其必要性;
- 指明交叉注意力中查询、键、值的来源与信息流向;
- 描述解码器输入"右移一位"的构造及训练推理两种模式的差异;
- 说明线性层加 softmax 如何产出词表分布、生成何时终止。
一、多出来的那个子层
解码器层比编码器层多一个子层,三段式结构按顺序是:掩码多头自注意力、多头交叉注意力、逐位置前馈网络,每段都被"相加加层归一化"包裹。多出来的正是中间的交叉注意力——解码器既要有编码器的自交流与消化能力,还多一项"查阅源序列"的职责。
三段的信息流一句话概括:先在已生成内容内部对齐(掩码自注意力),再向编码器表示取料(交叉注意力),最后逐位置加工(前馈)。每个目标词的诞生,都是"回看自己写过的,查阅源句说的,再消化成下一个词的预测"这三步的产物。
二、因果掩码:不许偷看未来
掩码自注意力是解码器的标志性机关,解决的问题只有一个:训练时要并行预测整句,但第 t 个位置绝不能看到第 t 加一及其后的词——否则就是抄答案,训练形同虚设,推理时没有答案可抄,模型瞬间露馅。
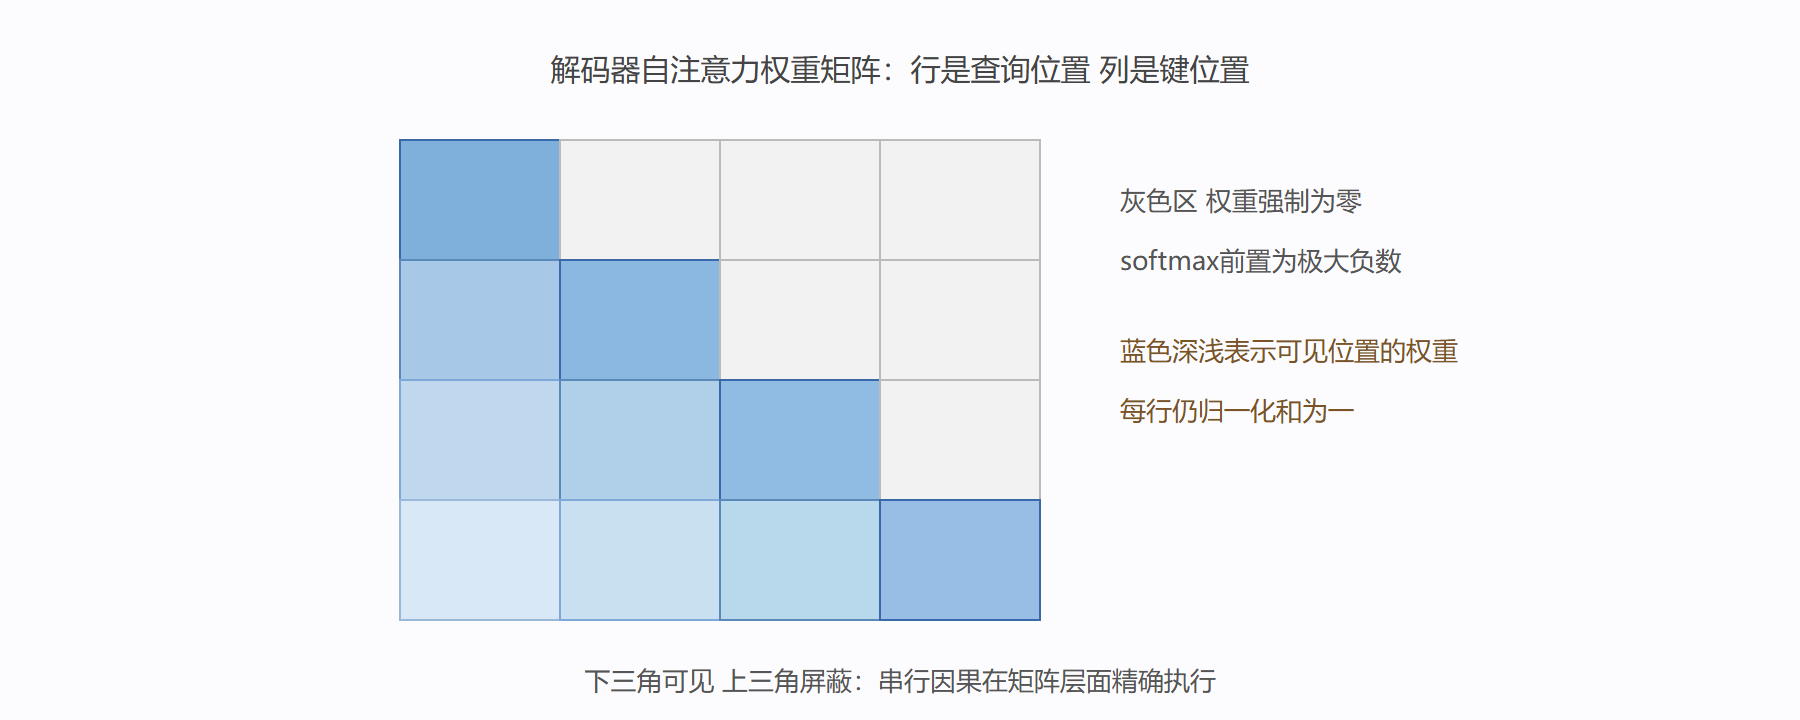
实现方式在 2.1 节埋过伏笔:softmax 之前,把分数矩阵的上三角(列号大于行号的位置,即"未来")改写成一个极大的负数。softmax 归一化后,这些位置的权重严格归零——不是"变弱",是"不存在"。分数矩阵因此呈现下三角结构:每个位置只与自己及之前的所有位置交互,串行生成的因果约束在矩阵层面被精确执行。
配合这个掩码,训练用的是 3.1 节讲过的教师强制:目标序列右移一位(句首补起始符),整句并行前向,每个位置基于真实的前文预测下一个词。一次矩阵运算等价于逐步展开的串行预测——掩码就是那份"时间表"。
值得想清楚的一点:掩码只在训练与解码器自注意力里需要。编码器看整句天经地义(理解任务无因果约束),交叉注意力里键值来自源序列也不存在"未来"问题。掩码是因果生成任务的专属约束,不是注意力的普遍属性。
因果掩码的下三角结构
三、交叉注意力:解码器的取料口
第二个子层是两塔之间的传送带。查询来自上一个子层(掩码自注意力)的输出——即"当前要生成的词需要什么信息";键与值来自编码器顶层输出——即"源序列每个位置能提供什么"。查询与键打分、对值加权和,目标词由此从源句里按需抽取相关内容。
以翻译为例:生成法语动词时,交叉注意力的高权重往往落在英文动词短语上;生成形容词性数变化时,权重偏向被修饰的名词。每个目标词的生成都对应一次对源序列的"定向检索",不同头分工不同(2.2 节的多头机制在此同样生效)。
一个容易混淆的点:交叉注意力不掩码。查询和解码位置可以查阅源序列的全部位置——源句早就完整给出,没有未来可言。掩码只约束解码器"自己的"序列。
四、塔顶:从向量到词的概率
六层解码后,顶层输出仍是每个位置一个模型维度向量,需要翻译回语言。塔顶两步:线性层把向量投影到词表大小维度,得到每个候选词的分数(对数几率);softmax 把分数归一成概率分布。训练时这个分布与真实下一词算交叉熵;推理时按解码策略(贪婪、束搜索、采样等,4.3 节专场)选出词,接回输入进入下一轮,直到选出结束符或达到最大长度。
终止机制值得多说两句。词表里预留一个特殊结束符,模型把它当作普通词学习——训练语料每句末尾都标着它,模型逐渐学会"内容说完了就该输出它"。推理循环见到结束符即停,序列长度由模型自己决定,而非外部硬编码。这解释了为什么生成任务能输出变长序列:长度信息本身被编码进了词的预测里。
| 子层 | 查询来源 | 键值来源 | 掩码 | 职责 |
|---|---|---|---|---|
| 掩码自注意力 | 本序列上一层输出 | 本序列上一层输出 | 屏蔽未来 | 已生成内容内部对齐 |
| 交叉注意力 | 上一子层输出 | 编码器顶层输出 | 无 | 从源序列按需取料 |
| 前馈网络 | 逐位置 | 无交互 | 无 | 非线性消化 |
⚠️ 排查提示:解码器实现的两处高发错误。一是掩码方向写反(屏蔽了下三角),症状是训练损失下不去且生成内容与输入毫无关联——因为模型实际看到的全是"未来"。二是交叉注意力的键值误接了编码器中间层而非顶层,或误用了本层解码器的输出,信息流错位,翻译任务表现为译文流畅但驴唇不对马嘴。
💡 一个帮助记忆的口诀:解码器每层"先看自己写过的(带锁),再看源句说的(不锁),最后闭门消化"。三句话对应三个子层,锁就是因果掩码。
五、解码器的实战观察与延伸
生成中的常见病症与定位
逐词生成暴露的问题各有指纹。复读机现象(同一短语循环输出)多与解码策略有关——温度过低或贪婪使路径锁死,先调策略再查模型;提前终止(过早输出结束符)常是训练数据里短样本占比过高的偏置,或最大长度截断把长样本的结束符教丢了;生成内容与源输入无关(翻译驴唇不对马嘴),优先怀疑交叉注意力的键值接错——3.3 节的排查清单里这条排第一。把病症映射到子层,是解码器调试的基本功。
为什么生成必须串行,有没有并行生成的办法?
因果约束决定了第 t 加一词依赖第 t 词的输出,严格串行。缓解分两路:推理层面用键值缓存把每步开销压到近恒定(4.3 节展开);训练层面用教师强制并行(本节与 3.1 节讲过)。彻底的并行生成是研究前沿(一次性预测多词、自回归与非自回归混合等方案),尚未动摇自回归的主导地位——理解"为什么串行"比记住"串行"更重要,因果性是生成的本质约束。
解码器堆栈单独成军的含义
GPT 路线把解码器单独拎出来,去掉交叉注意力(没有编码器可查),只留掩码自注意力加前馈,用海量文本做下一词预测的预训练。这一"裁剪"能成立的根据正是本节的子层结构:掩码自注意力本身已提供"读前文"的完整能力,交叉注意力只是通往外部源序列的接口,没有源序列时自然可拆。反过来,BERT 抽掉解码器只用编码器。第 3 章的两塔在工程世界里各自独立成军,但零件与机制完全同源——这也是把架构学扎实的复利所在。
⚠️ 收尾提醒一条工程军规:推理时的结束符检查要放在"选出词元之后、拼回输入之前"——顺序颠倒会把结束符本身喂进下一轮前向,轻则多算一步,重则干扰统计。小细节,但在延迟敏感的服务里聚少成多。
💡 终极自测:合上书,从起始符出发,口述一遍"生成一个词"的完整旅程——经过哪三个子层、查了谁的键值、在哪里变成概率、谁来决定终止。全程不卡壳,第 3 章通关。
为什么掩码是"置极大负数"而不是直接置零?
因为顺序:掩码作用在 softmax 之前。若直接置零,零仍是一个合法分数,softmax 会给它分配正值权重——"屏蔽"变成"轻微参与",因果约束漏水。置为极大负数后,指数化使其权重趋于零,归一化时被彻底挤出分配。这个细节常被手写实现弄错,症状隐蔽:训练照常收敛,但生成质量莫名低一截——模型始终在轻微地"偷看"未来。排查方法是打印某步的权重矩阵,检查上三角是否严格为零。
本章回顾
- 三段式子层:掩码自注意力、交叉注意力、前馈网络,各被残差加归一包裹;
- 因果掩码的实现:softmax 前把上三角分数置为极大负数,权重严格归零,下三角结构精确执行串行因果;
- 掩码的适用范围:只约束解码器自序列,编码器与交叉注意力不掩码;
- 交叉注意力的信息流:查询来自解码器上一子层,键值来自编码器顶层,逐词定向检索;
- 教师强制配套:右移加掩码让整句并行训练等价于串行预测;
- 塔顶两步:线性投影到词表维度,softmax 归一成概率;
- 终止靠结束符:长度由模型自己预测,变长生成由此实现。
架构篇至此完整:零件、塔、协作机制全部就位。下一章转向让机器跑起来的实务——从文本如何变成张量讲起。
常见疑问
问:因果掩码具体是怎么实现的?
答:在注意力分数矩阵上动手脚:计算完全部词对的分数后,把「当前词看未来词」对应的格子填上一个极大的负数,softmax 后这些位置的权重就变成零。一句话,硬件上照样全矩阵并行计算,逻辑上装作未来不存在——这是 Transformer 能并行训练又能自回归生成的关键技巧,训练时一次前向等于Teacher forcing 的全部时间步。
问:GPT 为什么砍掉交叉注意力,只用解码器的一半?
答:因为 GPT 的目标是无条件的文本生成——不翻译、不摘要,就没有「源序列」需要交叉去看。砍掉交叉注意力后,解码器只剩带因果掩码的自注意力与前馈,结构更纯粹,训练目标(预测下一个词)也更通用,海量无标注文本全是免费教材。这个「减法」开启了预训练大模型时代:架构越简单,越配得上超大规模的数据。