第4章 训练与工程落地
章节摘要:前两章把模型当作一个静态的数学对象讲透了,本章让它动起来。内容覆盖四段:文本如何经分词、词汇表、词嵌入与位置编码变成模型输入,输出又如何经线性层与 softmax 变回词表分布;训练时交叉熵损失、Adam 系优化器、warmup 学习率调度与 dropout、权重衰减、梯度裁剪等正则手段如何协同;推理时自回归循环里贪婪、束搜索、温度、Top-k、核采样等解码策略各自的性格与适用场景;最后落到以 Hugging Face Transformers 为代表的开源生态,看现代工程实践如何把这套架构用起来。读完本章,你具备从零训练或微调一个小型 Transformer 并合理解读其行为的知识基础。
本节导读
阅读完本章,你应当能够:
- 对比词级、字符级、子词级三种分词策略的取舍,说明 BPE 一类方案为何胜出;
- 描述从原始文本到带位置信息输入向量的完整流水线及各步张量形状;
- 写出交叉熵损失的含义,解释 warmup 加衰减调度对 Transformer 训练稳定性的作用;
- 列举 dropout、权重衰减、梯度裁剪的适用位置与目的;
- 在生成质量与多样性之间为不同任务选择合适的解码策略并说明理由;
- 说出主流开源框架提供的能力边界,以及"用预训练模型微调"与"从零训练"的成本差异。
核心概念速览
训练的全部目标只有一句话:让模型给"正确的下一个词元"分配尽可能高的概率。
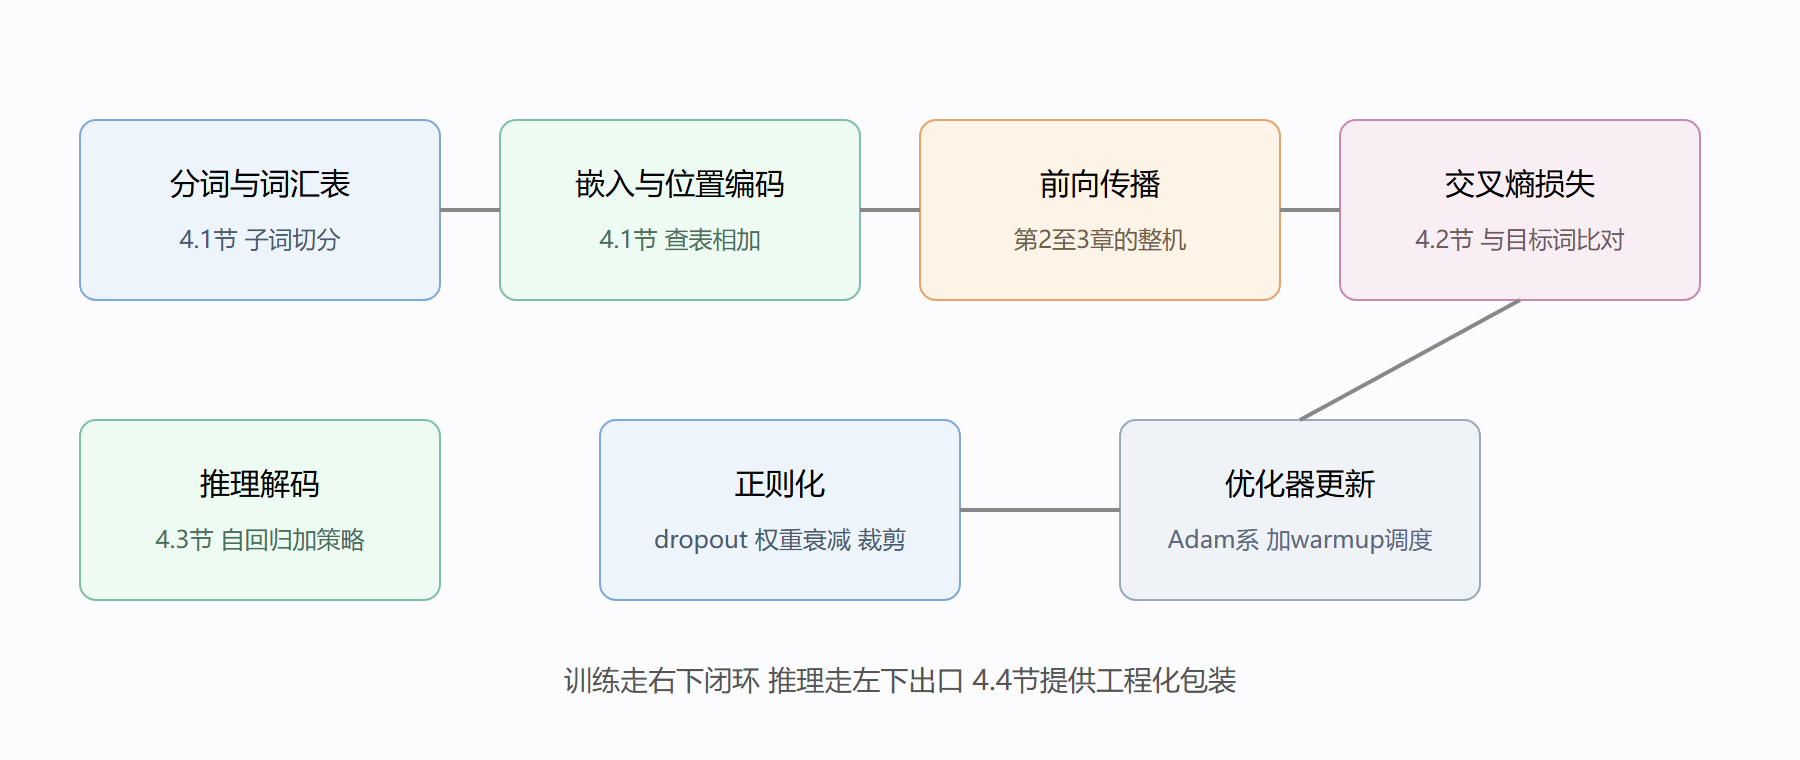
训练流水线全景
子章节导航
4.1 模型输入与输出处理
分词器的三档策略、词汇表与嵌入矩阵的形状关系、位置编码的接入位置,以及输出侧线性层与 softmax 的反向映射。这是模型与真实文本之间的翻译官。
4.2 训练过程与优化器
以交叉熵为目标,讲清 Adam 与 AdamW 的差异、原论文"warmup 步内线性升温、之后按步数平方根倒数衰减"的调度公式,以及各路正则化手段的落点。
4.3 推理过程与解码策略
自回归循环的机械流程之外,重点对比五类选词策略:贪婪快而易僵、束搜索广而守旧、温度调分布形状、Top-k 截长尾、核采样按累积概率自适应收缩候选集。
4.4 开源框架与实践
以 Hugging Face Transformers 为代表:模型仓库、分词器配套、预训练权重下载与微调流程,以及"从零训练"在数据与算力上的成本量级,帮你判断何时该造轮子、何时该用轮子。
子章节之间的逻辑关系
一句话论点:4.1 是模型与文本的接口,4.2 与 4.3 分别是训练态与推理态的运转方式,4.4 把前三者打包成工程可用的形态。
4.1 输入输出接口 | +---+---+ v v 4.2 训练 4.3 推理解码 | | +---+---+---+ v 4.4 框架与生态(预训练 微调 部署)
4.1 必须先读——后续所有张量形状都以它为准。4.2 与 4.3 顺序可换:偏研究读 4.2,偏应用读 4.3。4.4 依赖前面全部内容,也是本教程的收尾:当你能看懂一段微调脚本里每个参数的含义,这套教程的任务就完成了。
本章常见问题
训练一个 Transformer 最容易在哪一步翻车?
按出现频率排:学习率调度配置错误居首(忘了 warmup 或峰值过大,训练初期损失不降反升);数据管道问题次之(分词器与词表不配套、填充位混入损失);再次是数值稳定性(混合精度下的溢出、梯度爆炸未裁剪)。4.2 节末尾的故障对照表把这三类的症状与排查路径都列了出来,建议训练前先读一遍,出问题时按表索引。
微调一定比从零训练好吗?
在绝大多数场景下是。预训练赋予的通用语言能力极难用任务数据复现,微调相当于站在巨人的肩膀上调整方向。例外只有两类:研究全新模态或全新语言(没有合适预训练权重可用)、以及对数据与流程有完全掌控需求的头部机构。4.4 节的成本阶梯给出了三档路径的量化对比,从右往左走是默认策略。
解码策略的选择有没有公式可循?
有一个粗略的决策树:任务有标准答案(翻译、摘要)选束搜索;需要多样性(对话、写作)选核采样加温度;延迟敏感或事实性问答选贪婪或低温。但每个具体模型都有自己的"脾气",同一组参数在不同尺寸的模型上表现差异不小,最终还是要靠小规模人工评估来定。4.3 节的对比表与口诀可作为起点。
前置知识与后续延伸
- 前置:第 3 章的解码器输出概率分布(4.1 与 4.3 的接口)、2.3 节的位置编码(4.1 复现)、2.5 节的归一化(4.2 讨论训练稳定性时反复引用);对梯度下降有基本概念即可,优化器细节会在节内自足讲解。
- 延伸方向:本教程止步于原始 Transformer 与其直接工程化。往后的路包括预训练目标设计(掩码语言模型、自回归语言模型)、效率优化(稀疏注意力、长上下文方案)与多模态扩展,它们都以本教程内容为公共前提。
读完本章,建议动手做一件事:找一个开源的小型预训练模型,用不同解码策略生成同一段补全,对比输出差异。解码策略的性格,看十遍表格不如亲手跑一次。
训练要点速查表
| 环节 | 关键设置 | 常见坑 |
|---|---|---|
| 词表与嵌入 | 子词切分、共享权重 | 未裁剪低频词、维度不匹配 |
| 优化器 | Adam 系、warmup 加平方根倒数衰减 | 直接用固定学习率 |
| 损失与掩码 | 填充位不算损失 | 忘记掩码导致填充词主导训练 |
| 解码策略 | 按场景选贪婪、束搜索或采样 | 生成任务用贪婪导致复读 |
本章是从「懂原理」到「能落地」的桥:4.1 管数据怎么进模型,4.2 管模型怎么学会,4.3 管学会后怎么用,4.4 管别人已经造好的轮子怎么借。前三节自己走一遍哪怕极小规模,比只读十遍都有用;第四节则提醒你——生产中百分之九十的场景,不该从零造起。