2.1 自注意力机制
2.1 自注意力机制
本节摘要:自注意力(Self-Attention)是 Transformer 的核心创新:序列内部每个位置同时作为查询、键、值的来源,通过一次全序列的矩阵运算,让每个词的新表示成为全序列的加权组合,权重由内容相关性决定。本节先建立"序列内部信息交换"的直觉,再逐步追踪六步计算的矩阵形状变化,接着用代词消解实例解读注意力权重的语义,最后讨论权重的解释边界与工程代价。掌握本节,多头注意力与解码器掩码都只是它的编排变体。
核心问题
阅读完本节,你应当能够:
- 说明"自"注意力的"自"指 QKV 同源,并区分它与交叉注意力;
- 按矩阵形状追踪六步计算,从输入到输出说出每步形状;
- 解释点积打分、缩放、softmax 三步各自的物理含义;
- 用注意力热力图解读模型的指代消解行为;
- 陈述自注意力的平方复杂度代价与权重解释的边界。
一、直觉:一句话内部的信息交换
先摆清楚对象。1.3 节已经把注意力内核讲透:查询匹配键、按权重取值。自注意力只是把内核对准序列自身——查询、键、值全部来自同一条序列的同一层表示,每个词既向全句提问,也被全句提问。
为什么这值得单独拿出来讲?因为它是"词义由上下文决定"这一语言学常识的数学实现。"打"在"打车"与"打铁"里含义不同,静态词向量给不出区分,自注意力让每个"打"的新表示都吸收了各自邻居的信息,语境由此进入表示。更深一层:这不是词级别的查字典,而是层间迭代的精炼——每经过一层,每个位置对全句的理解就再深一步,六层堆叠后,句法与语义结构逐级浮现。
与交叉注意力对照能看得更清:交叉注意力的查询来自解码器、键值来自编码器,是"两个序列之间的信息交换";自注意力是"一个序列内部的信息交换"。编码器用前者,解码器两种都用。
二、六步计算:形状跟着走
设序列长度 n,模型维度 d_model。逐步骤追踪矩阵形状,是检验理解最硬的办法。
第一步,投影生成三矩阵。输入表示矩阵形状为 n 行 d_model 列,分别右乘三个投影矩阵,得到查询、键、值三个矩阵。单头情形下三者通常同维。这一步已把"每个词的三重身份"准备好:一行一个位置,行内的向量分别是它发出的查询、它挂出的键、它提供的内容。
第二步,点积打分。查询矩阵乘以键矩阵的转置,得到 n 行 n 列的分数矩阵。行对应发问的位置,列对应被问的位置,每个元素是一对查询与键的匹配分。整步是一次矩阵乘法,全序列的配对打分同时完成。
第三步,缩放。分数矩阵每个元素除以键维度 d_k 的平方根。回顾 1.3 节的分析:高维点积方差随维度线性膨胀,不缩放会让 softmax 饱和、梯度趋零。
第四步,可选的掩码。在 softmax 之前,把不该被看见的位置(解码器中的未来位置、批处理中的填充位置)的分数改写成一个极大的负数。softmax 之后这些位置的权重自然归零。掩码是第 3 章解码器的关键机关,此处先记下"掩码作用在 softmax 之前"这一时点。
第五步,softmax 归一化。对分数矩阵逐行做 softmax,每行成为一组非负、和为一的权重。第 i 行是第 i 个位置的注意力预算在全序列上的分配方案。
第六步,加权求和。权重矩阵乘以值矩阵,得到 n 行的输出,形状回到与输入一致。每个位置的新表示,是全序列值向量按其注意力预算的加权和。
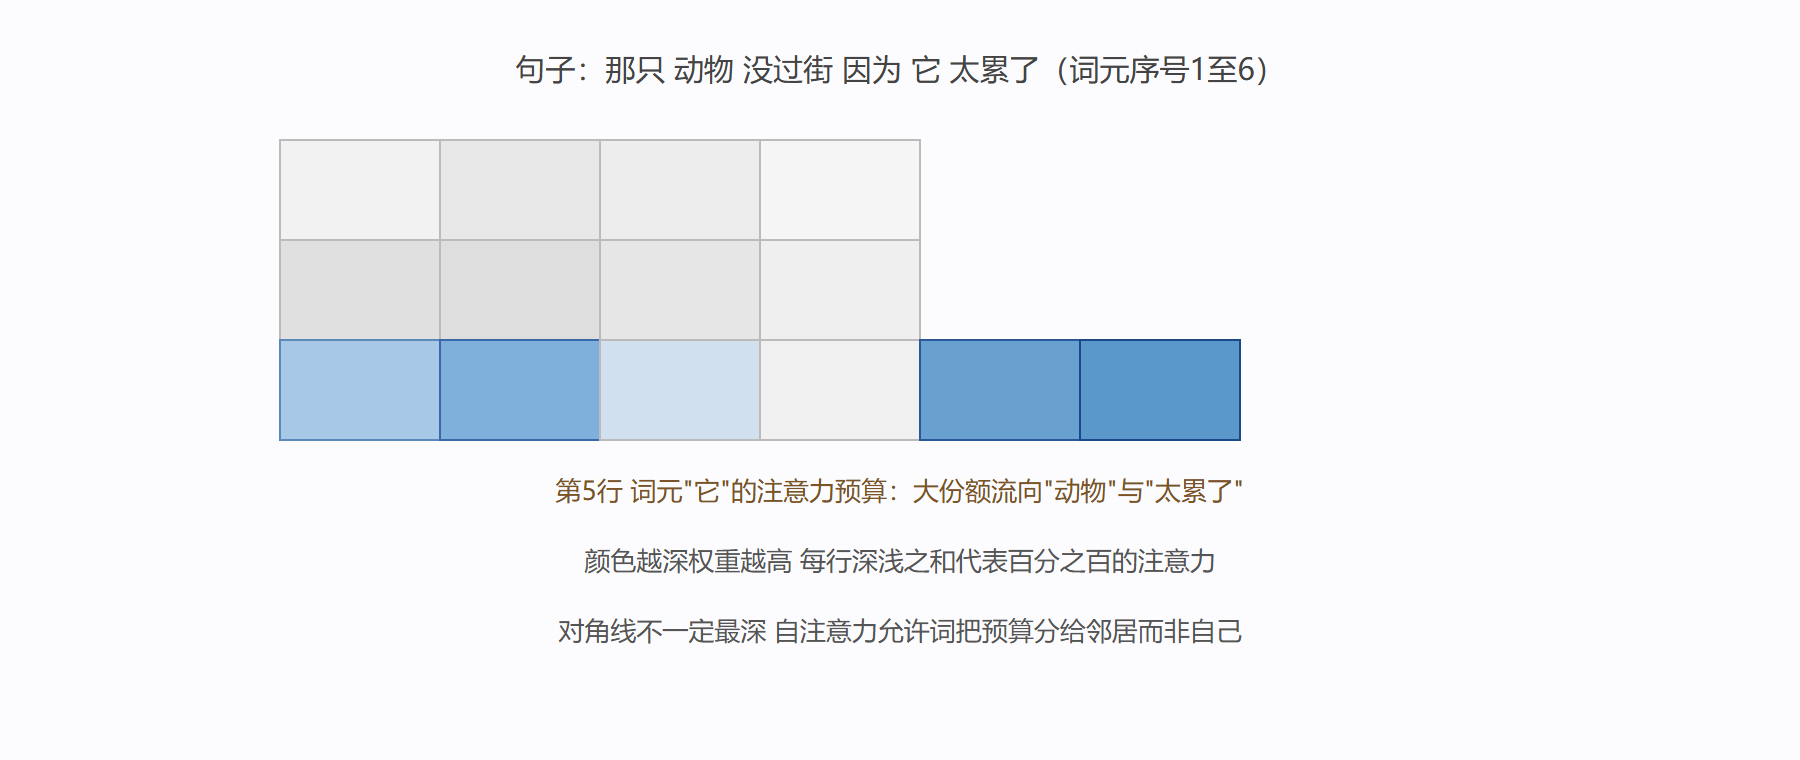
注意力权重矩阵热力示意
三、读一个实例:代词消解
拿源材料里的经典例子细看。"那只动物没过街,因为它太累了",处理到"它"时,模型学到的投影让"它"的查询与"动物"的键高度匹配——两者在训练中反复共现于指代关系;同时"太累了"的键也拿到可观分数,因为疲劳的语义主体是动物。softmax 后,"它"的输出表示主要由这两个位置的值向量加权构成,指代信息就位。
换一个尾巴:"因为街面太宽了",同样的查询此刻与"街"的键匹配更高,"它"的表示随之改写。注意投影矩阵是固定的,变的是各词表示的内容与其匹配结果——这正是"软检索"相对于规则系统的灵活之处。
训练怎么学会这套匹配?靠梯度。指代判断错误会在下游任务(如翻译)产生损失,反传的梯度推动三个投影矩阵调整,让正确的查询键配对在今后得到更高分数。百万句语料磨下来,投影矩阵就沉淀出语言的搭配规律。
四、解释的边界与工程的账
注意力热力图是分析利器,但要守住两条边界。其一,权重高不等于因果:模型可能只是相关性上的巧合匹配,多层网络里任何单一层的热力图都不能单独定论。其二,多头汇总问题:实际模型有多个头,各头模式不同,只看一个头容易误读。学界对"注意力是否可信的解释"一直有争论,稳妥的态度是把热力图当探索工具,结论需要其他证据交叉验证。
工程账方面,核心数字是 n 乘 n 的分数矩阵:序列长度一千时是一百万个元素,一万时是一亿。显存占用同样随平方增长,批处理大、序列长时往往先爆显存再爆算力。缓解手段包括分块计算、稀疏或近似注意力,思路都是少算或不算那些注意力预算注定很小的位置对。
⚠️ 常见坑:初学者实现时常忘记缩放因子,或把掩码放在 softmax 之后。前者在维度较大时表现为训练前期损失下降缓慢,后者会直接把"屏蔽"变成"置零后重新归一化",掩码形同虚设。排查时先检查这两处。
💡 动手建议:取三五个词的迷你句子,手算一遍六步流程,包括 softmax。算过一遍,"每个词读完全句"就不再是口号而是你亲手验证过的事实。
五、动手算一遍迷你例子
纸上算一个三词序列,胜过读十遍流程描述。设模型维度为四(仅为手算方便),三个词的输入向量分别为词一、词二、词三;随意设定三组投影矩阵后得到三套查询、键、值。计算查询一与三个键的点积,得三个原始分数,假定为二点一、零点四、负零点三;键维度为四,平方根为二,缩放后为一点零五、零点二、负零点一五;逐个取指数再归一,权重约为零点六七、零点二一、零点一二;用这组权重对三个值向量加权求和,得到词一的输出——它由自己贡献三分之二、其余两词分摊剩余。
这个例子虽然数字是编的,但揭示了两件事。其一,权重行天然含"自关注"项——词一给自己的权重往往不小,因为查询与键出自同一输入的投影,相关性有底薪;所以热力图对角线偏深属正常,模型并未犯错。其二,改变词三的输入向量,词一的输出随之改变——尽管词一自己没变,这就是"表示随全句流动"的最小验证。
六、延伸问题三则
自注意力和图神经网络有什么关系?
形式上,自注意力可看作在完全图上做消息传递:每个节点(词)向所有节点发送消息,按边权(注意力权重)聚合。区别在边权是动态算出的而非预定义,且注意力权重每层每头都不同。这个视角对跨领域读者很有帮助——图背景的工程师可以把 Transformer 理解为"边权可学习的全连接图网络"。
序列里加入特殊符号(起始符、结束符、分隔符)会怎样?
它们像普通词一样获得查询、键、值,参与注意力计算。训练中模型学会把它们用作"信息集散地"——例如分类任务常用的池化符,训练后各词的注意力大量汇聚到它身上,它的最终表示因此浓缩全句语义,直接接分类头即可。特殊符不是语法糖,而是可学习的聚合节点。
自注意力的输出会不会"过滑"?
会,这是一个真实的现象。加权平均天然趋向平滑,若注意力权重分布过于均匀,各位置的输出趋同,表示的差异性被抹掉。缓解手段一是多头(不同头关注不同子集,避免全员平均),二是残差连接(原输入直通输出,保住差异性底盘),三是深层堆叠(每层在上一层的差异化输出上继续加工)。三个手段都在第 2 章后续与第 3 章出现,此处先把问题立起来。
自注意力为什么适合做"注意力可视化"的分析?
因为它的权重矩阵直接就是一张"谁看谁"的完整记录:n 乘 n 个数值,行是查询、列是被查,天然可画成热力图。卷积的感受野分析、RNN 的隐藏状态分析都拿不到这种逐对记录。分析时要连着看多层多头——浅层局部、深层长程的模式差异本身就是理解模型行为的重要证据。但要守住 2.1 节正文的告诫:模式描述相关性,不担保因果,跨层交叉印证后才可下谨慎结论。
本章回顾
- "自"即同源:查询、键、值来自同一序列,实现序列内部的信息交换;
- 六步流程:投影、点积、缩放、可选掩码、softmax、加权求和,输出形状与输入一致;
- 一次矩阵乘完成打分:全序列配对同时算完,并行性由此而来;
- 掩码时点在 softmax 之前:把禁区分数改为极大负数,归一化后权重归零;
- 语境进入表示:代词消解等行为在单次注意力内完成,多层堆叠则逐级精炼;
- 热力图是探索工具:不能单独作为因果解释,多头与多层都需交叉验证;
- 平方复杂度是根本代价:长序列下显存与计算同时承压,催生稀疏化研究方向。
单头自注意力一次只能学一种匹配模式。下一节看多头如何让模型同时用多副眼镜看同一句话。
常见疑问
问:缩放因子除以根号 d_k 到底防的是什么?
答:防点积过大导致 softmax 饱和。向量维度越高,两向量点积的方差越大,原始分数动辄几十,softmax 一算就变成接近 one-hot 的尖锐分布——梯度趋零,训练停滞。除以根号 d_k 恰好把方差拉回单位量级,softmax 保持在梯度健康的平缓区。这个不起眼的一步是原论文能训得动的关键细节之一。
问:一句话里每个词都看所有词,包括无关词,不浪费吗?
答:浪费与鲁棒是同一枚硬币的两面。全连接式的注意力确实计算了大量低相关词对,但 softmax 会自动把权重压向相关词,无关对的贡献趋近零——代价是算力,换来的是不依赖任何人为设定的连接结构,让模型自己学会「该看谁」。后来的稀疏注意力研究(只算部分词对)就是在这个浪费上做优化,属于后话。
三步计算速查表
| 步骤 | 运算 | 形状变化(句长 n、维度 d) | 要点 |
|---|---|---|---|
| 打分 | Q 乘 K 转置 | n×n 的分数矩阵 | 每对词得到一个原始相关分 |
| 缩放 | 除以根号 d_k | 形状不变 | 把方差拉回单位级防饱和 |
| 归一加权 | softmax 后乘 V | n×d 的输出矩阵 | 每行权重和为一,加权汇合信息 |
这张表是自注意力的全部计算骨架——三个形状变化记住了,调试时的维度对错一眼可辨:中间矩阵必须是方阵(n×n),不是方阵就说明 Q 与 K 的来源维度没对齐。