第2章 核心组件:把抽象机制讲透
章节摘要:本章是全书的重心,也是"概念筑基"路线的执行现场。我们把 Transformer 拆成五个独立组件——自注意力、多头注意力、位置编码、前馈网络、残差连接与层归一化——逐个当作孤立的数学对象来剖析:它解决什么问题、内部怎么算、参数怎么取、有什么坑。刻意不谈整体架构,是为了让读者在组装之前先看清每个零件的受力方向。读完本章,第 3 章的架构图对你而言将不再是迷宫,而是五个熟人的一次合影。
读前必看
阅读完本章,你应当能够:
- 独立推演自注意力的六步计算流程,并指出每步输出矩阵的形状变化;
- 解释多头注意力中"投影到低维再拼接"的参数设计,说明它为何不比单头更贵;
- 描述正弦位置编码的构造方式,以及它能表达相对位置的原因;
- 说出前馈网络"先升维再降维"的设计意图与位置间参数共享的含义;
- 区分层归一化与批量归一化,解释残差连接对深层训练的意义;
- 判断一个具体问题(如序列过长、训练发散)该从哪个组件入手排查。
核心概念速览
注意力负责"词与词交流",前馈网络负责"每个词自己消化",位置编码负责"记住谁在前谁在后",残差与归一化负责"让这一切在几十层深处仍然成立"。
五大组件分工透视
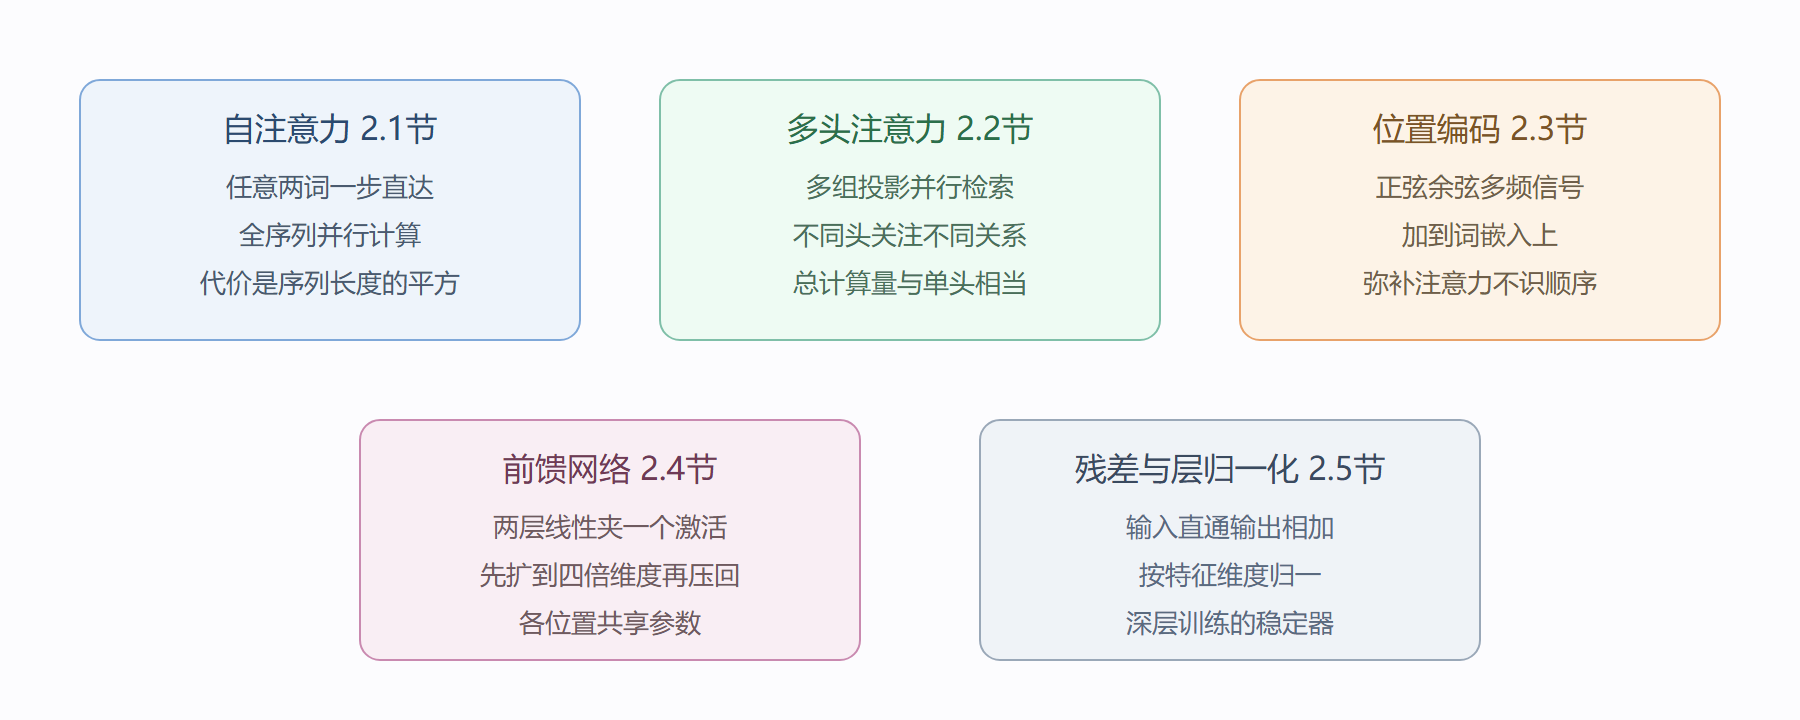
子章节导航
2.1 自注意力机制
从"一个词如何吸收全句信息"出发,走完线性变换、点积打分、缩放、softmax、加权求和的完整流程,并用代词消解的例子展示注意力权重的语义解释力。
2.2 多头注意力机制
回答"为什么要多个头":单个注意力只能学一种对齐模式,多个头在不同子空间各自检索,有的盯句法、有的盯语义。还会算一笔参数账,澄清"多头并不比单头贵"的常见误解。
2.3 位置编码
自注意力本身对顺序无感,"狗咬人"与"人咬狗"在它眼里一样。正弦位置编码用一组不同频率的波,把绝对位置编进向量,又因三角恒等式的性质天然支持相对位置推理。
2.4 前馈神经网络
注意力之后的"消化"环节:每个位置的向量独立通过同一个两层网络,先升维到四倍、经激活函数、再降回原维。它是 Transformer 参数量的主要存放地。
2.5 残差连接与层归一化
借鉴 ResNet 的旁路让梯度直达深层,层归一化按特征维度稳定分布。两者组成"Add & Norm",是深层 Transformer 能训得动的先决条件。
子章节之间的逻辑关系
一句话论点:五节分别处理"交流、多视角、顺序、消化、稳定"五个正交问题,缺一则整机不可运转。
位置编码(2.3) ──加到输入──> 自注意力(2.1) ──扩展──> 多头(2.2) | v 前馈网络(2.4) 逐位置加工 | v 残差与归一化(2.5) 包住以上所有子层
阅读顺序上,2.1 与 2.2 必须连读,2.3 依赖 2.1 的"顺序无感"结论,2.4 与 2.5 相对独立,可按需插读。原论文中编码器与解码器各堆叠六层,每层内部正是"注意力、前馈、两个 Add & Norm"的固定组合——第 3 章将把这个组合装回整机。
本章常见问题
五个组件里哪个最重要?
自注意力是不可替代的核心,其余四个更像"保障系统"。但没有保障系统的核心跑不起来:去掉位置编码,模型分不清词序;去掉前馈网络,多层堆叠退化为线性变换;去掉残差与归一化,六层深网根本训不动。我的建议是把学习时间的四成分给自注意力与多头,三成分给位置编码,剩下的分给后两节——权重反映的是理解难度,而非重要性排序。
本章不看架构图,会不会与第3章脱节?
不会,反而是有意为之。第 3 章的架构图一旦缺乏组件级的理解,就只剩名词排列;先在第 2 章把每个零件的输入输出形状、参数位置、常见故障摸清,第 3 章的组装内容读起来是"水到渠成"而非"重新开始"。读完本章可以直接做一个小验证:找原始论文的架构图,尝试标注每个方框对应本章哪一节——全部标注得出,说明零件课结业。
组件之间有没有依赖顺序?
2.1 与 2.2 强依赖(多头是自注意力的扩展),2.3 依赖 2.1 的"顺序无感"结论,2.4 与 2.5 相对独立。时间紧张时的最短路径是 2.1 加 2.2 加 2.5:前两节管核心机制,最后一节管训练稳定性,这三块是读懂现代开源实现的最小知识集。
前置知识与后续延伸
- 前置:第 1 章的 Query、Key、Value 检索模型与缩放点积流程;softmax 的基本性质;矩阵乘法与形状追踪习惯。
- 为后续铺垫:2.1 节的掩码变体是第 3 章解码器"掩码自注意力"的直接前置;2.2 节的交叉注意力用法在 3.3 节展开;2.3 节的位置编码方案在第 4 章 4.1 节输入流水线中会以工程形态重现;2.5 节的 Pre-Norm 与 Post-Norm 之争则是 4.4 节阅读开源实现时的背景知识。
一个自测:合上书,试着向同事解释"为什么多头注意力每个头要先投影到低维空间"。如果答案里包含"控制总计算量并让各头关注不同子空间",本章就算读到位了。
组件速查表
| 组件 | 一句话职责 | 拿掉会怎样 |
|---|---|---|
| 自注意力 | 词与词两两交换信息 | 每个词成信息孤岛 |
| 多头注意力 | 多组注意力各盯一面 | 理解扁平,缺多视角 |
| 位置编码 | 给无序的注意力注入顺序 | 词袋模型,语序失效 |
| 前馈网络 | 逐位置独立做非线性变换 | 表达力骤降,只剩加权平均 |
| 残差与归一化 | 保通路、稳数值 | 深层网络无法训练 |
本章五个组件的顺序就是理解的顺序:先懂信息怎么流动(注意力),再懂怎么多角度流动(多头),然后补上流动所缺的顺序信息(位置),最后是让信息被加工(前馈)与让网络可堆深(残差归一化)。每个组件都值得问一句「拿掉它行不行」——答案都是不行,而理由就是你对它的最终理解。