2.5 残差连接与层归一化
2.5 残差连接与层归一化
本节摘要:残差连接把每个子层的输入直接加到其输出上,为梯度提供旁路,使深层网络可训;层归一化对每个样本沿特征维度做标准化,稳定各层输入分布,且不受批大小与序列长度影响。二者在 Transformer 中组合为"Add & Norm"结构,包裹住每一个注意力与前馈子层,是六层乃至几十层堆叠能够稳定训练的先决条件。本节讲清两者的机理、层归一化与批量归一化的区别、Pre-Norm 与 Post-Norm 的布局之争,以及实践中的注意点。
本节导航
阅读完本节,你应当能够:
- 解释残差连接如何缓解梯度消失、允许深层堆叠;
- 描述层归一化的计算方式及其与批量归一化的本质区别;
- 说明 Add & Norm 在 Transformer 每层中的包裹位置;
- 对比 Post-Norm 与 Pre-Norm 两种布局的训练特性;
- 列举实践中与归一化相关的常见故障与排查思路。
一、残差连接:给梯度修一条旁路
问题从深度来。Transformer 堆叠多层,反向传播时梯度要逐层回传,每过一层都要乘上该层的权重——连乘之下,梯度极易消失或爆炸。层数越多,问题越尖锐:不是模型不想深,是训练信号到不了深处。
残差连接的解法来自 ResNet 的洞见:与其让每层学"完整的目标表示",不如让它学"对输入的修正量"。具体到 Transformer:子层(注意力或前馈)算出输出后,不直接采用,而是把子层输入原样加回——输出等于输入加子层修正。这样每层只需学一个增量,学不动时增量为零,数据原样通过,网络深度不再伤害下限。
对梯度而言,这条加法旁路是高速公路:求导时输入项的导数恒含一个"加一",信号无须经过任何权重连乘就能直抵浅层。深层的训练信号由此保持健康。另一个更微妙的好处是信息保真——2.3 节提过,位置编码在输入端注入后,正是靠残差通路逐层无损传递,模型最深处仍能读到最初的信号。
二、层归一化:按特征维度归一
残差解决了"能不能训深",层归一化解决"训得稳不稳"。神经网络各层的输入分布会随训练漂移,漂移过大时损失曲面变得崎岖,学习率稍大就震荡。归一化的思路是把分布拉回稳定区间。
为什么选层归一化而不是更早出名的批量归一化?区别在统计的维度。批量归一化跨样本、按特征统计,需要一批样本的均值方差——这对序列模型有两个麻烦:其一,统计依赖批大小,小批量时估计噪声大;其二,同一批内序列长短不一时,按批统计要在变长的位置维度上对齐,别扭且低效。层归一化改在每个样本内部、沿特征维度统计:一个位置向量的各维度算均值方差,自己归一自己。统计与批无关、与序列长度无关,天然适配变长序列与推理时的单样本场景。归一化后配有可学习的缩放与偏移参数,让模型自己决定"归一化到什么程度"。
💡 一个常被忽略的对比点:批量归一化在训练与推理时行为不同(推理用移动平均统计),层归一化训练推理完全一致——工程上少一类"训练好、上线歪"的坑。
Add 与 Norm 的包裹结构
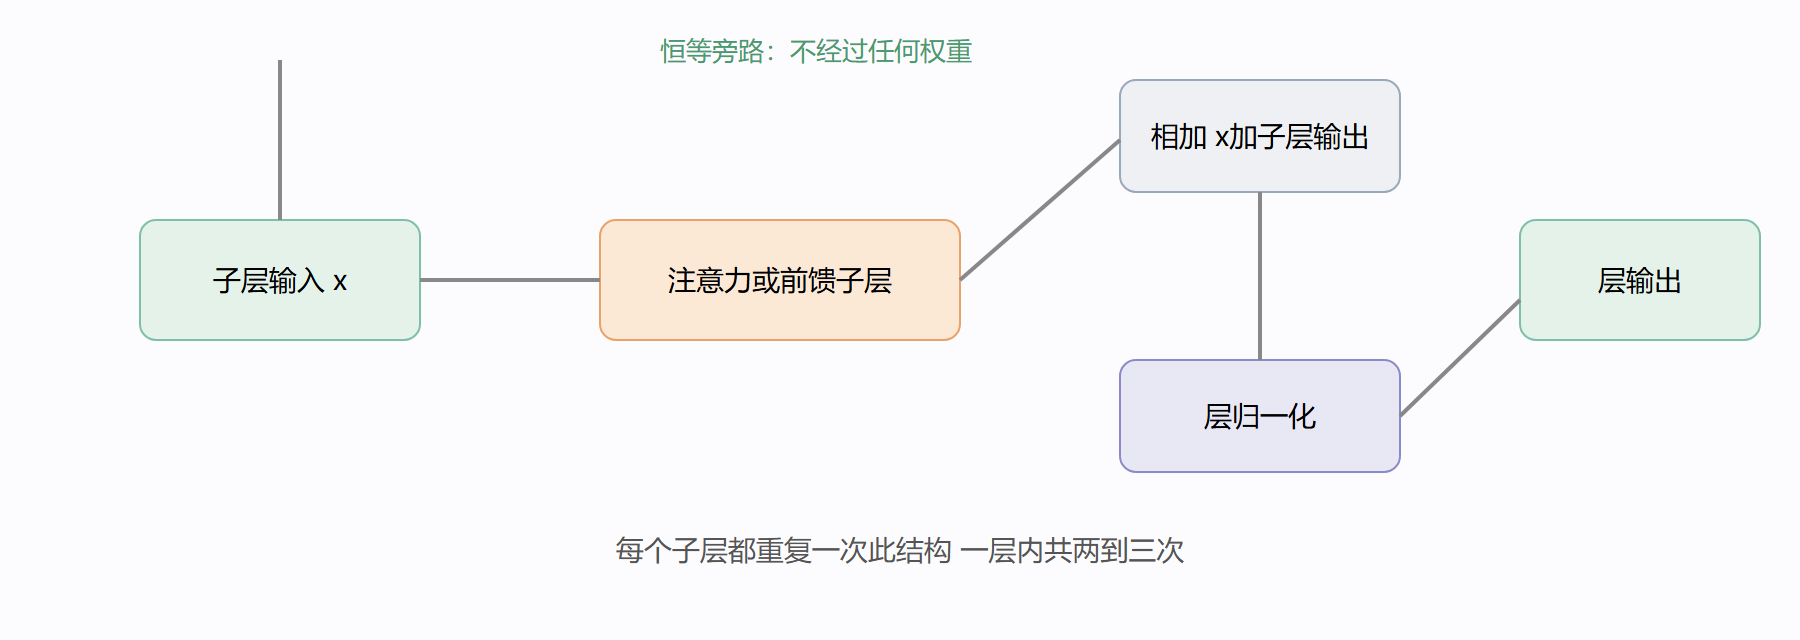
三、Add & Norm:包裹每个子层
原论文把两者打包成固定搭配:每个子层的最终输出,是"输入加子层输出"再做层归一化。编码器层的两个子层(多头自注意力、前馈)各包一次;解码器层三个子层各包一次。图示上熟悉的"Add & Norm"方框即由此而来。
值得强调二者不可互换职责:只有残差没有归一,分布漂移会让深层训练失稳;只有归一没有残差,梯度旁路消失,深层的信号仍会衰减。它们是一对配套工程,名字排在同一个方框里并非偶然。
层归一化的计算细节:对单个位置向量,先算各维度的均值与方差,把向量标准化为零均值单位方差(分母加一个极小常数防除零),再逐维乘可学习缩放、加可学习偏移。全部运算只涉及该位置自身,一个矩阵的每一行独立完成——与 2.4 节前馈网络的"逐位置"哲学一脉相承。
四、Pre-Norm 与 Post-Norm 之争
原论文的顺序是先相加后归一(Post-Norm):归一化作用在残差求和之后。后续实践发现,这种布局在层数加深(比如几十层以上)时训练稳定性下降,需要谨慎的 warmup 与初始化配合(第 4 章 4.2 节的 warmup 调度,部分正是为它服务)。于是出现了先归一后求和的 Pre-Norm:子层吃归一化的输入,输出直接加回未经归一的残差流。
两种布局的特性对比鲜明。Post-Norm 理论表达力略强(每层输出都被归一约束),但深网训练娇气;Pre-Norm 让残差流全程无阻,梯度通畅,深层训练稳定得多,代价是有效深度可能略打折。现代大规模模型几乎清一色采用 Pre-Norm 或其变体(如在残差流上再做一次缩放的做法)。选型经验:小模型复现论文用 Post-Norm 无妨,从零训练深模型直接上 Pre-Norm,少走弯路。
| 维度 | Post-Norm 原论文式 | Pre-Norm 现代主流式 |
|---|---|---|
| 归一化位置 | 残差求和之后 | 子层输入之前 |
| 残差流 | 每层被归一化打断 | 全程无阻直达 |
| 深层训练稳定性 | 娇气 依赖warmup | 稳定 |
| 表达能力 | 略强 | 略受限 |
| 典型使用者 | 原始Transformer | 近年大模型 |
⚠️ 排查提示:训练中出现损失突涨或变零星,先查三处——残差有没有接错(旁路必须恒等,不能顺手做个投影)、归一化维度有没有搞错(应沿特征维而非批维)、学习率是否与布局匹配(Post-Norm 对 warmup 更敏感)。这三处覆盖了实践中绝大多数"莫名发散"的根因。
五、小结前的全局视角
至此第 2 章五个组件集齐。拼装逻辑可以一句话复述:位置编码给表示别上座次牌(2.3),多头注意力让全体位置多视角交换信息(2.1 与 2.2),前馈网络逐位置消化(2.4),Add & Norm 把每个子层包好、让堆叠稳定(2.5)。第 3 章要做的事情只剩一件:把这套子层按编码器、解码器两种配方装进六层高的塔里。
💡 复习建议:拿一张白纸,凭记忆画出一个子层完整的 Add & Norm 包裹结构,标注数据流向与形状。能一遍画对,本章的工程细节就算落袋。
六、训练稳定性的一手经验
把残差与归一化放进真实训练场景,有几条值得记录的观察。
第一,初始化与残差的配合。深层堆叠时,若各子层输出的初始幅度偏大,相加后残差流的方差逐层膨胀,训练开局即失稳。常见对策是对残差分支的输出乘一个小于一的缩放因子(按深度递减),把开局幅度压住。这类细节论文正文常一笔带过,却是复现成败的分水岭——读开源实现时留意初始化部分的缩放代码。
第二,归一化超参的敏感性出乎意料地低。层归一化的可学习缩放与偏移初始为一与零,训练中自然更新,几乎不需要调参;相比之下位置、顺序这类结构选择的影响大得多。给调参预算有限者的排序:先定布局(Pre 或 Post),再定 warmup,归一化内部参数交给默认值。
第三,一个诊断小技巧:训练中定期记录残差流(每层输出)的范数。健康训练的范数应当平缓增长或稳定;若某层范数突然跳变,问题多半出在该层附近——注意力还是前馈、权重还是归一化,顺着范数异常的层二分排查,比盲改超参快一个数量级。这个方法不依赖任何额外工具,纯靠日志即可执行。
与其他归一化方案的简短对照
除层归一化外,后续研究还提出过按批归一化的改良、以及按位置维度归一的变体(对序列模型的某些配置更稳)。核心结论保持稳定:归一化的维度选择要与数据形态匹配——变长序列与逐位置处理为主的 Transformer 家族,层归一化仍是最稳妥的默认。除非复现特定论文,不必追新方案。
💡 白板检验升级版:在 2.5 节复习建议的那张图基础上,再补画 Pre-Norm 版本——归一化移到子层入口、残差流无阻直通。两版并列画出并能说清差异的读者,已经具备阅读任何现代开源实现注意力块源码的结构准备。
残差流到底是什么,为什么大家反复提这个词?
把每层输出记为"输入加子层修正",逐层展开后可以发现:最顶层的输出等于最初输入加上沿途所有子层修正的总和——这条未经修改、一路直通的总线就叫残差流。位置编码随它抵达各层,梯度沿它反传回浅层,模型最终输出是"原始信号加全部修正"的叠加态。现代架构讨论(如对各层修正幅度的分析、残差流缩放技巧)都建立在这个视角上。把残差理解成"流"而不是"一根跳线",是从入门到进阶的概念分水岭。
一节小结
- 残差让深度可行:子层学增量而非全量,加法旁路给梯度修高速公路;
- 信息保真 bonus:位置编码等输入端信号靠残差通路逐层无损传递;
- 层归一化的维度选择:逐样本、沿特征维统计,与批大小和序列长度解耦,训练推理一致;
- 固定搭配 Add & Norm:每个注意力与前馈子层都被包裹,编码器每层两次、解码器每层三次;
- 配套不可拆:残差管梯度通路,归一管分布稳定,职责互补;
- 布局之争:Post-Norm 表达略强但训练娇气,Pre-Norm 深层稳定,成为现代大模型主流;
- 故障三查:旁路恒等性、归一化维度、学习率与布局匹配。
零件备齐,下一章上装配线:先看编码器与解码器的整体协作,再逐个拆解两种塔的内部构造。
常见疑问
问:残差连接为什么能支撑起深层网络的训练?
答:它给梯度修了一条高速公路。没有残差时,梯度要穿过每一层的变换才能回到浅层,链式法则连乘之下要么消失要么爆炸;有了残差,恒等映射让梯度可以「原样直通」,深层的误差信号无衰减地抵达每一层。直观比喻:每层不再被要求「改写全部信息」,只需「在原有基础上提增量修改」——改错了,原信息还在。
问:Pre-Norm 和 Post-Norm 有什么实际差别?
答:原论文是 Post-Norm(归一化在残差相加之后),表达力略强但深网络训练不稳,需要精心热身;当代大模型普遍改用 Pre-Norm(归一化移到子层之前),训练稳定得多,几十上百层也不炸。工程口诀:小模型追求极致效果可试 Post-Norm 配精细调度,大模型默认 Pre-Norm 求稳。这个细节的迁移史本身就是深度学习「稳定性压倒一切」哲学的缩影。