4.4 开源框架与实践
4.4 开源框架与实践
本节摘要:从头实现并训练一个 Transformer 需要深厚的底层与分布式功底,而开源生态把这件事的门槛降到了应用工程师可及的高度。以 Hugging Face Transformers 为代表的框架提供统一的模型仓库、配套分词器、预训练权重与开箱即用的训练微调工具;模型家族按骨架分为编码器型(理解任务)、解码器型(生成任务)、编码解码型(翻译摘要)。本节梳理生态版图、预训练权重下载与微调的典型流程、模型选型的经验法则,并讨论"从零训练还是用预训练"的成本权衡。
上手前先明确
阅读完本节,你应当能够:
- 说出主流开源生态的分工:模型库、深度学习框架、分词与数据工具;
- 按骨架差异把预训练模型家族分成三类并匹配任务类型;
- 描述下载预训练模型并做推理与微调的典型流程要素;
- 说明微调与从零训练在数据、算力、人力上的量级差异;
- 给出一个具体任务下的模型选型思路。
一、生态版图:各管一段
现代 Transformer 实践的工具链是分层的。最底层是深度学习框架,负责自动求导与 GPU 调度,主流选择各有生态。中间层是模型库,其中事实标准是 Hugging Face 的 Transformers 库:它把上千个预训练模型封装成统一接口,配套的分词器、配置、权重托管在模型仓库平台上,几行调用即可完成加载与推理。周边还有数据集加载、训练循环封装、实验跟踪等配套项目,共同构成一条流水线。
对学习者的一个提醒:这类封装库的便利是把双刃剑。它让你不写一行注意力矩阵乘法就能跑通大模型,但也容易让人跳过原理直接堆调用。本教程把原理放在前面四章,正是希望你在用轮子的时候知道轮子里有什么——读得懂报错、调得动参数、遇得到坑知道往哪查。
另一类值得知道的生态是推理专用引擎:把训练好的模型转换格式、做算子融合与量化,专注把延迟与显存压下来,服务线上部署。训练用模型库、上线用推理引擎,是工程上的常见组合。
二、模型家族:三副骨架各就各位
模型仓库里的数千个模型,按骨架可归为三类,对应第 3 章的两塔组合方式。
编码器型:只取编码器堆栈,双向注意力看全句,预训练目标常为掩码语言模型(遮住部分词让模型还原)。擅长理解类任务——分类、抽取、语义匹配、检索。代表是 BERT 系列。
解码器型:只取解码器堆栈,因果掩码下自回归生成,预训练目标即预测下一词。擅长开放式生成——对话、写作、代码补全。代表是 GPT 系列,当今大语言模型的直系骨架。
编码解码型:保留完整两塔与交叉注意力,擅长有输入有输出的转换任务——翻译、摘要。代表是 T5。
| 家族 | 骨架 | 注意力方向 | 预训练目标 | 擅长任务 | 代表 |
|---|---|---|---|---|---|
| 编码器型 | 只编码器 | 双向 | 掩码还原 | 分类 抽取 匹配 | BERT系 |
| 解码器型 | 只解码器 | 单向因果 | 预测下一词 | 开放生成 | GPT系 |
| 编码解码型 | 两塔完整 | 内部双向加交叉因果 | 序列到序列 | 翻译 摘要 | T5系 |
选型的第一法则由此而来:先看任务形态(理解还是生成、有无源输入),再在对应家族里按数据规模与算力预算挑尺寸。理解任务用解码器大模型不是不行,而是杀鸡用牛刀;翻译任务用纯解码器模型则需要把源句拼进提示词,效果与效率都不如两塔结构直接。
三、典型工作流:从下载到微调
用模型库的典型流程分三步。第一步,加载:指定模型名,库自动下载权重、配置与分词器——4.1 节强调的"分词器与词表配套"由库代为保证。第二步,推理:分词、送入模型、按 4.3 节的解码策略生成或取表示,几行代码完成。第三步,微调:准备好任务数据(输入输出对),替换或追加任务头(比如分类头),在预训练权重基础上用较小学习率继续训练——损失计算与优化器配置即 4.2 节的内容。
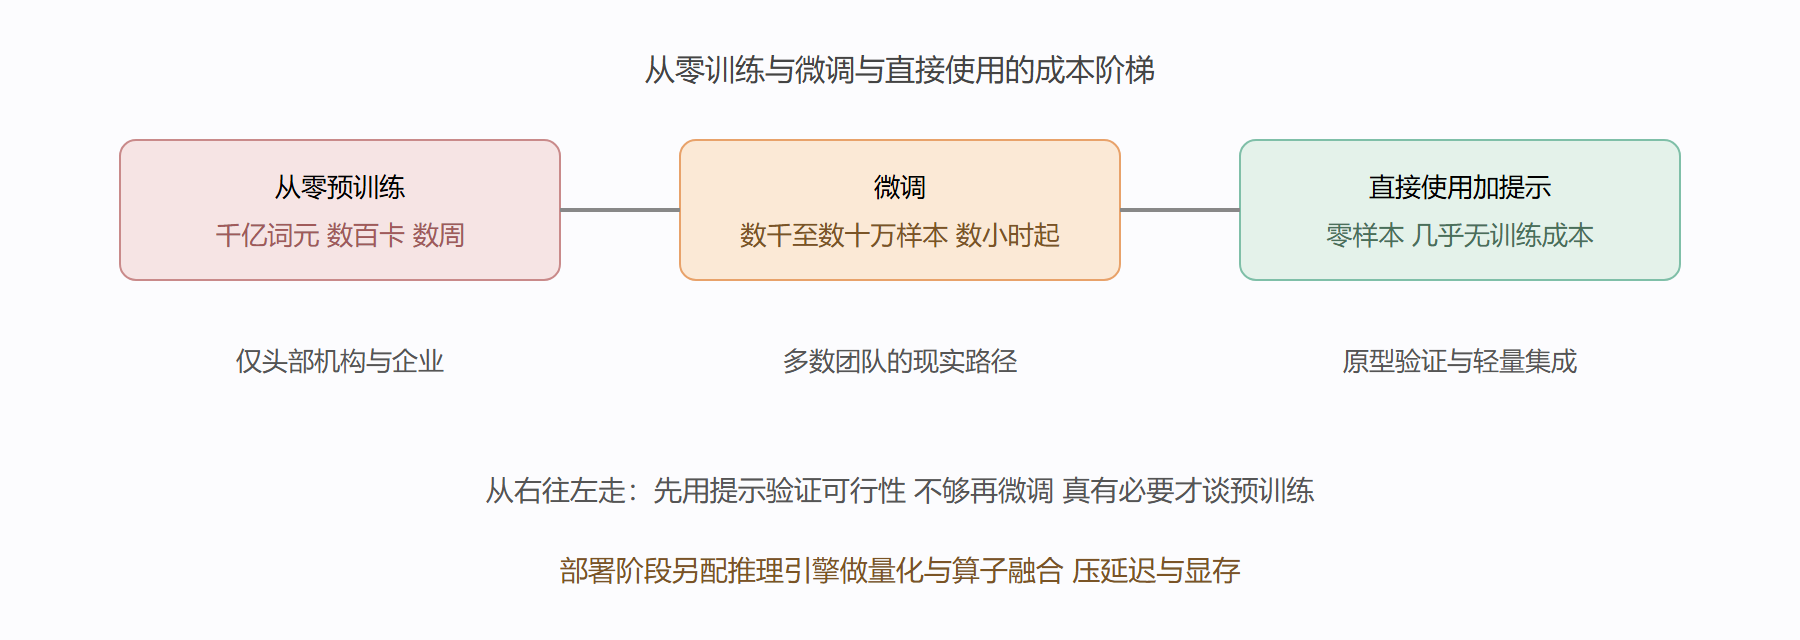
微调相对从零训练的优势是压倒性的。从零训练一个像样的语言模型,需要数千亿词元的清洗语料、数百块加速卡运行数周、以及一支懂分布式训练的团队——这三样对绝大多数团队都是不现实的。微调只需任务相关的几千到几十万条样本、单卡到几卡数小时到数天,预训练阶段学到的通用语言能力直接继承。参数高效微调更进一步:冻结主干、只训练少量附加参数,让消费级显卡也能定制十亿级模型。
实践路径决策图补充说明
四、实践中的取舍与坑
选尺寸的量级感:理解任务的轻量场景,亿级参数的编码器模型足够;严肃的生成任务至少数十亿级起步,效果与成本的拐点因任务而异,建议从小尺寸起步测通流程,再放大。上下文长度是另一个预算项——4.3 节的平方复杂度在长输入下同时吃显存与延迟,长文档场景优先选支持长上下文的模型变体而非硬扛。
微调的常见坑延续前几节的线索:学习率照搬预训练的大值会把预训练权重冲坏(微调常用预训练十分之一以下的量级,且仍建议短 warmup);任务数据分布与预训练语料差异过大时,分阶段微调(先领域语料继续预训练、再任务微调)常比一步到位稳;评估别只看单一指标,生成任务务必人工抽查样例——自动指标与人的体感有系统性偏差。
⚠️ 还有一条容易忽视的工程线:模型与分词器的版本要对齐。生态迭代快,旧脚本配新库版本常出现权重键名对不上、分词行为微变等问题;团队协作时锁定版本号、记录模型指纹,是省下未来整周排查的一行配置。
💡 给学习者的收尾建议:把本教程的原理知识与一次真实的微调实践对上号——加载模型时想想嵌入矩阵的形状,配置生成参数时想想温度与核采样,训练脚本里找出 warmup 与裁剪的位置。原理与实践各走一遍,Transformer 这门课才算真正结课。
五、把教程知识映射到框架代码
用模型库加载一个编码器型模型做分类微调时,前四章的知识能逐一对应上:加载器按 4.1 节的流水线处理文本——分词、编号、嵌入加位置编码;配置里的层数、维度、头数对应 1.4 节的配置表;训练循环的损失、优化器、调度器参数即 4.2 节的内容,默认配置里能找到 warmup 与权重衰减;生成接口的温度、核采样阈值、束宽即 4.3 节的解码策略。建议做一次"源码寻宝":在框架的注意力模块里找到投影、打分、缩放、softmax 的调用位置,在训练工具里找到梯度裁剪的落点。寻宝完成,原理与工程之间的桥就通了。
团队引入 Transformer 能力的路线图
按投入从低到高分四档。第一档,直接调用托管接口:零模型资产,适合原型与低量级场景。第二档,下载开源权重自部署:数据不出内网,配推理引擎控制成本,适合有合规要求的业务。第三档,微调开源模型:任务数据沉淀为自身能力,效果上限更高。第四档,继续预训练或从零训练:仅当领域语言高度特殊(医嘱、法条、方言)且数据充足时考虑。绝大多数团队停在二、三档即够用——路线图的教训是别越级,每一档的能力没吃透就上探下一档,成本失控的概率远大于收益。
模型资产的工程化管理
权重文件动辄数 GB,版本混乱是常见事故源。基本纪律:模型标识(名称加版本)入库记录;下载缓存目录统一管理;微调产出的权重与训练配置、数据快照绑定存档。升级框架版本时用固定的小测试集回归验证——分词行为微变这类静默差异,只有回归测试能拦住。这些纪律不性感,但在模型资产成为生产核心资产的团队里,重要性不亚于代码管理。
⚠️ 最后一坑:开源权重的许可条款差异大,部分模型限制商用或要求署名,合规审查要放在技术选型之前。技术团队能扛住模型效果差,扛不住许可纠纷。
💡 全教程的收官行动项:挑一个与你工作相关的任务,走完"提示验证、微调、部署"的最短路径,并把每一步用到的教程章节记在实验日志里。这份日志将成为你评估自身理解盲区的最佳清单——哪里翻得最频繁,哪里就该回来重读。
核心回顾
- 生态分层:底层框架管求导调度,模型库管权重与接口,推理引擎管部署优化;
- 统一接口的价值:配套分词器与权重成对加载,从根上杜绝词表错配类故障;
- 三副骨架三类任务:编码器型管理解、解码器型管生成、两塔完整管翻译摘要;
- 选型第一法则:先按任务形态定家族,再按数据与算力选尺寸;
- 微调是现实路径:从零预训练要千亿词元与数百卡,微调只需任务数据与单卡数小时;
- 成本阶梯从右往左走:提示验证在前、微调居中、预训练殿后;
- 微调三坑:学习率冲坏权重、分布差异需分阶段、评估须人工抽查。
全教程到此收官。回头看第一章那张困境清单,希望你已能从注意力内核出发,一路推到训练与部署的每个细节——这才是"详解"二字的完成态。
常见疑问
问:Hugging Face 生态为什么能成为事实标准?
答:因为它把「模型+数据+代码」三件套标准化了:统一的模型仓库格式、一致的前后处理接口、几行代码就能下载推理的开箱体验。研究者的论文模型上传即复现,工程师的微调脚本换个模型名就能跑,生态飞轮由此转起来。学会它的核心抽象(分词器、模型、训练器三件套),等于拿到当代 NLP 工程的通用驾照。
问:从零手写一遍 Transformer 还有必要吗?
答:有必要,但目的要摆正——不是为了造轮子,而是为了暴露理解盲区。跟着教程手写一遍前向与训练循环,你会被迫直面每一个「以为懂了」的细节:掩码的形状、残差的位置、损失对谁求平均。写完之后再用框架,每个参数对你都不再是黑盒。顺序建议:先手写极小版本,再拥抱成熟生态,两个阶段缺一不可。