4.3 推理过程与解码策略
4.3 推理过程与解码策略
本节摘要:推理时模型以自回归方式逐词生成:编码器一次性处理源序列,解码器从起始符出发步步前向,每步得到词表概率分布,由解码策略选出词元接回输入,直至选出结束符或达到最大长度。选词策略决定输出的质量与性格:贪婪搜索每步取最优、快而易僵;束搜索保留 k 条候选序列、整体更优但保守;温度采样调分布形状;Top-k 截断长尾;核采样按累积概率自适应收缩候选集。本节讲清推理循环的机械流程与缓存优化,并逐个分析五类策略的适用场景。
本节地图
阅读完本节,你应当能够:
- 按步骤描述自回归生成的完整循环及终止条件;
- 说明键值缓存在推理加速中的作用;
- 对比贪婪搜索与束搜索的机制、优劣及 k 值权衡;
- 解释温度参数如何改变分布形状及高低温的行为差异;
- 区分 Top-k 与核采样(Top-p)的截断准则,说明各自适用场景。
一、自回归循环:一步一步写
推理的机械流程在 3.1 节铺垫过,这里走细。第一步,编码器处理源序列,产出上下文表示——整个生成过程只算这一次。第二步,解码器输入仅含起始符,前向得到第一个词表分布。第三步,解码策略从分布中选出词元,拼进已生成序列。第四步,新的输入再前向,得到下一个分布。循环三四两步,直到选出结束符或触发最大长度上限。终止靠模型自己学会输出的结束符(3.3 节),长度上限是兜底保险,防个别样本无限生成。
工程上最重要的优化是键值缓存:解码器每层的自注意力与交叉注意力都要用到历史位置的键与值向量,这些向量一经计算便不再改变——逐步生成时只需为新位置计算增量,历史部分直接查缓存。没有缓存时每步都重算全序列,生成一百词的计算量浪费近五十倍;有缓存后每步开销近恒定。交叉注意力的键值来自编码器,更是在循环开始前就备好。
二、确定性策略:贪婪与束搜索
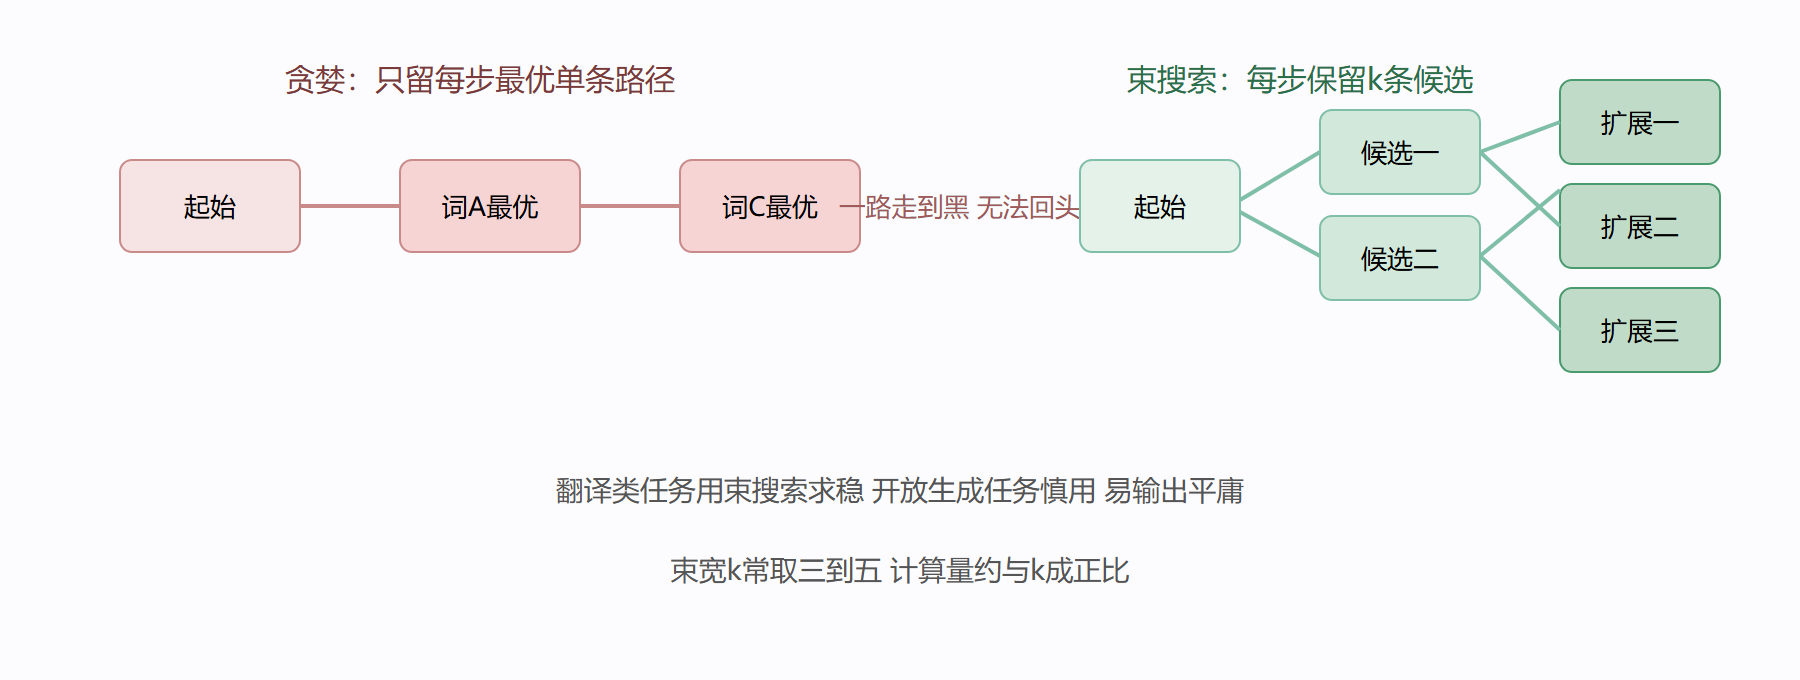
贪婪搜索:每步选概率最高的词元。实现一行,速度最快。缺陷在短视:第一步的次优选择会让后续步步被动,因为每步只在当前分布上取局部最优,无法回头。适合对延迟极敏感、对质量要求中等的场景(输入法联想、流式补全)。
束搜索:每步保留 k 条(束宽)累计概率最高的候选序列,下一步对每条候选的全部扩展重新排序,再留下新的 k 条,最终输出累计概率最高的整条。它把"逐步贪心"升级为"序列层面的搜索",在机器翻译这类有标准答案的任务上质量稳定更好。代价是计算量约与 k 成正比,且 k 大到十以上收益趋平;更大的坑在开放生成——束搜索偏好高概率(即平庸、安全)的输出,写故事容易千篇一律。k 常取三到五。
贪婪与束搜索路径对比
三、采样策略:让输出活起来
确定性策略的输出永远一样,开放生成(对话、写作、头脑风暴)需要的却是多样性。这类场景改用采样:按概率分布随机抽词,低概率词也有机会登场。
纯采样直接按分布抽签,多样性最高,但长尾里藏着大量不连贯的怪词,输出质量失控。
温度采样先整形再抽签:把进入 softmax 的分数除以温度参数再归一。温度大于一时分布变平,高低温差缩小,采样更随机、文本更"野";小于一时分布变尖,向贪婪靠拢,文本更保守;等于一即纯采样。直觉上温度是"想象力旋钮":创意写作调到零点九左右,事实问答调到零点二甚至直接贪婪。
Top-k 采样截断长尾:只在概率最高的 k 个词元里采样,怪词被物理排除。k 是固定值,问题在分布形状会变:某步分布很尖时(下一词几乎确定),保留 k 个仍嫌多,稀释了本该集中的概率;分布很平缓时,k 个又可能不够。
核采样(Top-p)解决这个自适应问题:把词元按概率从高到低累加,取累积概率首次达到阈值 p 的最小集合,只在该集合内采样。分布尖时候选集自动缩小,分布平时候选集自动扩大——截断标准跟着分布形状走。实践中常取 p 等于零点九至零点九五,并常与温度叠加使用:先调温度再截断,兼得可控与多样。
| 策略 | 确定性 | 多样性 | 计算开销 | 典型场景 |
|---|---|---|---|---|
| 贪婪搜索 | 确定 | 无 | 最低 | 低延迟补全 事实问答 |
| 束搜索 | 确定 | 无 | 约与k成正比 | 机器翻译 摘要 |
| 纯采样 | 随机 | 最高 | 低 | 极少直接使用 |
| 温度采样 | 随机 | 可调 | 低 | 创意写作调高温 |
| Top-k | 随机 | 受控 | 低 | 通用开放生成 |
| 核采样 | 随机 | 自适应 | 低 | 对话与写作主流 |
⚠️ 实战坑三条。其一,重复循环:采样温度偏低时模型容易陷入"的的确确的的确确"式复读,可用重复惩罚(对已生成词的分数降权)缓解,但惩罚过猛会造成语义跳跃,需小步调整。其二,束搜索用于开放生成:输出安全而空洞,团队常误以为模型坏了,其实是策略不适配。其三,忘记结束符处理:解码循环若不检查结束符,模型会一直生成到最大长度,把成本与延迟翻倍。
💡 选型口诀:有标准答案用束搜索,要多样用核采样加温度,要快要稳用贪婪。拿不准时先跑核采样 p 取零点九、温度零点八的组合,它对多数开放任务是个不坏的起点,再按体感微调。
五、推理工程与策略实验
延迟与吞吐的两种目标
推理优化先分清目标。延迟导向(单请求快):键值缓存、小模型加量化、早停机制;吞吐导向(单位时间总请求多):动态批处理(攒请求成批执行)、连续批处理(批次边跑边进出)。两个目标有时冲突——攒批提高吞吐却增加单请求等待。服务化部署的第一决策就是确定自己在这条轴上的位置,再选工具组合。
解码策略的实验方法
策略参数不该拍脑袋定。可行的小规模实验:固定测试集(几十到上百条),网格扫温度与核采样阈值的几组组合,每组合生成多候选,用自动指标粗筛加人工抽查精选。经验上温度与阈值二选一为主调、另一个微调即可,全网格往往浪费。评估生成质量时务必包含人工环节——自动指标与人的体感有系统性偏差,只看指标会调出"指标好看、读着难受"的参数。
流式生成与用户体验
逐词生成的特性天然适配流式输出:每选出一步就把增量推给用户,体感延迟从"整段等待"变成"首字等待"。工程要点是结束符判断要在流中正确传播、错误处理要支持中途取消(缓存即时释放)。对话类产品对首字延迟极其敏感,流式不是加分项而是及格线。
一个经典对比实验
同一模型、同一提示,分别用贪婪、束搜索(束宽五)、核采样(阈值零点九、温度零点八)各生成十次。典型观察:贪婪与束搜索十次几乎全同(确定性),内容稳妥但平淡;核采样十次各不相同,其中两三条比确定性结果更有趣,也可能有一条偏题。这个实验直观展示"质量与多样性的兑换关系",建议每个做生成的工程师亲手跑一遍——策略的性格,报表读不出来。
⚠️ 补一条成本陷阱:束搜索的显存与计算随束宽线性增长,并发场景下多请求各持多条候选,显存峰值容易爆。容量规划时把束宽算进单请求成本的乘数里,别按贪婪的账本做预算。
💡 参数速记卡:翻译摘要用束搜索束宽三到五;开放对话核采样阈值零点九上下、温度零点七到一点零;事实问答低温加小阈值或直接贪婪;复读时先加轻量重复惩罚。四句口诀覆盖九成场景,剩下的交给实验。
键值缓存的显存账怎么算?
缓存大小等于层数乘二(自注意力与交叉注意力各一份键值)乘二(键与值)乘序列长度乘模型维度乘批大小,随生成长度线性增长。长输出加高并发场景,缓存而非模型权重往往先撑爆显存。对策按序:减小并发或批大小、限制生成长度、改用分组查询类架构变体(多组头共享键值,缓存缩至若干分之一)。做容量规划时先算这笔账,比上线后频繁重启体面得多。
一节小结
- 自回归循环:编码器一次前向、解码器步步推进,结束符或长度上限终止;
- 键值缓存是命门:历史键值只算一次、逐步复用,把每步开销压到近恒定;
- 贪婪短视:每步局部最优、不能回头,胜在速度;
- 束搜索看全局:保留 k 条候选按累计概率排序,翻译类任务的标配,开放生成慎用;
- 温度是想象力旋钮:高温变平更随机、低温变尖更保守,直接作用于 softmax 前的分数;
- Top-k 固定、核采样自适应:前者截前 k 个,后者按累积概率 p 收缩,后者对分布形状更鲁棒;
- 组合拳与防复读:核采样加温度是开放生成主力,重复惩罚可治复读但需轻量使用。
最后一步,把前面所有知识装进现实的工具箱。下一节看开源框架如何把 Transformer 变成几行调用。
常见疑问
问:贪婪解码、束搜索、采样到底怎么选?
答:看任务要「最稳」还是「要活」。翻译摘要这类有标准答案倾向的任务用束搜索(保留 k 条候选路径,兼顾质量与稳健),k 常取四到八;开放式生成(对话、写作)用采样类策略(温度、核采样按累积概率 p 截断),否则输出千篇一律甚至复读。贪婪最快但短视,通常只做快速验证。一句话:确定性任务求最优,创造性任务求多样。
问:温度调高调低改变的是什么?
答:改变分布的尖锐程度。温度小于一时 logits 除以小数、差距放大,概率质量向高概率词集中,输出保守稳定;大于一时分布被压平,低概率词也有机会,输出猎奇奔放。它不改变模型的知识,只改变「从知识里挑词的胆量」。写代码要低温度,头脑风暴要高温度,人机对话常取一上下微调。