3.4 聚类分割动手
3.4 聚类分割动手
本节摘要:把每个像素当成特征空间里的一个点,用 K-Means 或 Mean Shift 聚成几簇,再映回图像成为区域。原文示例把彩色图拉成 N×3 再聚类,K 取 3,n_init 设为自动。聚类不需要标签,适合探路和给弱监督当草稿,但簇不等于语义类别。
本节目标
阅读完本节,你应当能够:
- 把图像 reshape 成像素特征矩阵并跑 K-Means,再 reshape 回标签图
- 解释 K、初始化、迭代对结果的影响,以及为何要多次初始化
- 对比 Mean Shift 不预先指定簇数、用带宽控制尺度的行为
- 说明何时聚类只是可视化,何时能当基线掩码
一、像素是点,簇是颜料桶
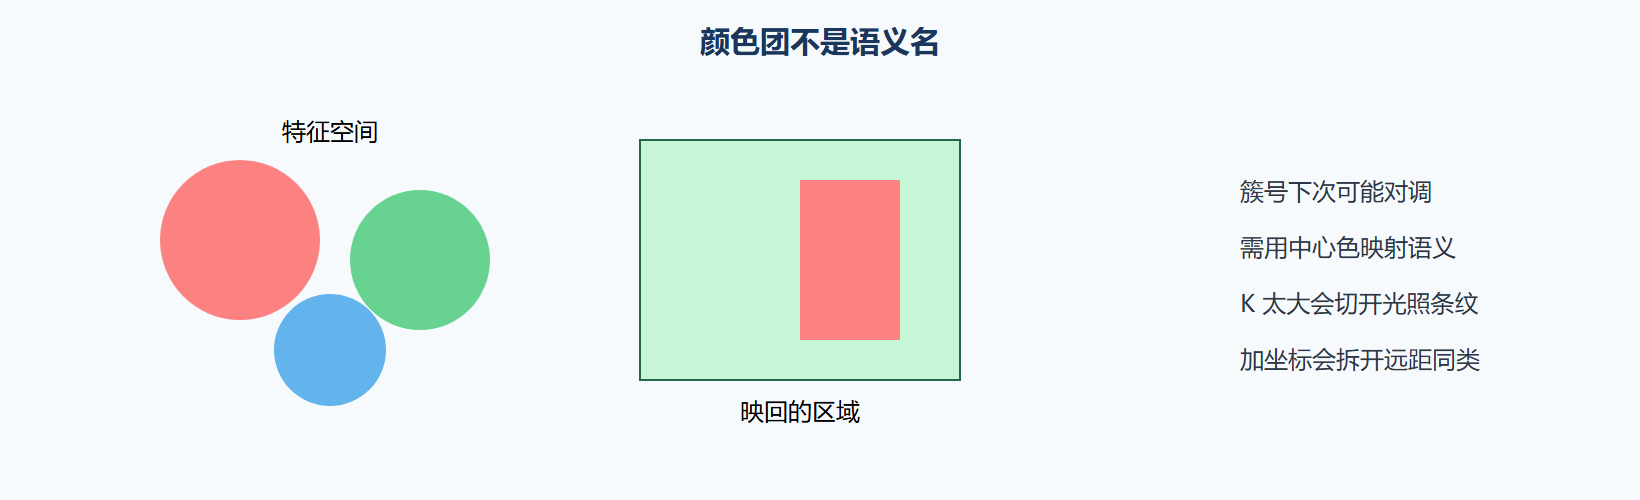
地图填色如果只按「长得像」,会把所有湖填成蓝,把阴影里的湖也填成黑——因为特征里混了亮度。K-Means 最小化点到簇中心的平方距离,特征选 RGB 就会按颜色团切,选 Lab 往往对光照更稳,拼上坐标 x、y 会让空间上远的同类拆开,变成「既像又近」。特征一变,故事全变。
步骤:选 K 个初始中心 → 每点归最近中心 → 中心改为该簇均值 → 重复直到中心几乎不动。原文强调显式 n_init,避免库的默认警告,也提醒你:一次坏初始化会得到空簇或怪异切开,多开几次取惯性最小的更稳。
pixels = img.reshape((-1, 3)).astype(np.float32) k = 3 criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 20, 0.5) compact, labels, centers = cv2.kmeans( pixels, k, None, criteria, 5, cv2.KMEANS_PP_CENTERS) seg = labels.reshape(img.shape[:2])
K 怎么选:业务上你期望几类就从几类试。肘部法则看惯性下降变缓,但分割里肘部常不明显。我更看叠图:K 太小,目标与背景同簇;K 太大,一块衣服被拆成光照条纹。选能让目标成块的最小 K。
二、Mean Shift:爬密度峰
Mean Shift 不先定 K。在特征空间里,每个点移向邻域均值,邻域由带宽决定,直到峰顶。有几个峰就有几簇。带宽大,峰被抹成一座,簇变少;带宽小,噪声也成峰。计算比 K-Means 重,像素级全图要抽样或降分辨率。
适合:簇数事先不清、形状不规则的颜色团,如皮肤、植被。不适合:要精确 K 类口径的土地分类——政策要 8 类你却得到 13 个峰,还得手工合并。
| 算法 | 簇数 | 尺度控制 | 计算 | 分割里的角色 |
|---|---|---|---|---|
| K-Means | 预先指定 | K 与特征 | 相对轻 | 快速草稿、超像素前身 |
| Mean Shift | 自动 | 带宽 | 重 | 探索自然团块 |
| 阈值 | 2 或少数 | T | 极轻 | 灰度可分时优先 |
⚠️ 常见坑:把簇号 0、1、2 当成数据集里的背景、车、人。簇号是任意的,还可能下次运行对调。必须靠中心颜色或人工映射。
💡 关键直觉:聚类切的是特征空间的团,不是名字。名字是你事后贴的。
三、和坐标特征、超像素
只在颜色空间聚类,远处两块同色会同一标签,这正是语义想要的。若你要空间连通,把 x、y 按权重拼进特征,或聚类后取连通域当实例。权重太大,变成按位置切豆腐,颜色信息作废。
超像素(把图预先聚成几百块均匀小片)常用类似思想,降低后续图割或分类的节点数。本教程不展开图割细节,只提醒:超像素边界必须贴真实边缘,否则后面再聪明也跨不过这块错误原子。
原文比较 K-Means 与 Mean Shift:前者要 K、对球形簇友好;后者要带宽、能跟不规则团。工程上我先 K-Means 出图,不满意再试带宽。两者都对光照敏感,Lab 或先均衡亮度值得做。
图 特征空间里的团映回图像
四、当草稿,不当真理
无标签时,聚类让你看见数据里自然的团,帮助写第 2.4 节类别表:若颜色上根本没有第三团,就别设第三类。有标签时,聚类可当弱标签启动,或当第 6 章后处理:把网络概率图再聚类修边界,收益不一定稳。评估必须用映射后的语义 id,随机簇号直接算 mIoU 是无意义的。
K-Means 对异常值敏感,个别高光像素能把中心拽走。可先用中值滤波,或对特征分位数裁剪。Mean Shift 带宽用像素颜色的标准差量级去试,记录下来。
五、簇到类的映射表
跑完 K-Means,不要看标签图的假彩色就发布。计算每个簇中心在 Lab 或 RGB 的位置,按距离最近的语义原型(你在规范里写的「植被大约是绿、路面大约是灰」)做一次映射,再人工看叠图改错。映射表存下来,下次初始化不同簇号才能对上同一套语义。没有映射表,两次实验的 mIoU 不可比。
加坐标特征时,把 x、y 除以宽高归一化到 0 到 1,再乘一个权重。权重 0 就是纯颜色;权重很大就是按位置切豆腐。在遥感里,有时需要「同类但空间上分开的地块仍同标签」,那就不要加坐标,聚类后也不要强制连通。质检裂纹相反,空间上分开的两条就是两条,连通域后处理更合适。
Mean Shift 带宽可用颜色标准差的倍数试。带宽列表写进日志。抽样像素再插值回全图可加速,但边界会糊,只适合探路。正式基线仍尽量全像素,或先超像素再对超像素均值聚类,原子边界要够贴。
问题:K 能否用类别数直接当?
可以当起点,不能当真理。光照条纹会让一类变两簇,阴影会让一类变两簇。K 取类别数加 1 或 2,再合并,往往比死取类别数干净。合并仍靠中心色,不靠簇号。
原文 n_init 自动与 K=3 的示例是演示。你的图通道数、是否含坐标、K 的网格,都要成为基线表的列。聚类当草稿帮你写类别表:若怎么也聚不出第三团,第三类可能不该存在,或成像不足以支撑它。
六、映射表与肘部
簇号无语义。每次运行保存中心坐标与映射到规范类别的表。没有表,两次实验 mIoU 不可比。K 取类别数只是起点,光照条纹常要 K 更大再合并。肘部不明显时用叠图选能让目标成块的最小 K。加坐标特征前把 x、y 归一化再加权,权重过大变成切豆腐。
Mean Shift 带宽用颜色标准差倍数列表扫,记入日志。全图像素重,探路可抽样,正式基线尽量全像素或超像素均值。超像素原子必须贴边,否则后续分类跨不过错误原子。高光异常值会拽走 K-Means 中心,先中值或分位裁剪。
聚类帮助写类别表:怎么也聚不出的第三团,可能不该成为第三类,或成像不足以支撑。当弱标签启动可以,但评估必须在映射之后。原文 K=3 与 n_init 自动是演示钉子,你的通道数、是否含坐标、K 网格,都要成为基线表的列。
中心与映射表每次保存。K 从类别数起允许更大再合并。坐标权重过大变切豆腐。带宽列表进日志。高光先裁剪。聚不出的团回头改类别表或成像。评估只在映射后。超像素原子贴边是硬条件。原文 K=3 只是钉子。把簇号当类名是最常见的评估自欺,脚本应拒绝未映射的标签图进入 mIoU 函数。
映射表与中心一起进版本库,缺表的标签图进不了 mIoU 函数。K 网格实验结果留叠图。坐标权重上限写死。带宽列表与抽样开关进日志,正式基线关闭抽样。高光裁剪分位写契约。聚不出的类回头改表或成像,不改 K 到几十充数。超像素贴边用边界召回抽检。簇号直接进评估视为脚本 bug。原文 K=3 钉子旁注释「此处必须换成映射后的语义 id」。两次运行簇号对调是预期,映射后语义 id 应对齐,对不齐说明映射用了不稳定规则,应改成按中心色最近原型,原型写在规范里而不是写在某次笔记本里。
反例档案:簇号当类名,两次实验对调,mIoU 乱跳。映射表强制后稳定。第二份:K 加到几十充数,衣服被切成光照条。网格叠图选最小成块 K。无映射标签进不了评估函数,脚本拒绝自欺。原型写在规范,不写在笔记本。
口令卡:映射表进库、K 网格留图、坐标权上限、正式关抽样、无映射拒评估、原型在规范。簇号对调预期。中心色对原型。超像素贴边抽检。K=3 旁注释必须映射。
指导书:无映射拒评、网格留图、权上限、关抽样、原型在规范、贴边抽检。簇号对调是正常现象,映射后应对齐。注释钉在 K 示例旁。聚不出的类回头改成像或改表,把 K 加到几十只是把光照切碎。两次运行语义 id 对齐测试进 CI。
交付门禁己
无映射表的标签图进入评估函数应抛错。K 网格无叠图附件退回。坐标权重超上限退回。正式基线仍开抽样退回。两次运行映射后语义 id 对不齐退回。原型只存在于个人笔记退回。超像素边界召回未抽检退回。把簇号当类名的脚本搜索应为零命中。聚不出的类未回头改成像却把 K 加大,实验作废。
现场抽问:映射表在仓库哪?无映射会不会抛错?K 网格图在哪?权重超上限会不会拒?抽样关了没?两次运行语义 id 齐不齐?原型是不是在规范里?贴边抽检做了没?簇号当类名的代码还在不在?
失败演练丁:无映射进 mIoU,应抛。K 加大到几十充数且无叠图,应作废。抽样开着当正式基线,应拒。两次运行语义 id 不齐,应拒。原型只在笔记本,应拒。簇号当类名代码若还在,搜索应红。
映射、叠图、关抽样、id 对齐、规范原型、禁止簇号当类,六条写成评估入口守卫。入口守卫红灯则本节数字作废,不得写入体检表第四列。K 网格没有图的实验同样作废。
评估入口守卫红灯则体检表第四列留空,不得用簇号充数。入口守卫是映射、叠图、关抽样、对齐、原型、禁簇号六项,一项红全红。
第四列空着比填错更诚实。守卫全绿才能写上映射后的交并比。没有叠图的 K 搜索结果不得填表。簇号列在评估输出里出现即为事故。
第四列空着可以,填错不行。守卫全绿再写数字。空着比填错更专业。
把像素拉成样本再聚类,簇数不是类别数的同义词:光照会把同一器官拆成两簇。聚类结果必须映射回类别表再算 IoU,直接把簇编号当标签会让数字虚高。颜色空间选错时先换空间再加簇数。
重点提炼
- 像素变点、簇变区:reshape 是固定动作
- K-Means 要 K 和多次初始化:簇号无语义
- Mean Shift 要带宽:簇数是结果不是输入
- 特征选择决定故事:RGB、Lab、是否加坐标
- 先当探针:帮助写类别表、打无监督草稿
- 映射之后才能评估:禁止拿簇号直接比真值
下一章搭训练环:当传统探针不够,用卷积把「像一类」从灰度换成学来的特征。