5.1 FCN全卷积出像素图
5.1 FCN:全卷积出像素图
本节摘要:全卷积网络把分类骨干末尾的全连接换成卷积,使任意尺寸输入都能得到空间分数图,再用上采样拉回原图。跳跃融合把浅层的定位和深层的语义加在一起,衍生出步长 32、16、8 等变体。它是后面 U-Net、DeepLab 的公共祖先:训练环不变,换的是头与融合。
上手前先明确
阅读完本节,你应当能够:
- 说明为何全连接阻止任意尺寸分割,以及 1×1 卷积如何扮演像素分类器
- 区分双线性上采样与转置卷积,知道棋盘伪影从哪来
- 画出粗特征与细特征相加融合的路径
- 把 FCN 头接到第 4 章训练环,检查输出高宽
一、砍掉摊平这一刀
分类网把特征图摊平,接全连接,得到类向量。摊平把空间位置扔掉,且锁死输入长度。FCN 的核心动作:把那些全连接看成对整图的大卷积——核盖住整个特征图——于是空间还在,输入尺寸可以变。最后一层通道数等于类别数,每个位置一张彩票,与第 4.1 节的像素分类头是同一件事。
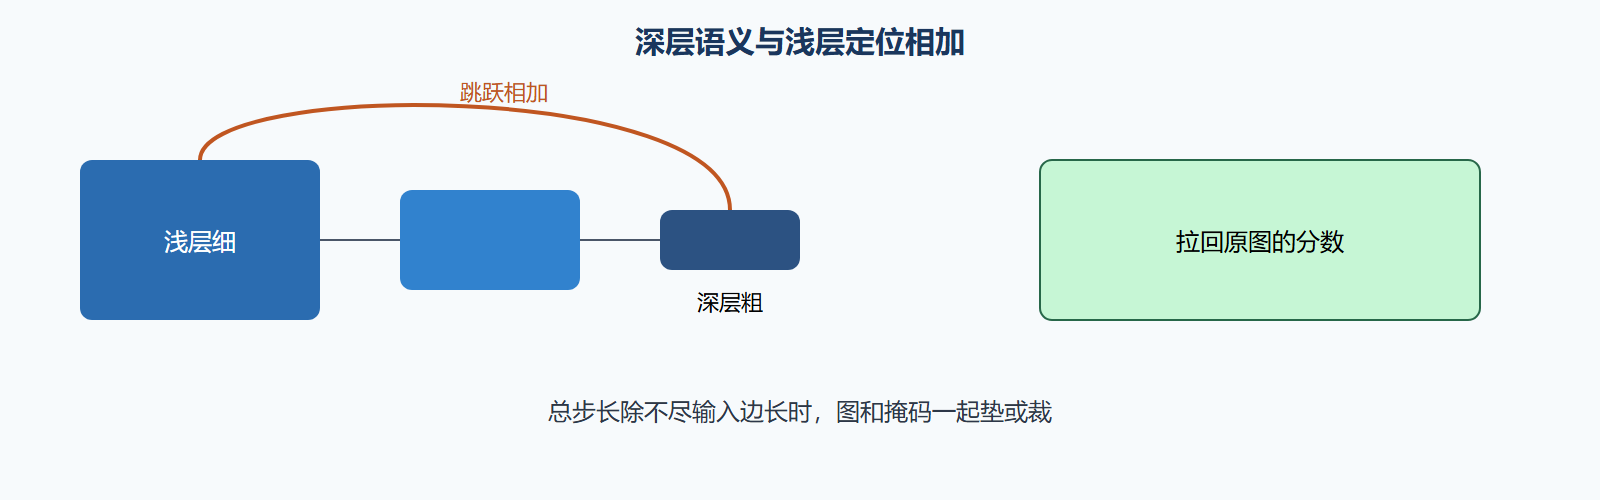
上采样把缩小了 32 倍的分数图拉回。只用 32 倍插值,边界糊,这叫粗输出。把中间层(缩小 16 倍、8 倍)的分数加进来,细节回来一些。相加前要用 1×1 卷积把通道拧到类别数,尺寸用插值对齐。这就是跳跃融合,注意 FCN 经典实现是相加不是拼接。U-Net 后来改成拼接,那是下一节。
# 概念:深层分数上采样后与浅层分数相加 coarse = upsample_x32(head32(feat32)) mid = upsample_x16(head16(feat16)) fine = upsample_x8(head8(feat8)) logits = coarse + mid + fine # 需先对齐尺寸
二、上采样怎么选
双线性:无参数、稳、略糊。转置卷积:可学习,步长与核配合不好会出现棋盘格,叠图像砖。实践常「转置卷积后接普通卷积」或「插值后接卷积」压伪影。分割任务对伪影敏感,因为伪影会被 argmax 变成花边类别。验证可视化若出现规则网格,先查上采样而不是学习率。
输入边长最好能被总步长整除。不能整除时,中心裁切或填充,掩码做同样操作。这又回到第 2 章契约:图与掩码同变。
| 变体 | 融合 | 细节 | 代价 |
|---|---|---|---|
| 只 32 倍上采样 | 无 | 糊 | 最轻 |
| 融合 16 | 一层跳跃 | 较好 | 稍重 |
| 融合 8 | 两层跳跃 | 更跟边 | 更重、对齐更烦 |
⚠️ 常见坑:融合时忘了把浅层也过分类头,直接把 256 通道加到 21 通道上,形状都对不上还硬 squeeze。
💡 关键直觉:FCN 证明分类骨干里已经有分割所需的语义,缺的是空间还回去的路。
三、优点、缺点、何时用
优点:任意尺寸、能接各种分类骨干、开创全卷积范式。缺点:默认下采样猛,小目标弱;相加融合对浅层通道处理简单;没有 U-Net 那么强的细节通路。现代很少从零实现纯 FCN 交产品,但读懂它才能读懂后面所有头。小实验上,用轻骨干加 32 倍插值就能验证第 4 章的环,不必一上来复现全部跳跃。
应用上,原文提到通用语义场景。医学小样本更常直接上 U-Net。实例任务 FCN 不够,要第 5.4 节。把 FCN 当「最小能出像素图的深度基线」,与第 3 章 Otsu 比:它该赢在语义可分、灰度不可分的图上。若赢不了,多半是数据而不是缺跳跃。
预训练分类权重加载时,最后的全连接不要了,新的 1×1 头随机初始化,学习率可以更大。骨干小学习率。这和 4.3 节优化器分组是同一旋钮。
图 粗语义加细定位
四、接到环上的检查单
打印每段 feat 的高宽;融合前 assert 对齐;损失吃 logits 不是 softmax 后;可视化 argmax。原文 PyTorch 示例展示如何搭层,你应把它缩成能跑的最小全卷积,而不是复制一整本骨干。能出与输入同尺寸的类别图,本节过关。细节不够,进 U-Net;多尺度物体,进 DeepLab。
五、最小 FCN 实验怎么做
用最浅的下采样两次(总步长 4)加插值回去,在试标图上过拟合。目的不是刷分,是确认:任意输入边长(可整除)都能出同尺寸图;跳跃相加时通道拧得对。然后再换更深骨干和 32 倍步长。一上来复现完整分类网再改全连接,调试周期会很长,对学习路径不友好。
预训练键名对不上时,严格模式应报错。静默跳过会导致你以为在微调,其实头和骨干都在随机走。打印「成功加载了多少层」。分类头的全连接键本来就该丢,这是预期。新的 1×1 键不该出现在旧文件里。
棋盘伪影:叠图出现规则网格,查转置卷积的核与步长是否同奇偶搭配不当。改成「插值加普通卷积」通常立刻消失。不要用更小学习率去「学平」棋盘,那是结构问题。
问题:FCN 现在还值得当生产模型吗?
作为教学基线和快速探针值得。作为产品,U-Net 或 DeepLab 头通常更强。若你的骨干加简单 32 倍插值已经打赢第 3 章基线很多,说明任务偏语义且尺度不大,再加复杂头收益可能有限,用验证曲线决定,不要按年份决定。
融合 8、16、32 时对齐要用「对齐到输入网格」而不是互相凑合少一圈。少一圈在大图上像整体平移,指标掉在边界类。assert 是朋友。把 FCN 接到环上后,与 Otsu 基线并排画一张表,本章才算落地。
六、先浅后深
两次下采样加插值,确认任意可整除边长都能出同尺寸,跳跃通道拧对,再换 32 倍骨干。预训练缺键要报错。棋盘伪影改插值加普通卷积,不要用学习率去磨。融合对齐到输入网格,少一圈像整体平移。与 Otsu 基线并排,打赢灰度不可分、语义可分的图,才算深度基线成立。生产可换 U-Net 或 DeepLab 头,FCN 负责把范式讲清并把环验证完。
浅网先验证任意可整除边长与跳跃通道,再上 32 倍。缺键报错。棋盘改插值加卷积。对齐输入网格。与 Otsu 并排表。生产可换头,范式与环在此验收。少一圈像素的融合在大图上像平移,边界类 mIoU 会先掉,叠图比数字更早暴露。把「融合后高宽等于输入」写成测试,随机张量即可,不必等真实数据。
浅网随机张量测试:输入边长 128 与 160(若被步长整除),输出高宽必须相等对应。跳跃通道拧错应在 cat 或 add 前报错。预训练加载失败要抛,禁止 try 空 except。棋盘检测用可视化网格能量,超阈则改插值路径。融合后高宽等于输入写成测试。与 Otsu 并排表缺行号则本节未完成。少一圈平移用叠图差的质心偏移检测。生产换头不换这些测试。32 倍路径作为可选,浅网测试不过不准上 32 倍。1×1 头类别维断言。输入不能整除时加载器已报错,模型侧不再偷偷 pad。把「范式验收」和「生产选型」分开写在日志标题,避免有人把教学浅网当发布模型。
反例档案:try except 吞掉预训练失败,全程随机还以为在微调。改为抛错后才真正加载。第二份:教学浅网被当发布模型上线,边界糊。日志标题分开范式验收与生产选型。少一圈融合用质心偏移抓住。Otsu 并排表缺行号本节不算完。浅网测试不过不准上 32 倍,省掉许多假对比。
口令卡:浅网双边长测、跳跃前报错、预训练失败抛、棋盘改插值、高宽测试、Otsu 表有行号、质心偏移抓少一圈、标题分范式与生产、不能整除加载器报、1×1 维断言。浅不过不上 32。try except 空吞视为事故。
插模块前:浅网 128 与可整除边长双测、预训练失败必抛、高宽测试、Otsu 行号、质心偏移、标题分家。try 空 except 搜索零命中。浅不过禁 32 倍。生产选型另写,教学浅网不得进发布目录。少一圈用偏移检测比用肉眼稳。1×1 维与类别表长度相等。不能整除只允许加载器报错一种处理。范式验收通过才谈换头。
交付门禁癸
浅网双尺寸测试不过禁止上 32 倍。预训练失败被吞禁止合并。高宽测试不过禁止合并。Otsu 对照表无行号本节未完成。质心偏移超阈说明少一圈。教学浅网出现在发布目录视为事故。try except 空搜索必须零命中。1×1 维必须等于类别数。不能整除不得在模型里悄悄补。范式验收标题与生产选型标题必须分开,混写则日志作废。少一圈用偏移检测写入回归。
现场抽问:浅网双尺寸过了没?失败被抛了没?高宽测过了没?Otsu 行号在吗?质心偏移多大?浅网是不是混进发布目录了?空 except 还有吗?类别维对齐了吗?不能整除谁在 pad?标题分家了吗?少一圈回归有了吗?
失败演练庚:浅网未过就上 32 倍,应拒。预训练失败被 except 吃掉,应拒。教学浅网打进发布目录,应拒。少一圈无偏移回归,应拒。Otsu 表无行号声称超过传统,应拒。模型里悄悄 pad 不能整除的边长,应拒。标题混写范式与生产,日志作废。这些演练是为了把全卷积节从「会讲」变成「可发布」。随机张量高宽仍是第一关,关不过后面都别谈。
发布目录扫描浅网文件名,扫到即失败。偏移回归未注册即失败。行号缺失即失败。空 except 即失败。模型 pad 即失败。标题混写即失败。这些扫描进 CI,全卷积节才算工程化。随机张量关仍是第一关,关不过 CI 红。
CI 扫描发布目录、偏移回归、行号、空 except、模型 pad、标题分家。全绿才允许把全卷积头标为可用模块。随机张量仍是第一关,关不过后面扫描无意义。教学浅网文件名模式列入黑名单。
黑名单文件名、偏移回归、行号、空 except、pad、标题分家,六项扫描进同一 CI 任务。任务红则模块标签保持不可用。第一关随机张量仍排在扫描之前。
模块标签保持不可用,直到 CI 任务全绿。黑名单与第一关都在同一流水线里,不许跳过随机张量直接扫描发布目录。跳过第一关视为流程事故。
FCN 的上采样路径必须接到与输入同高宽的分类头。跨层相加前对齐通道与空间,对不齐就裁或插值并写进尺寸账。用 FCN 跑通「网络也能出掩码」之后,细节不够再换 U-Net,不要第一步就上复杂解码器。
核心回顾
- 全连接换成卷积:任意尺寸、空间还在
- 上采样拉回原图:插值稳,转置卷积小心棋盘
- 跳跃相加:浅定位加深深语义
- 步长要整除:与掩码同垫同裁
- 当深度基线:应能在语义可分数据上超过 Otsu
- 预训练只接到卷积骨干:新头单独大学习率
下一节把相加改成拼接,用对称的编码解码把医学小样本里的细节保回来。