5.5 TransUNet与SAM辅助标注
5.5 TransUNet 与 SAM:辅助标注
本节摘要:Transformer 用自注意力让每个补丁看见全局,TransUNet 把它嵌进 U 型当编码器,改善远距离依赖。Segment Anything 一类基础模型用点、框、粗掩码当提示出掩码,适合加速标注或零样本试探。生产小模型仍建议用你的类别表微调;大模型当工人,不当不审的终审。
学习目标
阅读完本节,你应当能够:
- 用「补丁序列 + 注意力」说明全局上下文如何进来,以及计算如何随长度涨
- 说出 TransUNet 相对纯卷积 U-Net 可能换来什么、付出什么
- 用点和框提示跑一遍提示式分割,把结果当草稿而不是真值
- 设计「大模型预分割 → 人工改 → 小模型蒸馏」的标注闭环
一、卷积的野再大也是局部叠出来的
深层卷积与空洞能看远,但仍是一层层传。注意力让每个补丁直接和所有补丁交换,远距离的「左肾与右肾应对称」这类关系来得更直。代价是序列长度等于补丁数,自注意力随长度平方涨,高分辨率切片要先下采样或切窗。TransUNet 一类做法:CNN 先抽特征,再把特征图展成序列进 Transformer,解码仍走 U 型跳跃。等于编码器换物流,解码器仍把细节送回家。
原文回顾注意力基础并给出 TransUNet 结构思路。动手时不要被名字吓住:训练环还是第 4 章,损失还是 Dice 加交叉熵,变的是编码器。数据少时,纯卷积 U-Net 往往更稳,因为注意力参数更饿。数据多、结构依赖长,值得试。
显存与速度:同样边长,Transformer 编码器通常更贵。先在小边长验证注意力真的在用全局——例如把图左右对调,看预测是否仍解剖合理——再加分辨率。
二、提示式分割:点一下出一张草图
SAM 这类模型把图像先编成一次嵌入,然后吃点、框、或粗掩码,吐出多个候选掩码和分数。原文示例:设图、给中心点、取最高分掩码叠图。这和区域生长的「点种子」是同一交互,谓词从灰度换成了大规模预训练特征。
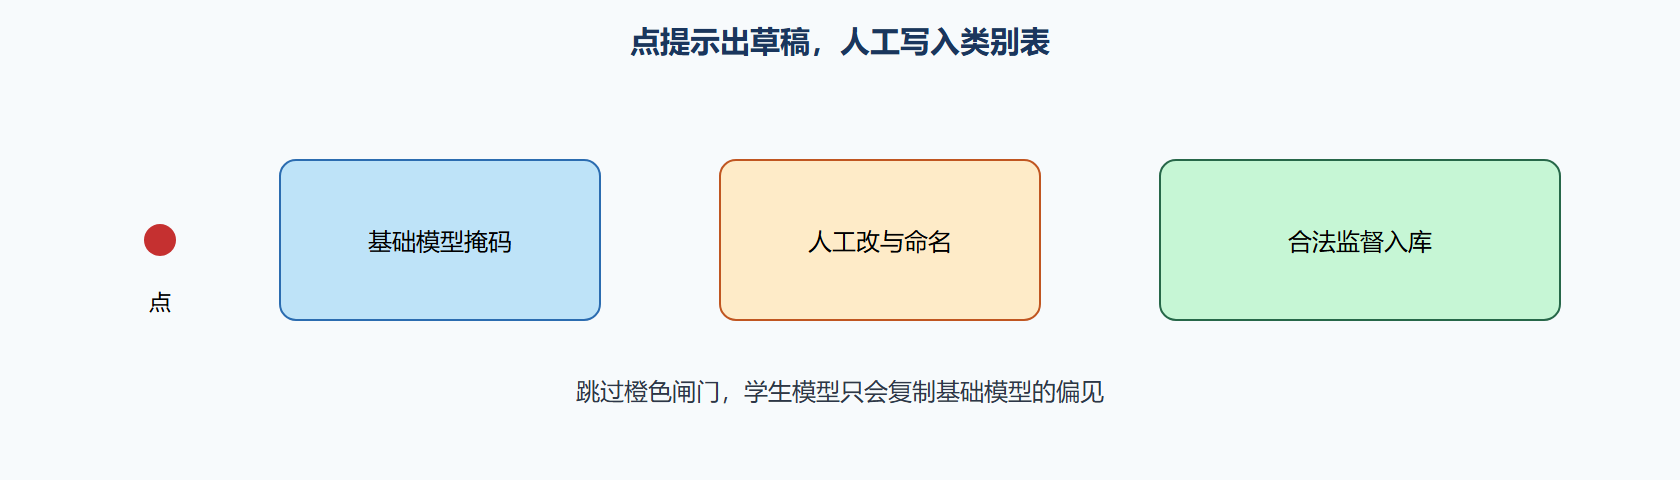
用途一:标注员点两三下,改一改边界,比从零画多边形快。用途二:无标签数据上先看能不能分开,判断任务有没有希望。用途三:生成伪标签再给学生模型。风险:基础模型有自己的物体先验,可能把你的「裂纹」理解成纹理,或把需要切开的两核粘成一个。人工不改,蒸馏会固化错误。
# 概念:图像嵌入一次,提示可多次 predictor.set_image(rgb) masks, scores, _ = predictor.predict( point_coords=np.array([[x, y]]), point_labels=np.array([1]), multimask_output=True) best = masks[scores.argmax()]
点标签 1 表示前景点,0 表示背景点。多给几个背景点,常比死拧单个中心点有效。框提示适合「就抠这个」。自动网格点出全图掩码适合探索,不适合当语义类别表——它没有你的类名。
| 工具 | 要标签吗 | 交互 | 当生产模型 |
|---|---|---|---|
| U-Net | 要 | 无 | 适合小样本语义 |
| TransUNet | 要 | 无 | 长程结构、数据够时 |
| 提示基础模型 | 预训练已含 | 点框 | 慎用,类名对不上 |
| 生长/分水岭 | 不要 | 种子 | 灰度可分时 |
⚠️ 常见坑:把提示模型输出直接当真值训练学生,再在同一套错误上报告高 Dice。那是复制器,不是分割系统。
💡 关键直觉:基础模型擅长「这是一块东西」,你的产品要的是「这是哪一类、要不要拆」。差的那一步必须人来补或用自有数据微调。
三、辅助标注流水线
试标阶段:每类找难例,用点提示出草稿,规范里写清必须人工确认的部位(血管与肿瘤交接等)。统计「草稿被改了多少像素」,改得少的类可以加大自动比例,改得多的类说明先验不合,不要省人工。版本:预分割模型版本要记入清单,否则半年后无法复现那批标签如何来的。
隐私:医学与厂区图送到外部服务前要过第 2.4 节的门禁。能本地跑的权重优先。本教程不给任何外部地址,只讲工作方式。
TransUNet 与 SAM 可以同时存在:前者是你的生产网候选,后者是标注工装。不要在周会上用「我们上了 Transformer」替代「验证集少数类 Dice 的变化」。
图 预分割必须过人工闸门
四、和主线收束
到此第 5 章模型库齐了:FCN 教范式,U-Net 保细节,DeepLab 看多尺度,Mask R-CNN 管实例,提示模型管标注加速。选一个主生产模型,最多再加一个工装。第 6 章只针对你选中的那一个做增强、调参、后处理、导出。
五、预分割改动量怎么用
统计每张图「人工改动的像素占比」或边界距离。低于阈值的类,可提高自动比例;持续很高的类,说明基础模型先验不合——裂纹、染色伪影、半透明,都常见。不合的类不要为了省钱强自动,错误会在第 6 章以漂亮 Dice 出现,因为学生在复制老师的错。
点提示策略:先点中心,再在漏的地方补前景点,在溢出去的地方补背景点。比单点死拧强。框提示适合「就这个物体」。网格自动出全图适合探索类别是否「像物体」,不适合直接当语义表。输出没有你的类名,必须人工命名后才能入库。
Transformer 编码器在小数据上过拟合更快。正则、更强的预训练、保分辨率的 CNN 前端,都是稳定手段。若 80 张切片上 TransUNet 打不赢 U-Net,这是正常结果,不是你实现错了。数据规模上来再比。
问题:能不能当零样本生产?
类名简单、物体像自然照片里的「东西」,有时能凑合。工业缺陷、医学层次、政策地类,通常不能。零样本可以当第 3 章那样的探针:分开了说明有希望,分开得不像说明成像或定义有问题。生产仍要自有监督或至少人工闸门。
隐私:默认本地权重。必须出网时走第 2.4 节门禁。预分割模型版本写入每张图的元数据,半年后才能回答「这批标签是谁预画的」。工装与生产网分开部署,避免有人把 SAM 直接接到控制回路。
六、工装与生产分开
改动量低才提高自动比例,先验不合的类不要强自动。点加背景点优于单中心点。网格自动无类名必须人工命名入库。小数据上注意力更饿,打不赢 U-Net 是常见结果。零样本可当探针不可当政策地类生产。预分割版本写入元数据。默认本地权重。不要把提示模型接到控制回路。周报看少数类 Dice 相对基线的变化,不看是否上了注意力这个词。
改动量阈值决定自动化比例。背景点补溢。无类名禁止入库。小数据打不赢 U-Net 可接受。版本进元数据。工装不进控制回路。周报对比基线少数类。左右对调实验检查注意力是否真用全局:解剖对称被破坏时预测若仍机械对称,说明全局关系没学到,先加数据再加层。隐私默认本地。
改动量阈值进规范。提示策略文档:中心点、漏补前景、溢补背景。无类名字段的预分割写入隔离。小数据对比 U-Net 为默认预期,输了不作为事故。元数据字段 pred_model_ver 必填。控制回路代码搜索禁止提示模型名称。周报模板强制基线少数类列。左右对调实验进定期回归。本地权重路径配置化但不写进教程正文。出网走门禁记录。工装与生产包分离构建。自动比例只升不降要评审,降自动说明先验在恶化。蒸馏学生不得在未抽检的预分割上训练,闸门代码化:无抽检标记拒绝入库。
反例档案:无抽检预分割直接蒸馏,学生复制粘连核。闸门代码化后入库失败。第二份:周报只有「上了注意力」,少数类列空白。模板强制基线列。左右对调仍机械对称,说明全局没学到。出网无门禁记录视为违规。自动比例只升不降要评审,先验恶化时必须能降。
口令卡:改动量阈值、三点策略、无类名隔离、输给 U-Net 可接受、pred_model_ver 必填、控制回路禁名、周报基线列、左右对调回归、本地权重、出网门禁、降自动可评审、无抽检拒入库。工装生产分构建。
插工装前:改动量阈值、三点策略文档、类名字段、版本元数据、周报模板基线列、左右对调、本地权重、控制回路名称搜索为零、抽检标记门禁。输给 U-Net 不当事故。降自动路径存在。出网有门禁号。工装包与生产包分开构建,避免有人把提示模型打进车载环。
交付门禁卯
无改动量阈值不准提高自动比例。无类名字段入库失败。无版本元数据入库失败。周报无基线少数类列退回。控制回路出现提示模型名构建失败。无抽检标记蒸馏失败。左右对调未做不准声称用了全局注意力。出网无门禁号失败。工装与生产同包构建失败。输给 U-Net 不记事故。降自动路径必须存在且可走。
现场抽问:改动量阈值多少?三点策略文档在哪?无类名会不会入库?版本字段有没有?周报基线列在吗?控制回路搜到名字了吗?无抽检会不会蒸馏?左右对调做了吗?出网门禁号呢?两个包分开了吗?降自动走得通吗?
失败演练子:无抽检蒸馏,应拒。周报只有热词,应拒。控制回路出现提示模型,应拒。无版本元数据,应拒。出网无门禁,应拒。工装生产打成一包,应拒。改动量很高仍升自动,应拒。左右对调没做就声称全局,应拒。降自动路径走不通,应拒。无类名仍入库,应拒。
入库门禁与构建门禁分开写。入库看抽检、类名、版本。构建看控制回路名称、分包、门禁号。周报模板缺基线列不能合并文档。升自动看改动量。对调实验未做不能写全局。
入库三门与构建三门都绿,工装才能发版。周报模板缺基线列时文档合并失败。升自动必须读取改动量。对调实验未登记不得出现全局二字。
提示式分割用来加速预标注,不替代规范。SAM 出的多边形仍须人审并栅格化成类别表内的标签。TransUNet 的补丁大小要能整除裁切边长,否则边角类别错位会重演第 4 章的尺寸账。
要点串联
- 注意力换全局物流:更贵、更饿数据
- TransUNet 仍是 U 型:解码细节路还在
- 提示模型是交互分割:类名与拆分要人补
- 预分割必须抽检:改动量是是否自动化的尺子
- 工装与生产网分开:版本记入数据清单
- 不把热词当进展:看少数类指标
下一章把选中的网放到全数据上:增强、选型清单、调参排错、后处理与部署。