5.4 MaskRCNN实例掩码
5.4 Mask R-CNN:实例掩码
本节摘要:Mask R-CNN 在检测器上加一条并行的掩码分支:骨干出特征,区域提议出候选框,RoI Align 把框内特征对齐到固定格子,再分别预测类别、框回归和像素掩码。损失是分类、框、掩码三项之和。适合要数个数、要分开粘连个体的任务。不要用它去铺满路面这种纯语义活。
读前必看(上)
阅读完本节,你应当能够:
- 按顺序说出骨干、提议、对齐、三头的数据流
- 解释 RoI Align 相对量化过粗的池化如何减少掩码错位
- 说明训练时正负样本与推理时非极大值抑制、分数阈值
- 用预训练检测分割模型在自己的图上先看推理,再决定是否微调
一、先找到物体,再在格子里填色
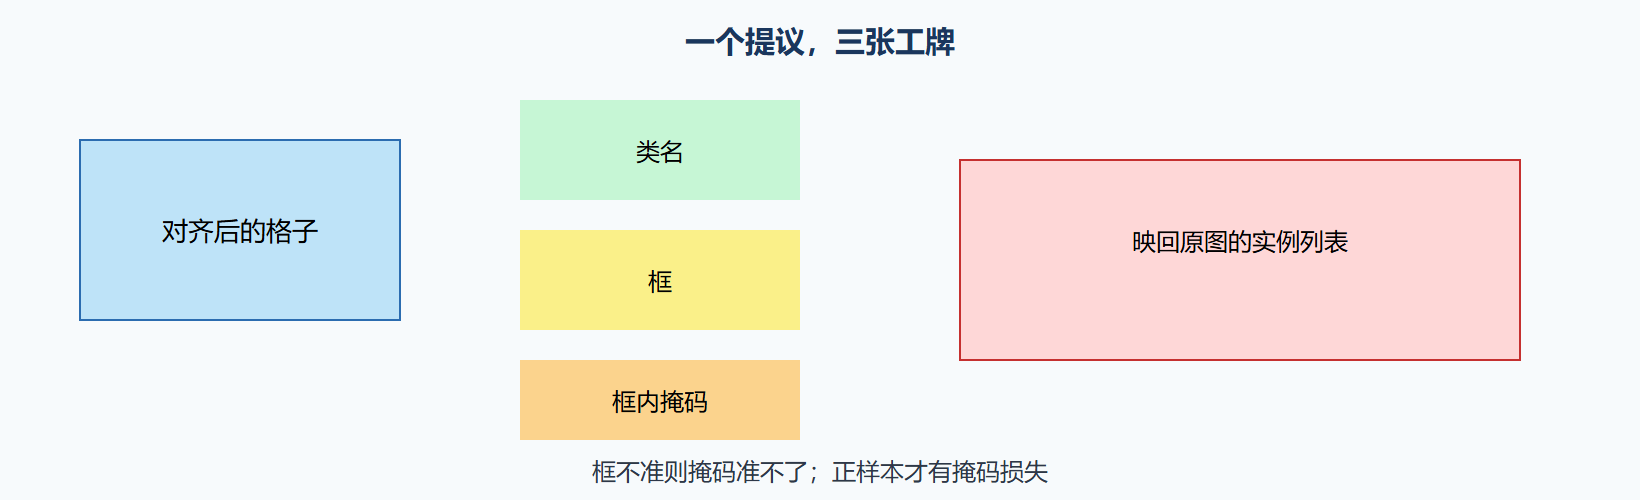
语义模型给整图像素开会。实例模型先开会名单:有哪些物体、在哪。Mask R-CNN 的名单来自区域提议网络,每个候选框经 RoI Align 抽出固定大小的特征,像把不规则地块登记到同一张表格。分类头给类名,回归头把框微调,掩码头在小格子上画二值形状,再映回原图。同一类两个个体两套框两套掩码,粘连自然被框切开——前提是提议没有把两人合成一框。
RoI Align 不用生硬取整坐标,而用双线性在浮点位置采样。旧式量化会让掩码整体错几个像素,小物体伤得更重。这是实例分割精度的关键零件,不是 trivia。
# 概念:推理时过滤低分,留下框、类、掩码列表 out = model(img_tensor)[0] keep = out["scores"] > 0.5 boxes, labels, masks = out["boxes"][keep], out["labels"][keep], out["masks"][keep]
原文示例加载预训练模型、设置信度阈值、画框和掩码。这是正确的动手顺序:先看通用物体上推理通不通,再换自己的类别微调。一上来从头训,提议网络很难在小数据上起势。
二、三项损失要一起听
分类损失让框认对类;框回归让框贴物体;掩码损失通常只在正样本框里、只对真类那一个通道算二值交叉熵。负样本没有掩码监督,这很合理——背景框没有形状。权重不平衡时,掩码很好但类总错,或框飘。看三项曲线,不要只看一个总损失。
推理:分数阈值去掉低置信,非极大值抑制去掉重叠框。阈值太高漏检,太低满屏碎片。抑制太狠会删掉真的紧挨个体。这些超参属于第 6 章部署,但必须在验证集上扫,不能只扫学习率。
| 头 | 输出 | 主要失败 |
|---|---|---|
| 分类 | 每个提议的类 | 相似类混淆 |
| 框 | 位置缩放 | 截断、拥挤 |
| 掩码 | 框内二值图 | 框不准则掩码跟着歪 |
⚠️ 常见坑:用语义 U-Net 的连通域冒充实例,再抱怨 Mask R-CNN 重。若你的产品要计数,重是付在正确的结构上。
💡 关键直觉:掩码画在框的坐标系里。框歪了,世界上最精致的 U 型头也救不了这块实例。
三、何时用、何时不用
细胞、行人、商品、零件计数:用。可行驶区域、天空、染色均匀的单器官:语义即可。全景需要东西加事,Mask R-CNN 不管事的铺满,要另加语义头或换全景架构。速度:比 U-Net 慢是正常的,因为它做检测。嵌入式上可能要轻骨干或两阶段离线。
改进方向原文提到更好的对齐、更好的骨干、级联框。你先把数据的框与掩码标注一致:掩码超出框、或框比掩码大一圈却不统一,训练会打架。标注规范第 2.4 节要写「框是否紧贴掩码」。
预训练类别空间和你的 id 不同,微调时改最后的类数,并注意背景类。学习率比从头训语义网更小,否则冲掉检测预训练。
图 三张工牌并行
四、接到项目
数据是每图一组多边形加类别,导出框为外接矩形。评估用实例级交并比匹配,不是像素 mIoU 单张图糊弄。后处理可能再对掩码开运算。若个体几乎不重叠且圆,第 3.2 节分水岭可能更便宜,把 Mask R-CNN 留到重叠与遮挡变严重时再上。
五、标注框与掩码必须同一口径
外接矩形应紧贴掩码还是留边,规范写死。训练时若框从掩码现算,和标注员手画框混用,回归头会无所适从。导出数据时用同一脚本从多边形算框。掩码超出框的像素,Align 时根本看不见,等于无监督,抽检要抓这种脏标。
推理阈值与非极大值抑制在验证集扫网格,选 F1 或漏检约束下的点,冻结到部署。现场再拧阈值可以,但要当配置版本,并回归测试。预训练模型的类空间与你的 id 映射表单独存,切勿假设「类 1 都是人」。
拥挤场景:提议不够会漏,抑制太狠也会漏。适当提高每图提议数,再靠分数过滤。速度会掉,这是计数产品该付的钱。几乎不重叠的圆,第 3.2 节可能更便宜,把 Mask R-CNN 留到遮挡出现。
问题:能只训掩码头、冻检测头吗?
可以当策略:检测已够用、只缺形状时。若检测本身漏,冻检测头救不了。看三项损失哪一项不降,冻另一项。总损失一个数会掩盖。
评估用实例级匹配,阈值写进报告。像素 mIoU 可以把两个粘连实例当一块,分数仍好看。计数合同必须看匹配后的召回。后处理开运算对实例掩码同样有效,核仍按最小物体量。
先跑预训练推理通可视化,再微调。推理不通时微调只是在黑暗中加噪声。这是动手优先在实例任务上的具体化。
六、三项曲线分看
分类、框、掩码分列。掩码只在正样本真类通道上算。框与掩码标注同一脚本从多边形导出。掩码超出框等于无监督。阈值与抑制在验证集扫完冻结。预训练类空间映射表单独存。拥挤提高提议数。不重叠圆可先用分水岭。先预训练推理通可视化再微调。评估用实例匹配,像素 mIoU 会把粘连当一块。
三项分列。框掩码同一导出脚本。超出框当脏标抓。阈值抑制冻结。类空间映射表。先推理通再微调。实例匹配评估。不重叠圆可分水岭。正样本才有掩码损失,负样本曲线若也在降,说明实现把背景框算进了掩码项,应停训修代码。每图提议数在拥挤场景是产品旋钮,与学习率分开扫。
三项损失分列日志。导出脚本单点生成框与掩码,禁止两套工具。脏标检测:掩码像素在框外占比超阈进隔离。阈值抑制网格结果冻结进契约。类映射表缺省失败。推理不通禁止微调任务进队列。评估调用实例匹配,像素 mIoU 只作辅列。分水岭后备写明适用「不重叠圆」。掩码项在负样本应接近不贡献,单测造负样本验证。提议数网格与学习率网格分开。拥挤场景黄金图含紧贴个体。框回归与掩码相互牵制时先看框 AP,框歪先修检测再怪掩码头。预训练推理可视化进合并请求,与单图过拟合附件同类。
反例档案:负样本掩码项也在降,背景框被算进去。单测负样本后修实现。第二份:框从别的工具来,掩码从多边形来,不对齐。单点导出脚本后消失。推理不通仍微调,队列浪费。预训练可视化成为门禁。实例匹配为主列,像素 mIoU 降为辅,计数合同才诚实。
口令卡:三项分列、单点导出、框外占比隔离、阈值冻契约、映射表缺失败、推理通才微调、匹配主列、负样本单测、提议与学习率分扫、紧贴黄金图。框 AP 先于掩码头。预训练可视化门禁。
插模块前:三项分列、单点导出、框外隔离、映射表、推理可视化附件、负样本单测、匹配主列。微调队列检查推理通标记。提议数与学习率分网格。紧贴个体在黄金图。框 AP 差时不开放掩码头大学习率。计数合同看匹配召回。不重叠圆可走分水岭后备并在选型表写明。
交付门禁寅
三项不分立不准训。非单点导出不准训。框外占比无隔离不准训。映射表缺失不准训。无预训练可视化不准微调。负样本掩码项仍贡献则实现失败。评估主列不是实例匹配则合同口径错。框 AP 差仍放大掩码学习率退回。拥挤黄金图缺失退回。计数看匹配召回。不重叠圆走分水岭必须在选型表写明后备。
现场抽问:三项分列了吗?导出是不是单点?框外进隔离了吗?映射表在吗?可视化附件在吗?负样本单测过了吗?主列是匹配吗?框 AP 差还放大掩码学习率了吗?拥挤黄金图在吗?计数看的是召回吗?分水岭后备写在选型表了吗?
失败演练癸:三项合成一个标量就开训,应拒。两套工具导出框和掩码,应拒。框外像素无隔离,应拒。推理不通进微调队列,应拒。负样本掩码项还在降,应拒。合同看像素 mIoU 却要计数,应拒。框很歪仍猛训掩码头,应拒。拥挤场景无黄金图,应拒。映射表空,应拒。选型表不写分水岭后备却在圆目标上浪费检测算力,应在评审里问一句为什么。
队列门禁:三项分立、单点导出、框外隔离、映射表、推理通、负样本单测、匹配主列、框 AP 门槛、拥挤黄金图、计数口径。缺一门不准进微调。圆目标不写后备要在评审被问。
微调队列十门全过才能排队。计数合同若仍写像素重叠,门禁在评估主列处拦住。圆目标不写后备会在评审被问,问完必须补选型表或改任务类型。框 AP 门槛未达不准放大掩码学习率。
十门队列门禁与评审问题清单放在同一页。计数口径拦在主列。后备未写则圆目标任务改走第 3.2 节或补表。框 AP 门槛未达时掩码学习率锁定。
评审问题清单与十门门禁同一页打印。门槛未达则掩码学习率锁定为骨干学习率以下。圆目标补表或改走分水岭,二选一写进选型表单元格,不许空白。
实例头要同时出框、类别和掩码,缺掩码分支就不是本任务。正负样本比例与掩码分辨率写进配置,改一处重跑黄金实例图。
本章回顾
- 检测加掩码:名单先有,填色在后
- RoI Align 保对齐:量化取整会让小物体错位
- 三项损失分看:总损失会掩盖偏科
- 阈值与抑制是产品旋钮:在验证集扫
- 预训练起步:小数据不要从头训提议网络
- 框与掩码标注口径要一致
下一节用注意力编码器和提示式大模型辅助标注:不一定替换你的小模型,但能缩短第 2 章的人工时间。