第一章·时间序列到底在研究什么
第一章 · 时间序列到底在研究什么
本章要回答的三个问题:为什么"按时间排好的一列数"需要单独一整套分析方法?它和横截面数据到底差在哪?面对脏兮兮的原始数据,第一步该做哪些现场勘查?
为什么会有这一章
我接触过不少把"时间序列分析"当成"加一个时间列做回归"的工程师,结果做出来的销量预测在双 11 之前给出"平稳增长"的可笑结论。问题就出在没有先回答"时间序列到底在研究什么"这一基本问题——它研究的是一个变量在时间维度上的自相关结构,而横截面回归默认样本之间相互独立,这条假设在时间数据上几乎必然被打破。
数据分析师小李的踩坑经历很典型:他用 2018–2019 的日销量数据训练一个随机森林,特征是"星期几、是否节假日、月度价格",2020 年春节前的预测误差直接翻倍。复盘发现,他用的 24 个月历史数据里有"春节效应"在训练集里出现不到 1 次完整周期,模型根本没学到"春节前 7 天销量会阶梯式上升"这个事实规律。这就是没把时间序列当"案件"看的代价——没有勘察现场就破案。
本章作为整套教程的"勘查现场"环节,为后续的成分拆解、建模、评估打基础。我们会从时间序列的工程定义出发,建立"侦探视角"——任何一段观测序列都是一份现场证据,关键是要从时间戳、自相关结构、采样频率三个维度还原它的本来面貌。读者读完本章后将具备一项关键能力:拿到任何时间序列,能在动手建模前 10 分钟内完成"现场勘查"——确认频率、补齐缺失、识别异常、初步判读自相关结构。
读完能解决什么
- 听到"时间序列"时,能立刻说出它和横截面数据的三个本质差异。
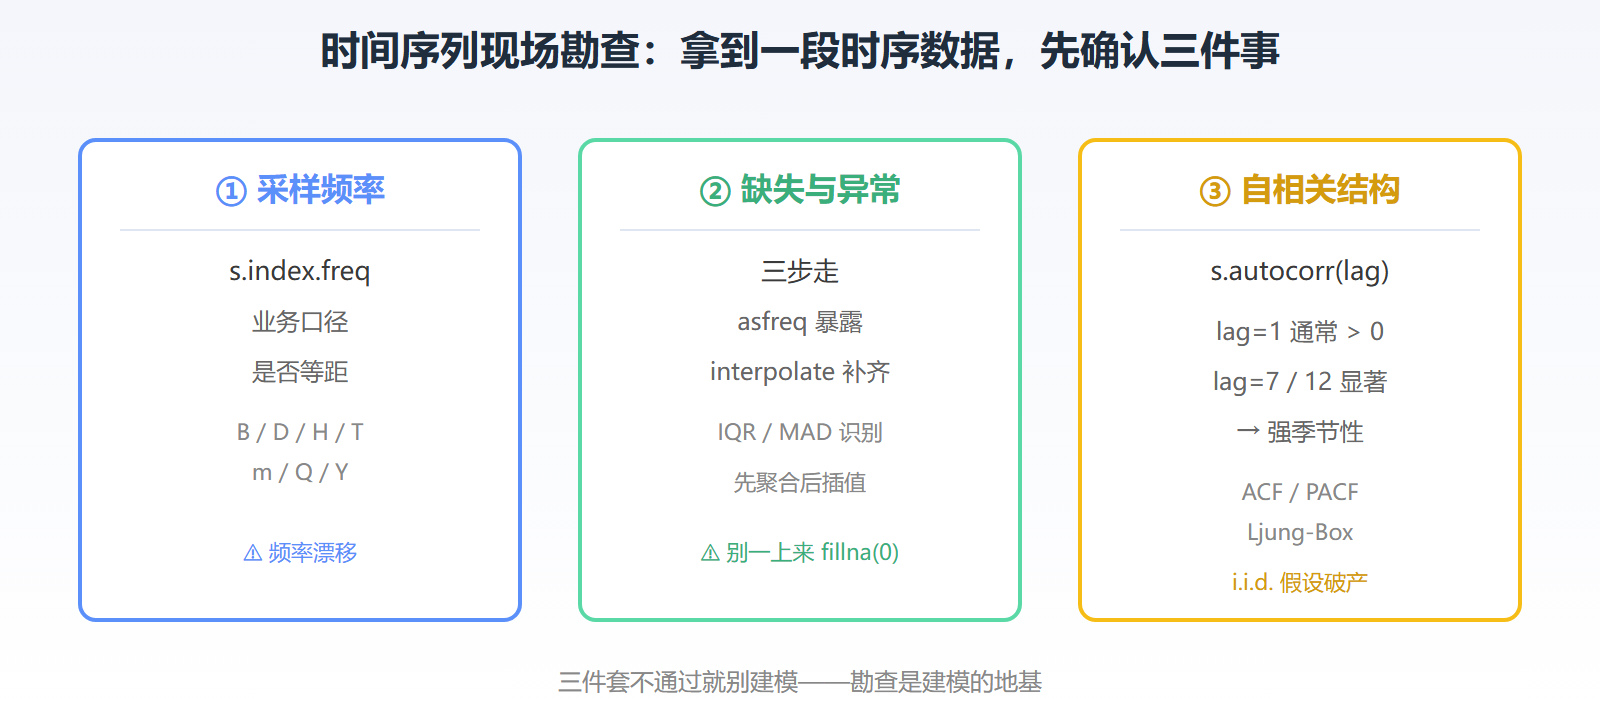
- 拿到一份带时间戳的原始数据,能在动手建模前完成"采样频率 / 缺失值 / 异常值"三件套勘查。
- 能解释为什么"用昨天的值预测今天"是一个合理起点,也能说清楚它的局限。
知识地图
一句"金句"点题:时间序列不是普通表格数据,它是按时间顺序排列的、有自相关结构的特殊证据链。
各节怎么分工
1.1 什么是时间序列
形式化定义时间序列;与横截面数据的三条本质差异;用 pandas 现场勘查一段股价数据,确认 DatetimeIndex 与自相关。
1.2 为什么需要专门方法
三个反例(股价随机游走、销量周季节性、趋势漂移)证明"专门方法"不是理论洁癖,而是工程刚需;给出"朴素基线常常胜过复杂模型"的反直觉结论。
1.3 数据类型与预处理
缺失、重复、异常、采样频率漂移四类污染;三步走"先暴露再补齐再识别";可视化自检永远不可省。
先决条件
- 熟悉 Python 基础语法与 pandas 的 DataFrame 操作。
- 对概率统计有基本概念(期望、方差、相关系数),不必精通推导。
- 已安装 numpy / pandas / matplotlib;本章会首次引入 statsmodels。
现场勘查三件套
往下走到哪
本章结束后,你将带着"时间序列不是普通表格数据"这个认知进入第二章。第二章会把这"一列数"拆成趋势、季节、周期、噪声四个嫌疑犯,并教你怎么用加法或乘法模型把它们的贡献分开。这一步没走稳,后面所有的 ARIMA、Prophet 都将是空中楼阁。
本章与其他章的衔接
第 1 章是本册的"导入章节"——它不直接讲趋势、季节、建模,它回答"为什么需要这些工具"。读完第 1 章后,读者应该带着"数据有时间维度的特性"这个认知进入第 2 章。第 2 章会立刻把"时间"这个抽象概念拆成 4 个具体可测的成分:趋势、季节、周期、残差。如果第 1 章没把"时间不是普通维度"讲透,第 2 章的拆分就显得突兀。
本章不解决的问题
第 1 章不教具体的统计方法(如 ADF 检验),不教 Python 库(如 statsmodels),也不教建模技巧(ARIMA/Prophet)。这些都留给后面章节。本章只做一件事:建立"时间序列是一个独立学科"的认知基础。
学完本章的检查点
打开任意一段业务数据(如过去 90 天的日销量),如果你能立即回答"它的频率、它有没有缺失、它有没有采样不均",说明你具备了进入第 2 章的预备知识。如果答不上来,再回头读一遍 1.1-1.3 节。