第七章·应用、评估与高阶
第七章 · 应用、评估与高阶
本章要回答的三个问题:模型预测得"好"怎么量化?预测区间和置信带有什么区别?面对一段业务数据,常见的应用场景和异常检测怎么做?
为什么会有这一章
第六章介绍了 STL、Prophet、ARIMA 等建模方法。但建模只是起点——业务上更关心"模型在测试集上表现如何"、"预测区间宽不宽"、"哪些点是真异常"。本章把"评估 + 应用"这两块工程内容整合起来。
读完能解决什么
- 用 MAE / RMSE / MAPE / R² 等指标评估模型。
- 区分"预测区间"与"置信带",理解它们的统计含义。
- 处理时间序列的异常检测和非平稳补救。
知识地图
一句"金句"点题:模型不是终点,业务上的"好"必须用业务可解释的指标量化。
各节怎么分工
7.1 评估指标
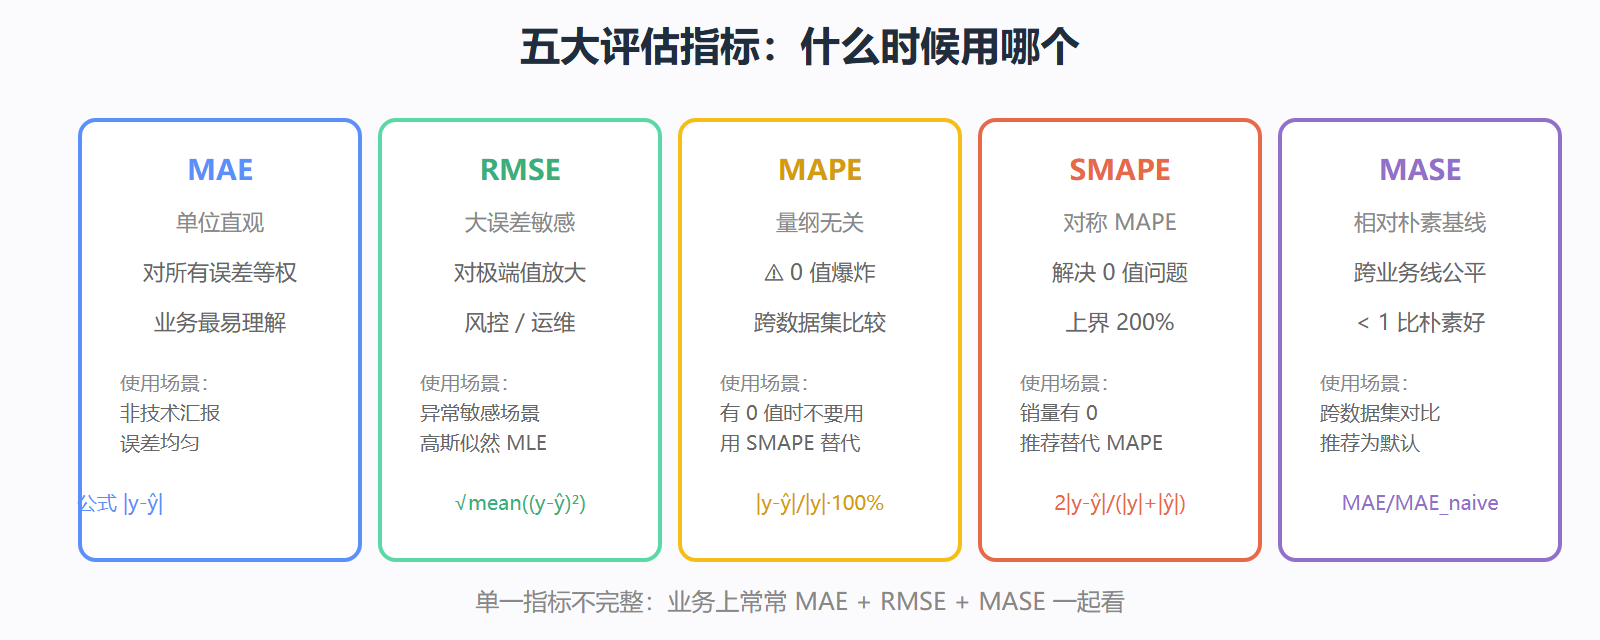
MAE / RMSE / MAPE / SMAPE / MASE 五种指标的适用场景与单位敏感性;系统偏差分析(MBE)。
7.2 预测区间与置信带
预测区间(未来单点)vs 置信带(未来均值)的统计差异;Bootstrap 校准更鲁棒;过度自信的工程问题。
7.3 应用场景
经济预测(5–10 年周期)、销售预测(日 / 周季节、促销)、资源管理(多重季节、容量余量)、异常检测(罕见事件、解释难)四类典型应用。
7.4 异常值检测与非平稳处理
STL 残差 / 滚动 Z-score / Isolation Forest 三种异常检测;ADF / KPSS / PP 平稳性检验组合;差分阶数兜底决策。
先决条件
- 已完成第六章,能跑 ARIMA / Prophet / Holt-Winters。
- 对统计学基本概念有掌握(置信区间、p 值)。
评估指标的能力对比
往下走到哪
本章是教程的收尾。第八章(如果后续扩展)会进入多元时间序列、GARCH、神经网络方法等更专门的话题。
本章在四成分中的位置
第 7 章是"应用与高阶"——它把前 6 章的模型方法落地到 4 大业务场景(经济/销售/资源/异常检测),并补上评估指标和高阶话题(异常值/缺失值/多元时间序列)。
与第 6 章的衔接
第 6 章讲建模方法(学完了"怎么建")。本章讲评估指标(学完了"怎么评")和应用场景(学完了"用在哪儿")。两章一起回答"模型建好了,怎么上线、怎么监控"。
本章的应用视角
4 大场景(经济预测、销售预测、资源管理、异常检测)的数据特性差异极大:
- 经济预测:低频、慢变、长周期
- 销售预测:中频、强季节、业务事件多
- 资源管理:高频、强周期
- 异常检测:关心残差,预测不是首要目标
不要把一种场景的"最佳实践"硬套到另一种上。
本章的高阶话题
7.4 节讲异常值检测与非平稳处理。这两个话题的共同点是"标准时间序列方法不直接处理它们,需要特殊设计"。本节给出常见应对(差分、抗差回归、Kalman 滤波等)。
学完本章的检查点
打开任一业务问题(如"预测下季度销量"),如果你能说出"我用什么模型 + 什么评估指标 + 怎么处理异常"——你具备了把时间序列应用到生产的能力。