1.1 模型性能的三把尺子
1.1 模型性能的三把尺子
本节摘要:判断一次调参有没有效果,先问"用什么尺子量"。本节把模型性能拆成三把互不相同的尺子——泛化表现、偏差偏差结构、任务目标函数,帮你按场景选对度量衡,避免拿着精度的卷尺去量回归的腰围。
学习目标
阅读完本节,你应当能够:
- 说清"泛化能力"为什么比"训练集得分"更值得作为性能基准。
- 用偏差方差分解解释模型性能波动的来源。
- 在分类与回归任务中挑选正确的评估指标,并知道各自唱反调时的取舍。
一、问题是"量错了",不是"没调够"
继续上一节的场景:调了一下午参数,验证集分数上去了几个百分点,你兴冲冲把模型拿去交付,结果真实场景里大跌眼镜。问题通常不在旋钮拧得不努力,而在你用来判断成败的那把尺子从一开始就量错了。
我在给团队做复盘时见过最多的错法,是把"准确率"当万金油。遇到舆情分类这种类别很不均衡的活儿,90% 的样本是"非敏感",你把所有样本都答成"非敏感",Accuracy 照样能到 0.9,人却一点用没有。这时尺子失效了,实验中收集到的所有"进步"都是幻觉。
所以进实验室的第一件事,不是调参,是校准度量衡。
二、三把尺子,各管一段
我们可以把衡量模型性能、判断调参成败的度量衡归成三把,它们不是同一把卷尺的不同刻度,而是三条独立的轴上各取一样:
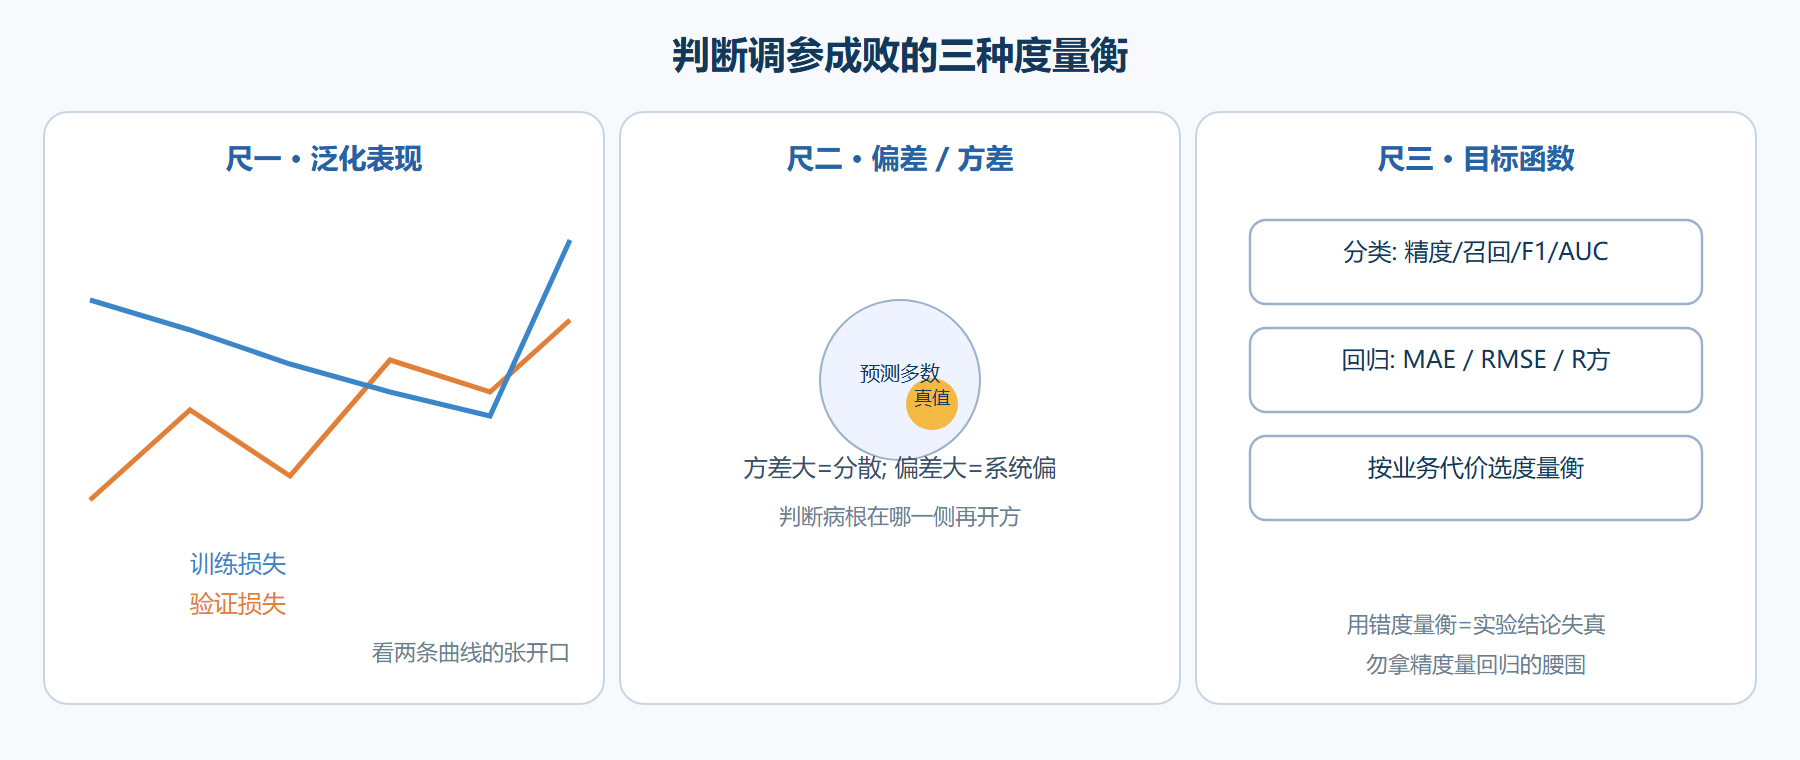
模型性能的三把尺子:泛化、偏差方差、目标函数
尺一:泛化 vs 拟合,分看两条曲线
泛化能力的可信观测只有一个:在没参与训练的数据上的表现。我们以后会一遍遍强调"留出一份测试集,最后才碰"的纪律,正是因为这把尺子只认「没见过的数据」。训练集上再漂亮的曲线,都只在证明模型把老题背下来了。你要看的永远是训练损失与验证(或测试)损失两条曲线之间的剪刀口:张口小且都低,是走上正轨;张口越拉越大,是过拟合在逼近;两边都下不去,是欠拟合。
尺二:偏差与方差,告诉你"病根在哪一侧"
把误差拆开,几乎每种性能差都能归到两顶帽子下面。偏差高,是模型的假设太简单,欠拟合,一笔画不出复杂的函数;方差高,是模型对训练样本太敏感,换一点数据预测就剧烈抖动,即过拟合。判断方法:训练不足且两边都差 → 偏差主导;训练集好、验证集差 → 方差主导。这一把尺子决定了你去拧哪个方向的旋钮(加容量还是加正则),是后面第八章诊断的基础。
尺三:目标函数,让指标为业务服务
泛化与偏差方差告诉我们模型"学得怎么样",但"怎么样才算好"由任务目标定。分类任务里,就是精度、精确率、召回率、F1 与 AUC 之间的权衡;回归任务里,就是 MSE、MAE、R平方之间的取舍。选错目标函数,等于给马拉松配了个百米秒表。举一个反复出现的例子:垃圾邮件识别,漏放一封骚扰邮件 vs 误杀一封重要邮件,代价天差地别——这时候精确率与召回率的偏置,比一个笼统的 Accuracy 更能代表你的利益。
三、按任务选尺子:一张决策表
| 任务形态 | 首选尺子 | 补充该盯的 | 常被误用的尺子 |
|---|---|---|---|
| 类别均衡的分类 | 准确率 Accuracy | 混淆矩阵 | — |
| 类别不均衡分类 | F1(宏观或加权) | AUC、PR 曲线 | 裸 Accuracy |
| 抓重要事件优先 | 召回率 Recall | 漏报率 | 精确率 |
| 避免误伤优先 | 精确率 Precision | 误报率 | 召回率 |
| 回归 | MAE(量纲直观) | RMSE、R平方 | — |
| 排序/打分 | NDCG / AUC | 顶部长尾表现 | 平均绝对误差 |
选尺子的原则一句话:先想清楚"误判错在哪一头更贵",再回填指标,而不是先挑个顺眼的数字。
把三把尺子放回一起看,它们其实回答的是三个层次的问题:尺一(泛化 vs 拟合)回答"这个模型在没见过的数据上靠不靠得住",尺二(偏差 vs 方差)回答"如果不行,是病在哪里",尺三(目标函数)回答"到底怎样才算对业务好"。很多人调参只盯着尺三的数字涨没涨,却忘了先背过尺一和尺二——于是分数很好看,却既不知道它是不是过拟合来的,也不知道它是否真的贴合业务代价。正确的打开方式是三层都要挂:每次调参前先问"我当前最想进步的尺子是哪一把",再动手,才不会拧了半天拧错了对象。
还要提醒一种隐蔽的自我欺骗:为了"数字好看"而去迁就指标。比如老板只看 Accuracy,你就把类别不均衡的数据按照负样本下采样去硬凑 Accuracy,结果线上召回掉得厉害。这类"为指标而指标"的动作,表面是优化,实则是把业务代价丢在了一边。所以选尺子时不只要选"好看"的,还要选"能体现业务代价"的——宁可它难看一点,只要它诚实。这在本册反复出现的"用验证信号判据、别让指标骗你"里,是最先要过的一关。
⚠️ 常见坑:把同一个指标既当"拟合信号"又当"泛化信号"。训练时盯着训练损失看收敛,评估时只看验证指标——两者必须分开,混着看会让你的实验结论失真。
💡 关键直觉:多准备一套"业务口径"指标,比如阈值给到哪个百分比。模型参数调完,最后一步往往是靠这个口径做部署判断的,而不是看那个 continue 调参用到的 F1。
还有一个常被忽略的执行细节:同一把尺子也要先确认"相机稳定"再读数。用多随机种子跑几遍,看同一组超参下的分数抖动有多大——如果抖动的量级已经盖过了两次调参之间的差异,那你这段时间的"进步"多半是噪声在喊你。给尺子配一个"多种子方差的基线",比盯着单次分数少了自欺的机会。这一条和后面调参心法里"信号要稳"是一脉相承的:尺子是稳的,拧旋钮才有意义。
本节要点回顾
- 要点一:泛化能力只能在未见数据上观测,训练集分数不构成性能证据。
- 要点二:误差 = 偏差 + 方差 + 噪声,先判断偏差高还是方差高,再决定拧哪边。
- 要点三:分类用精度/召回/F1/AUC,回归用 MAE/RMSE/R平方,按业务代价选。
- 要点四:类别不均衡时,裸 Accuracy 是陷阱,优先 F1 与 AUC。
- 要点五:拟合信号与泛化信号要分开盯,防止实验环境自我欺骗。
下一步,把这三把尺子嵌进"训练-验证-测试"的闭环里,调参结论才站得住。