1.2 训练调参评估如何闭环
1.2 训练调参评估如何闭环
本节摘要:上一节我们校准了度量的尺子,本节把训练、调参、评估装进同一个可重复的闭环里。核心是一条纪律:训练集负责拟合、验证集负责调参、测试集只在最后碰一次。我们需要把数据集切分想清楚,并结合交叉验证让结论更稳。
学习目标
阅读完本节,你应当能够:
- 画出训练、验证、测试三者的分工与数据流向,解释为什么"最后才碰测试集"。
- 说清验证集信号对调参的决定性作用,以及信号泄漏的几种典型路径。
- 在数据集偏小时改用交叉验证,并知道它与单次留出法的取舍。
为什么会有这一章
上一节我们有了三把尺子,但尺子要架在一个稳定的台面上才有意义。真正动手时你会发现,问题常常不是"不会量",而是"台面在晃动"——同样的模型、同样的参数,今天 .73 明天 .71,你根本分不清是进步了还是噪声大了。晃动通常来自一个源:你把测试集(或验证信号)用得太勤了。
三个房间,三种用途
把文本切成三块,这是整个实验舱的物理地基。
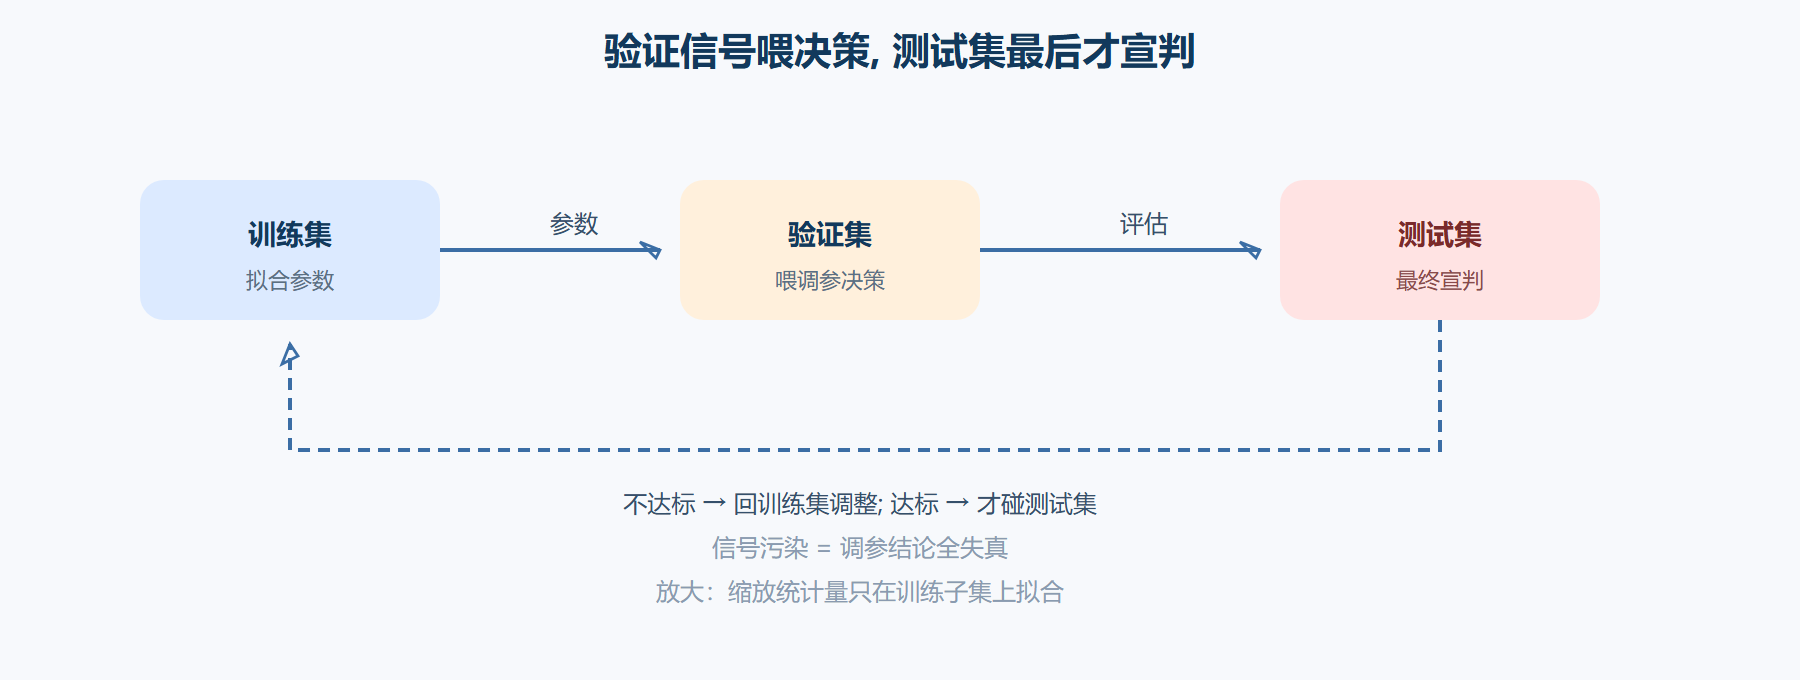
用一句话记住分工:训练集喂模型,验证集喂调参决策,测试集喂最终宣判。后面你会看到,逐字地守住这三者的隔离,比任何花哨算法都更能保住你的心理卫生。
训练-调参-评估的闭环回路
验证集信号为什么会“漏”
泄漏的路径很隐蔽,常见三种。一是早停与超参选择看同一份验证,看得太多,验证集渐渐被"背下来",成了变相的第二份训练集;二是手工调参或自动化搜索反复用同一验证,模型评估次数越多,越容易在验证上取得偶然高分;三是特征工程阶段就已经偷看了整份数据(包括测试)的统计量,比如标准化用的均值和方差是在全量上算的,边界信息提前走漏。守住的方法就是那条纪律:缩放统计量只在训练子集上拟合,验证与测试只是套用。
划开数据:分层、留出与交叉验证
划分不是随便切一刀。分类任务要做分层划分,让每个子集里各类别比例与原数据接近,否则某个子集可能极端缺某一类,指标被噪音主导。偏序或时间序列数据,则要按时间切,绝不能随机抽——否则未来信息混进训练集,得到的评估虚高,真实预测全崩。
单次留出法(一次性切 70/15/15 之类)便宜、直观,但数据量一少,单次划分的方差就大——你兴许只是切出了一个"恰好好"的子集。这时换K 折交叉验证:轮着把数据切成 K 份,轮流留一份当验证、其余训练,最后把评测结果平均。代价是训练 K 次,时间翻倍;换取的是结论更稳、偏差更小。
交叉验证并不改变"测试集最后碰"这条纪律:K 折通常是拿来做调参选型的,选出的最优组合最后仍要在那个一次都不参与调参的独立测试集上复核一次。
调参的回路怎么转
把以上装成一圈,就是本册反复出现的回环:
- 训练集上把模型训到参数收敛。
- 在验证(或 K 折)上读出性能信号。
- 根据信号决定下一步:改超参数、换特征、加正则,回到第 1 步。
- 觉得满意后,在从没参与过以上任何决策的测试集上做最终宣判。
- 只有这一步通过,模型的结论才算可信。
实测:这里最容易漏的三道缝
闭环写得再明白,落到代码里还是会漏,最常漏在三处。第一道缝是预处理统计量算得"太早"——很多人习惯先把标准化、缺失填补拟合到全量数据上,再切三份去训练,可这一步已经让每一轮评估偷看了不该看的分布信息。正确顺序永远是"先切分、再只在训练子集上拟合统计量、最后把参数搬到验证与测试"。第二道缝是把验证集当训练集反复用——交叉验证本身没问题,但若你在同一批 K 折上反反复复调了上百次,验证信号也早已被"背熟",最终报告那个分数会是虚高。第三道缝最隐蔽:手工复制粘贴数据时把测试样本混进训练/验证目录。听起来低级,实战里却真会发生,一旦发生,你后面所有结论都建立在幻觉上。
针对这三道缝,推荐立三条手则:①一切拟合类操作只发生在训练子集;②记下验证/交叉验证被"用"了多少次,逼近预算上限就停,不再回头;③切分后给三个子集打上可校验的标记(如校验一次每份的样本量与分布),复制搬运后先自检再训练。这三条都不贵,却能把你最可能踩的泄漏错误挡在训练开始之前。
⚠️ 常见坑:交叉验证时把"模型多次在验证集上的最好分数"用于宣判,仍属于对验证集过度适配。真正的做法是固定一版看很久,期间一次都不碰最终测试集。
💡 关键直觉:如果你只有一个固定实验预算(比如只能跑若干次全量训练),把其中大部分预算花在验证选型上、最后一次留给测试——预算管理也是实验设计的一部分。
把闭环最后跟"基线"勾连一下:第一版模型的验证分,往往就是整册调参里最珍贵的参照点。它像地图上的起点坐标,后面每一次"加容量提升了 X""加正则提升了 Y",都是相对它写下的。所以别嫌第一版又弱又土,先把这条基线立稳、把它的验证信号打好底,后面所有"值不值得"的判断才有参照。很多人恰恰倒在这一步——急着上复杂模型,却连一个能服的基线都没留。
本节要点回顾
- 要点一:训练/验证/测试三者用途严格分工,测试集只宣判不决策。
- 要点二:验证信号的泄漏会让调参结论虚高,常见于反复复用与统计量走漏。
- 要点三:分类做分层划分,时序/偏序按时间划分,别随机切片。
- 要点四:数据量小时用 K 折交叉验证替换单次留出法,用时间换结论稳定。
- 要点五:把调参回路建成闭环,每一步都只消费该消费的信号。
接下来,我们往实验台的原料端走——先把手里的数据洗净、工程化、划好界,模型才有稳的输入。