第一章 模型性能与调参实验舱
第一章 模型性能与调参实验舱
章节摘要:本章跟着一条线走——在还没有任何模型之前,先把"怎么判断一次调参实验算不算成功"的裁判定下来。我们从一个反复出现的挫败场景出发:你调了一下午参数,却说不清到底是进步了还是退步了。答案不是去试更多组合,而是先建立一套衡量与闭环的坐标系。
一条主线
起点是一个几乎人人踩过的坑:新手把"训练集上的分数"当成一切的见证,结果调参越调越虚,跑到测试集上一败涂地。这条主线要解决的就是——用什么尺子量模型、怎样判断一次改动是否真的有效。我们从两个层面立起来:第一,性能指标这套"三把尺子"(泛化表现、偏差与方差结构、判决点或阈值);第二,训练、评估、调参三者构成的可重复闭环。一旦这条主线立住,你后面的每一步都踩在稳的底座上。
这里最容易被忽视的是**"尺子"与"目标"分不清**。假设你做的是一个信用卡欺诈检测:如果不看正样本极少(极度不均衡),只盯着整体准确率(accuracy)去调参,你会得到一个"把所有记录全判成正常"也能有很高的假指标,可它根本不能拦截一笔欺诈。这就是第一章第一节要建立的第一个认知:度量衡必须挂到业务目标上。第二个认知是偏差方差的取舍:模型在训练集上贴得越紧,未必在陌生数据上越好,这条"欠拟合↔过拟合"的光谱决定了你后续是加容量还是加约束。第三个认知关乎"阈值的旋钮"——很多调参问题其实不用动网络,只要动最终判决点就能吃下相当一部分收益。
沿途站点
- 01 模型性能的三把尺子:先回答"用什么衡量模型"——精度不是唯一尺子,要结合泛化表现、偏差方差结构、任务的目标函数一起看,避免用错度量衡。这一节还会给一个"选指标决策树":分类、回归、排序、不均衡场景分别该看哪些数。
- 02 训练调参评估如何闭环:主线推进——把训练、验证、测试切清楚,理解"喂给调参的是验证集信号,测试集只在最后碰一次"这条纪律,以及迭代回路怎么转。重点是用"只有验证集信号能进旋钮"来约束你每天的调参习惯。
一台实验台的标准接线
把第一、二两节连起来看,整个实验舱其实就一条流水线:训练集喂给模型,验证集只用来做调参判决,测试集留到最后宣判。很多人之所以说不出"刚才这次改动到底有没有用",就是因为他把这条线接错了——拿训练分数当判据、或拿测试集反复确认,都会让读到的信号失真。下面这张图就是实验舱的标准接线,也是全年从头到尾反复要用到的坐标:
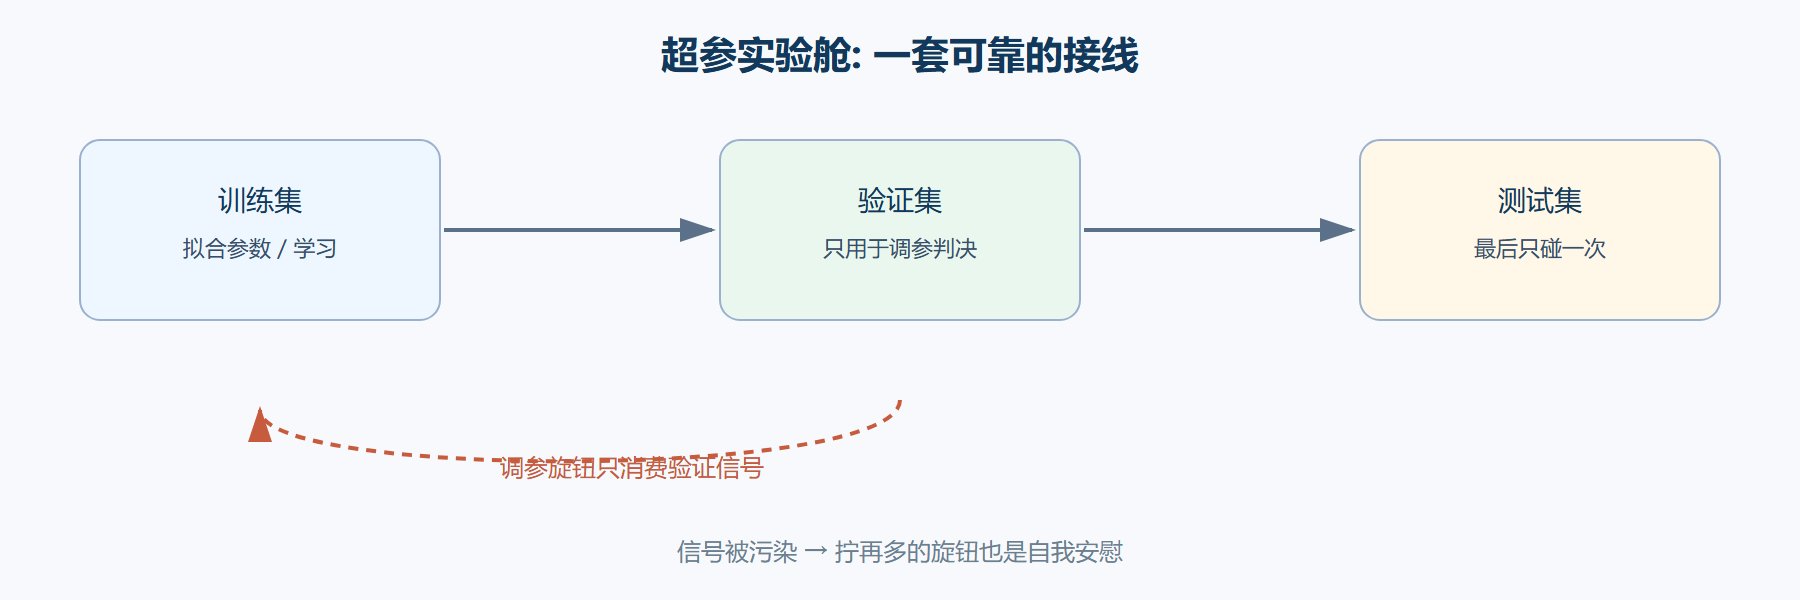
这张接线图告诉你:参数改不改,只信验证的读数。一旦善待了这条线,你在第一章学到的一切(三把尺子、闭环、判据纪律)才有了共同的操作台。
拐点与结论
本章最重要的认知转折是:调参实验的成败,取决于验证协议的可靠性,而不取决于你拧了多少个旋钮。一个信号污染的实验环境,会让所有后续的努力都建立在流沙上。结论是把"数据合理划分 + 信号不被污染 + 指标选对"当作进实验室之前先擦干净的操作台——这三件事完成了,你拧的每一个旋钮才有被量化的意义,否则一切都只是自我安慰。
读完你应该
- 能解释为什么训练集分数不能作为调参依据。
- 能在精度、召回、F1 与 AUC 之间按任务选出正确度量衡。
- 会用一张图说清训练、验证、测试三者的分工。
- 能说清"在什么前提下,一次调参的结论才可信"。
- 能把这个验证闭环迁移到任意新任务上先落地。
一个自测题帮你检验是否真的学会了:现在丢给你一个"医疗风险预测"项目,正样本只占 2%,你打算用 accuracy 做主要指标。读完本章,你应该已经能说出"这会误导决策,因为你把 98% 的全判阴性也能拿到很高的 accuracy,却没拦住真正该拦的那 2%"。如果你能脱口而出去换 AUC / 精确率曲线并说明代价,说明"三把尺子"你没有白读。
下一章的接力
主线从"怎么量"接力到"拿什么量"——第二章会把这台实验台的数据准备环节打通,告诉你喂给旋钮的"原料"(数据)如何清洗、预处理、特征化并合理划分,让第三章起的模型选型有可靠的输入。