第二章 数据准备与特征工程
第二章 数据准备与特征工程
章节摘要:本章跟着一条线走——把上一章立起来的实验台,接上"原料"这一端。模型能吃到的只是你给它的数据形态;垃圾进、垃圾出,这句老话在超参实验舱里尤其致命,因为一个没洗净或切错的数据,会让后续所有旋钮拧动的结果都失真。我们从最脏的原始数据出发,一路把它变成模型能下咽的特征。
一条主线
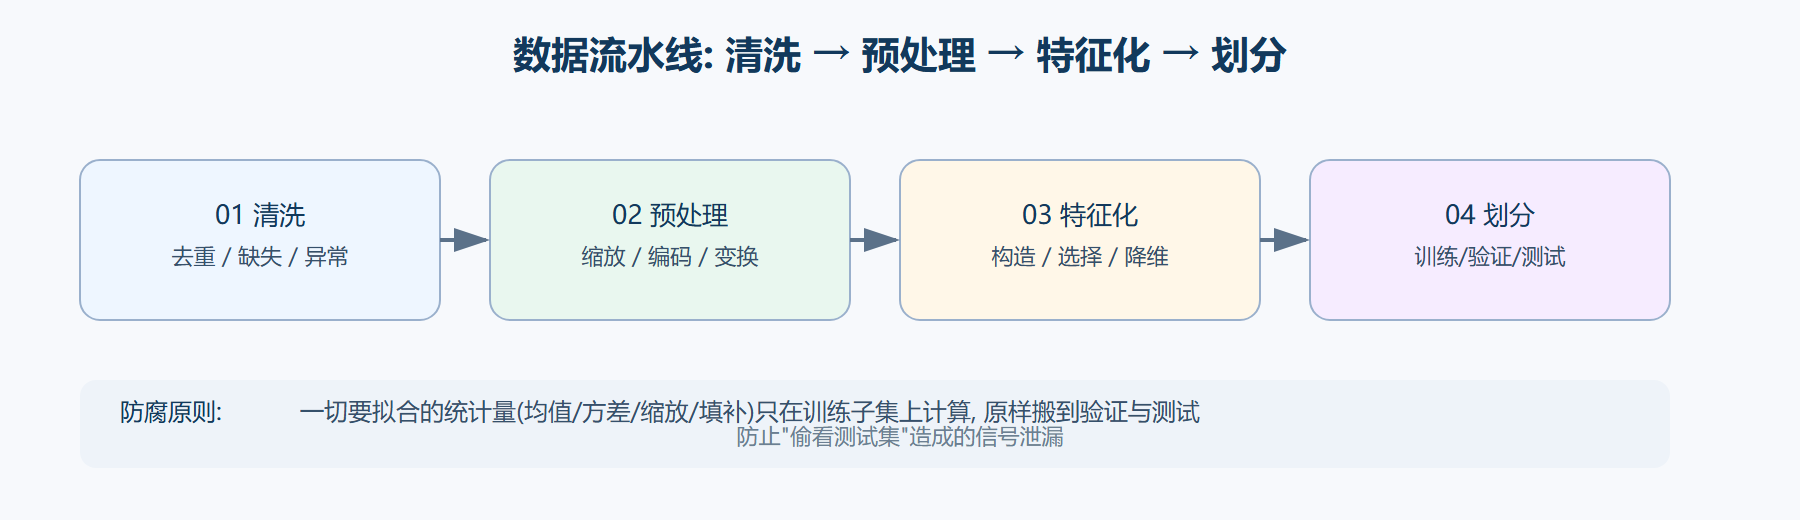
主线是数据的"可下咽度":原始记录带重复、缺失、异常,必须先清除;量纲参差、分布偏斜,必须预处理;原始字段表达不充分,必须特征化;最后还要把它合法地切分成训练/验证/测试。每一步都在为第一章的闭环铺路——数据切得对不对,直接决定验证信号可不可信。
这条主线最反直觉的地方在于:数据准备的时间投入通常占总时长的一半以上,但产出却最不被"看见"。一个典型的表格任务里,把数据弄干净、做成特征往往要花三到五天,而真正在模型上拧旋钮只占最后半天。可这个工作一旦做漏,后面所有模型的分数都是"假繁荣"。本章希望你先建立"耐心"——它不是体力活,而是决定实验有效性的地基。
沿途站点
- 01 数据收集与清洗实战:主线从拿到原始数据开始——来源核验、去重、缺失处理、异常值检测,先让数据"干净"。
- 02 数据预处理技术:推进到让数值"可用"——缺失填补、标准化、归一化、偏斜变换、类别编码。
- 03 特征工程方法:再往前让特征"更有信息"——构造、选择、降维与交叉,让模型更容易学到规律。
- 04 数据集划分与采样:主线收束——把洗好的数据合法地切成实验用的三份,兼顾分层与不均衡采样。
一条流水线的全貌
把四节连起来,数据这一端其实是一条必须按序走完的流水线——跳步、错序,都会在后面的实验里埋雷。尤其是"只在训练子集上拟合统计量、再把这套参数原样搬给验证和测试"这条防腐原则,直接决定了你后续读到的是真信号还是假繁荣:
拐点与结论
本章的认知转折:数据准备不是"谁都会的体力活",而是影响后续一切实验有效性的前提。最典型的教训是"缩放统计量偷看测试集"——这类看似无害的细节,会让验证报告给你的信心变成幻觉。结论是建立一条"清洗 → 预处理 → 特征化 → 划分"的流水线,并且每一步都只在训练子集上拟合统计量,把"偷看测试集"的隐患从源头上掐掉。
读完你应该
- 能手写一份缺失值、异常值、重复值的清洗清单。
- 能区分标准化与归一化,并决定何时应该做偏斜变换。
- 能列举特征构造、选择与降维的常用手段及适用场景。
- 能做一个既分层又拟合训练/验证/测试的划分。
- 能说出最小三种会造成信号泄漏的数据准备方式。
这一章最该在动手前读明白的一课是"泄漏"。 泄漏不需要什么高级操作,往往就在最普通的预处理里发生:你把整个数据集的均值、方差、缩放系数算完,再拿去切训练/测试——可"缩放用它自己的统计量"这件事,就已经让测试信息渗透进了训练。更隐蔽的还有"用全量数据做的缺失值中位数填充"。记住一条机械原则:一切要拟合的统计量,都只能在训练子集上算,然后把这套参数原样搬给验证和测试。本章第 2、4 节会反复回到这条线上。
顺带把这章在实验舱里的角色说一句:如果说第一章是"定裁判(用哪把尺子)",那么第二章就是"准备可用的原料(数据)"。原料的好坏直接决定裁判的数据靠不靠谱——清洗不干净、切分切错,后面再好再多的旋钮,读到的都是假信号。所以与其把这章当成"人人都会的体力活"快进,不如把它当作整册防泄漏纪律的第一现场:你在这里养成的"只在训练子集上拟合统计量、切分前先自检"的习惯,会在之后的每一章被反复调用。
下一章的接力
数据这台原料端备好后,主线转向"在这份数据上,用哪个模型、从什么起点开始训练"——第三章处理模型选择与初始化。