1.1 从感知机到多层网络
1.1 从感知机到多层网络
本节摘要:从 1958 年的单层感知机讲起,带你看它为何卡在"异或"这类简单问题上,而再加一层隐藏神经元就立刻开窍,并由此引出多层感知机的结构与一次前向传播。
这是整本书的起点,也是旁支众多第一章里最关键的一块基石。它承接导读里"前向是读"的说法——本节把"读"这件事内部的机械结构摊开:一个神经元把一堆输入压缩成一个数,再把这一层神经元拼成网络。
单层机器能算的东西极其有限
1958 年感知机被发明时,人们的兴奋和后来者的失望一样大。它本质上是一条独立的判决线:把输入加权求和,过一道阈值门,输出 0 或 1。它能分开"在线性可分"的数据——比如平面上有一群方点和圈点,只要能用一条直线切开,感知机就能学会。可一旦遇到异或这种经典的弯刀题:两点在 00 和 11 时属一类、01 和 10 时属另一类,任何一条直线都切不开它们。后人证明了这并非调参不努力,而是结构的上限——单层线性模型只有这么点本事。
解法也直白:不再让输入直接冲刺到输出,而是先经一层隐藏神经元"中转"。异或看似弯,却可以拆成两步直线:先让隐藏层分别表达"两者都是 1"和"两者都是 0",再让输出层把这两块拼回去。多一层,就从"画一条线"升级成"画一条折线",再到"画一块任意形状的区域"。
神经元:把一个数揉成的一个数
一个神经元做的事可以用一句话概括:加权求和,然后过一道非线性门。输入向量进入,每个输入乘上自己的权重,加上一个偏置,得到预激活值;预激活值再被激活函数(1.2 详谈)变成该神经元的输出。权重的大与小,决定了这个神经元对哪路输入"上心"、对哪路输入"爱答不理"。
一次前向:沿层把张量推过去
多层感知机把若干这样的神经元按层排布,层与层全连接。前向传播就是按顺序逐层计算,把上一层的输出当作下一层的输入,最后在输出层得到预测。下面这张图用一个只有一层隐藏层、两个输入、三个隐藏神经元、一个输出的最小网络,把权重标在连线上,方便你跟着走一遍。
图 1-1 一个带标注权重的极简多层感知机
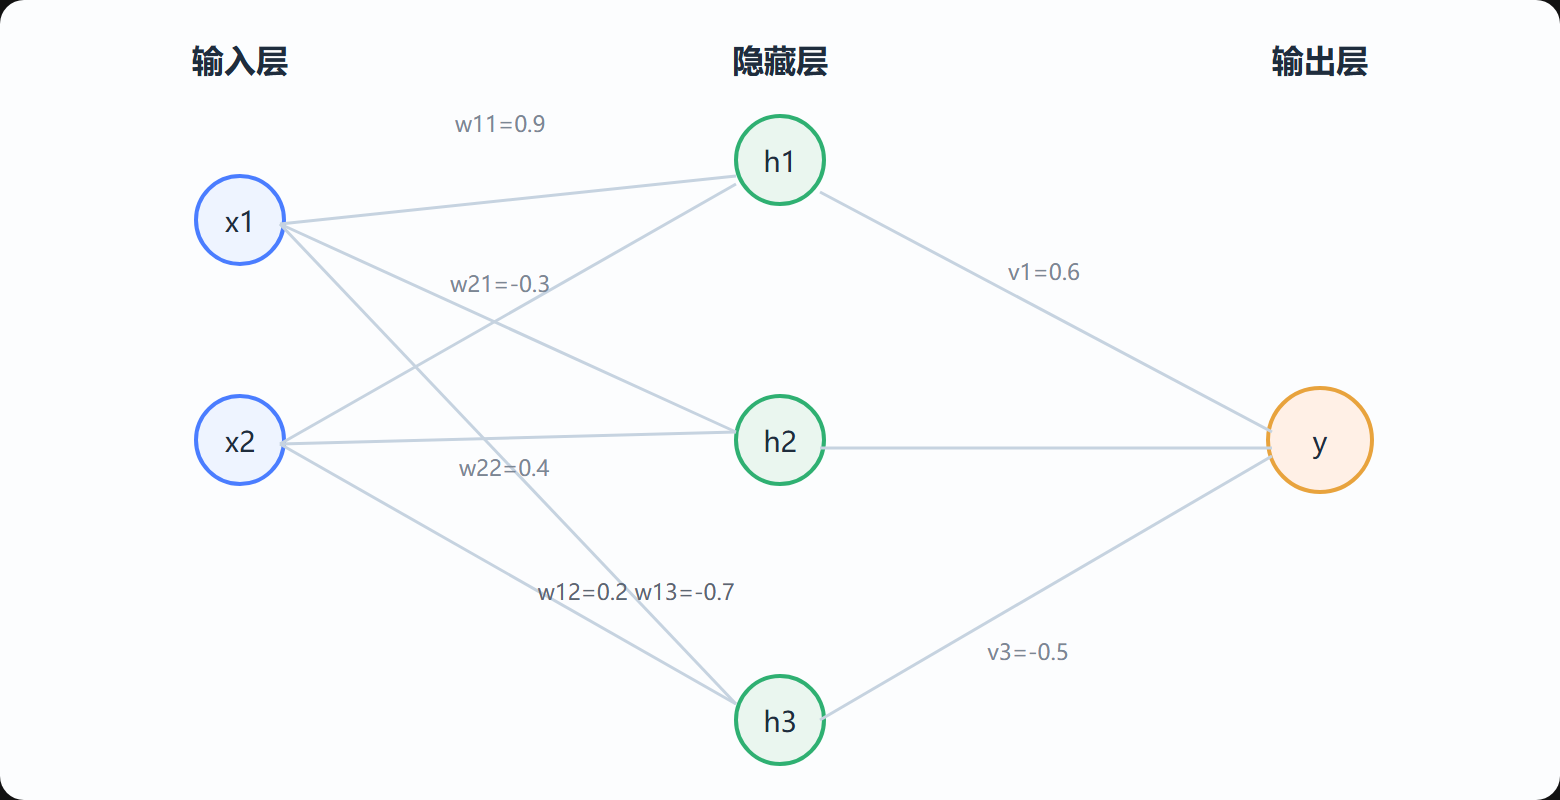
跟着这个数字走一遍:让 x1=1、x2=0,权重视为图中标的值,激活暂用最简单的一条恒等(即不激发),那么隐藏层各神经元的加权和依次算出,输出层的加权和也一路累出来。这一串"把上一层的输出喂给下一层"的动作,就是一次完整的前向传播。真实网络远比这张图宽和深,但走的逻辑一模一样。
用代码把一次前向敲出来
概念说一万遍不如敲一遍。下面是一份不依赖任何深度学习库、只用 NumPy 的最小多层网络前向实现,把上面的数学原封不动搬到数组上:
import numpy as np def sigmoid(x): return 1.0 / (1.0 + np.exp(-x)) X = np.array([[1.0, 0.0]]) # 一行一条样本,两个特征 W1 = np.array([[0.9, 0.2, -0.7], # 输入→隐藏层 权重 [-0.3, 0.4, 0.1]]) b1 = np.array([0.1, -0.2, 0.05]) W2 = np.array([[0.6], [0.3], [-0.5]]) # 隐藏→输出 b2 = np.array([0.0]) Z1 = X.dot(W1) + b1 # 隐藏层加权和 A1 = sigmoid(Z1) # 激活 Z2 = A1.dot(W2) + b2 # 输出层加权和 yhat = sigmoid(Z2)[0, 0] print("隐藏层激活:", A1[0]) print("预测输出:", round(yhat, 4))
运行后你会看到 A1 是三个介于 0 和 1 之间的数,yhat 是最终预测。W1、b1、W2、b2 合起来就是这网络的全部身家,也就是第2章里反向传播要逐个"发号施令"的对象。
网络越深,并不等于越好
多叠几层确实让表达能力变强,但也让两个问题浮出水面:一是参数多到难以手动定,必须靠算法自动调;二是梯度穿过多层时会变弱或变爆(第4章会和 RNN 一起重点讲)。所以"多层"和"好"之间从不画等号——这正好解释了为什么后来会演化出各种精巧结构。
手按计算器走一笔账
看不清矩阵烧直觉的人,拿笔走一次最稳。还是上面那张极简网络,取 x1=1、x2=0,权重用表里那组数字。隐藏层第一个神经元:0.9×1 + (-0.3)×0 + 0.1 = 1.0,过激活得 A1。同样算完三个隐藏神经元,得到一行三个激活值;再把它们分别乘上输出层那列权重再累加、加偏置,就得到输出层预激活,最后过一遍激活就是预测 yhat。下表把三个隐藏神经元的分步账摆齐,照抄即可:
| 位置 | 加权和计算 | 结果 |
|---|---|---|
| 隐藏神经元1 | 0.9·1+(-0.3)·0+0.1 | 1.0 |
| 隐藏神经元2 | 0.2·1+0.4·0+(-0.2) | 0.0 |
| 隐藏神经元3 | (-0.7)·1+0.1·0+0.05 | -0.6 |
你手算的结果应当和上一段代码里 A1 打印出的三个数一致。这一步"对得上"十分重要——它证明你理解的不只是概念,而是每一格数字从哪来。往后所有算法(CNN、RNN、Transformer)的前向都是同一句"把上一层输出喂给下一层",只是每层的算子换了花样,账的本质没变。
一个自查题
如果我把 x 换成 x1=0、x2=1,隐藏层三个预激活会各自变成多少?想清楚再往下翻结论:分别是 0.1、0.2、-0.15。若你得到别的数,多半是权重行和列没对齐——把 W1 看成"输入行 × 隐藏列"就能顺过来。
为什么偏置也要一起学
你可能注意到这里每个神经元除了权重,还挂着一个偏置偏置 b。它并非可有可无的尾巴:权重决定的是"这个神经元对哪路输入多上心"的斜率,而偏置决定的是"它在输入为零时先站在多高的基线上"。没有偏置,神经元的判决边界会被死死固定在过原点,能用直线切分的数据立刻少一大半。所以反向传播时,权重要改,偏置也要跟着改——它们俩合起来才完整定义了那一条边界的位置。往后每一层的算子再怎么换,这份"权重定方向、偏置定位置"的分工始终不变。
为什么偏置也要一起学
你可能注意到每个神经元除了权重,还挂着一个偏置 b。它并非可有可无的尾巴:权重决定的是"这个神经元对哪路输入多上心"的斜率,而偏置决定的是"它在输入为零时先站在多高的基线上"。没有偏置,神经元的判决边界会被死死固定在过原点,能用直线切分的数据立刻少一大半。所以反向传播时,权重要改,偏置也要跟着改——它们俩合起来才完整定义了那一条边界的位置。往后每一层的算子再怎么换,这份"权重定方向、偏置定位置"的分工始终不变。
本节要点回顾
- 感知机的上限是线性可分,遭遇异或这类问题就瘫了
- 加一层隐藏层,线性判决升级为区域判决,表达能力跃升
- 前向传播是逐层把上一层的输出当下一层输入,一路推到输出层
- 权重与偏置是一个神经元对每路输入"上心"程度的量化,也是以后唯一要被改的东西
- 多次层要付出梯度传播变难的代价,这是后续所有架构改良的原动力