1.2 激活函数——给梯度留条活路
1.2 激活函数——给梯度留条活路
本节摘要:激活函数是为前向传播注入非线性的开关,也是影响第2章反向传播健康度的第一道闸门。本节对比 Sigmoid、Tanh、ReLU 与 Swish 的曲线、梯度区间和暗坑(饱和、死亡神经元),并给出选型思路。
紧承 1.1 的结论:网络多了层不代表就有本事,还得靠一层叫"激活函数"的零件在每一层把线性变换打碎。本节我们把镜头对准这个零件——它不光决定前向的弯曲程度,还直接决定反向时梯度还有没有力气往回爬。
为什么两层线性叠起来还是线性
一个常见的误区是"层数越多越有能力,线性也不怕,反正量足"。可惜线性叠线性还是线性:如果每个神经元都不过非线性门,那么两层全连接压一压,本质上还是一层矩阵乘一层矩阵再乘一层矩阵——乘起来仍是个矩阵。换句话说,不管堆几层,纯线性网络最终做的还是加法和缩放,和单个线性模型没本质区别。非线性激活才是让网络真正能画曲线的那支笔。
激活函数做的事情不复杂:把预激活值 z 映射成一个输出,常见的几款长这样:
要不要非线性不是"花哨",是能力的分水岭。没有它,前面的感知机弯刀题永远解不开。
Sigmoid 与 Tanh:经典但不是全优
Sigmoid 把任意实数压到 0 到 1 之间,输出天然像概率,早期分类任务很常用;Tanh 把它压到负一到正一之间,且关于原点对称,训练中常比 Sigmoid 收敛更顺。它们的共同软肋在两端的饱和区:当输入离原点很远时,导数趋近于零,参数几乎"推不动"。这句话在第2章会被反复引用——饱和意味着此处的梯度约等于零,是梯度消失的温床。
ReLU:简单到粗糙,却极度好用
ReLU 把负数直接归零、正数原样放行:输入大于零时导数是 1,小于零时是 0。这个"半开半闭"的脾气带来了两个好处:正区间梯度恒为 1,穿层时不容易像 Sigmoid 那样逐层削薄;负数直接置零,让网络自动"稀疏"——一堆神经元闲下来,计算也省。但代价是死亡率:若权重把某神经元推向长期负区,它可能永远输出 0、梯度永远为 0,再也醒不过来,人称dead neuron(死亡神经元)。工程上常用 Leaky ReLU 或 PReLU 在负区留一丝坡度来缓教。
下面这张对比图把三种激活的曲线和导数区间画在一起,方便你一眼看出谁在哪段"手软"。
图 1-2 Sigmoid、Tanh、ReLU 曲线对比
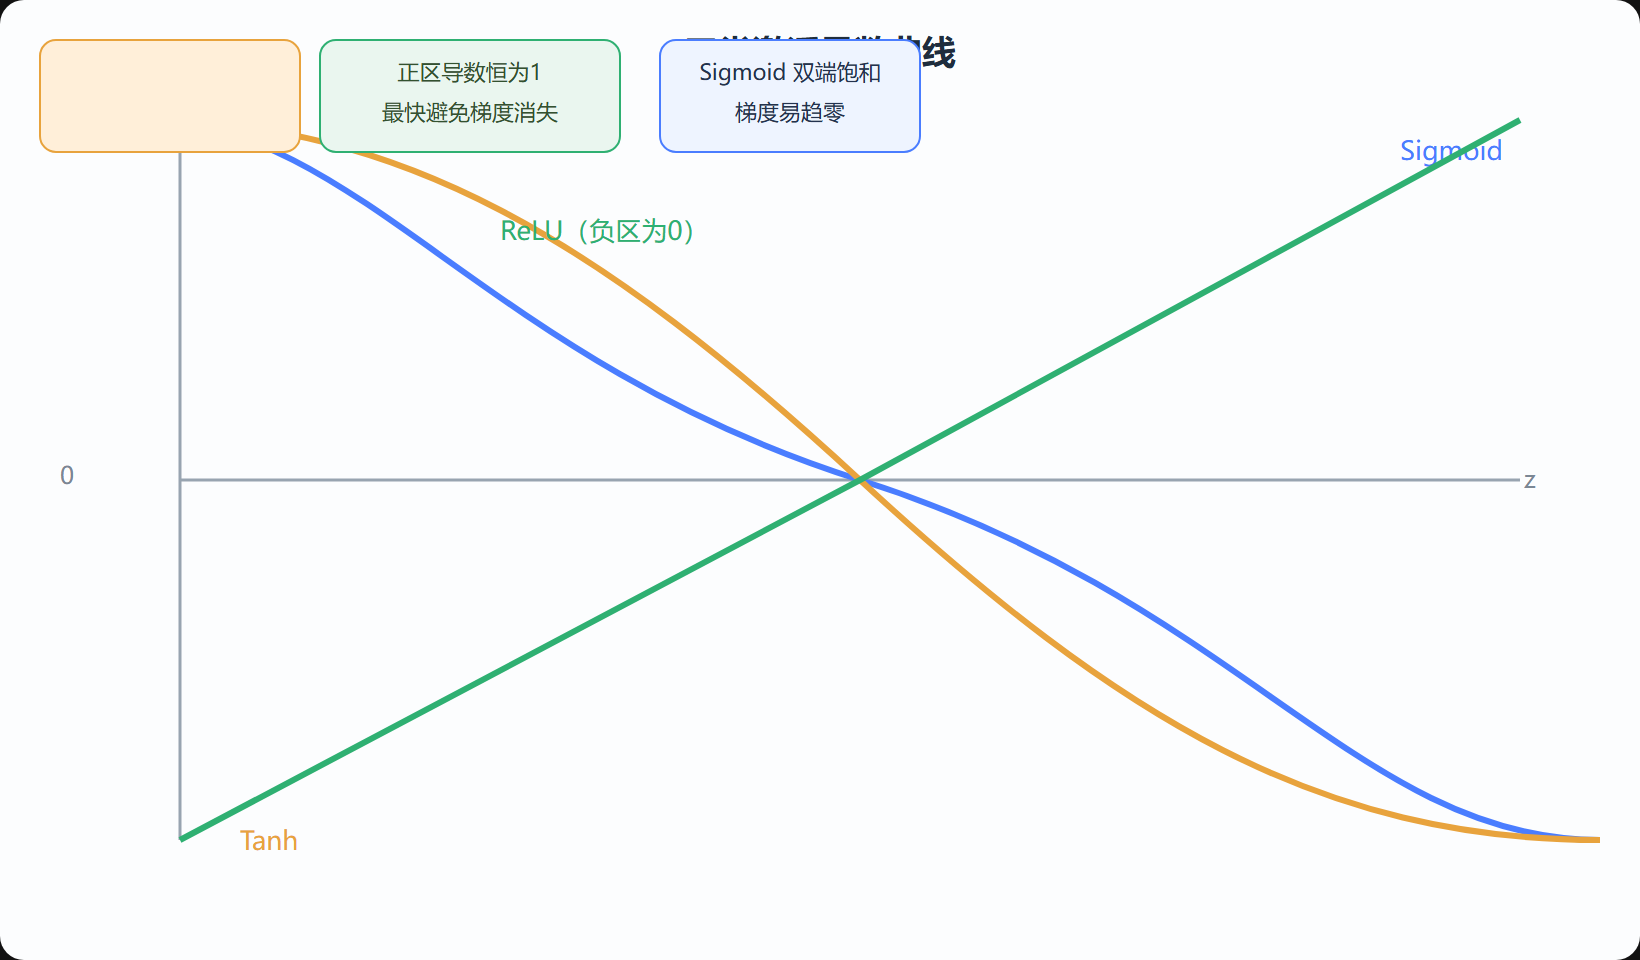
从图中能读出三个判据:曲线上半段是否平缓(影响梯度大小)、负区是否有输出(影响神经元的生死)、以及端点是否饱和。三者合起来,就是"这条激活对梯度友不友好"的体检表。
Swish 与 GELU:近年来的温柔改良
Swish 主张"不该一刀切掉负区,而是温和地让很负的输入趋近零但不死透",数学上用输入乘以一个 Sigmoid 兜底;GELU 类似,在 Transformer 时代成了主流选择(第5章会再见)。它们收敛通常比 ReLU 略稳,但多一次乘法和两次指数运算,深度学习框架里往往把它的计算代价摊平成近似实现。要记住的是一句工程结论:任务越普通,ReLU 与 Leaky ReLU 越省心;追求最稳收敛时再考虑 Swish、GELU。
用代码把这三种激活各自落地,并对照看几个输入点的输出:
import math def sigmoid(x): return 1/(1+math.exp(-x)) def relu(x): return max(0, x) def swish(x): return x*sigmoid(x) for z in (-3, -0.5, 2, 6): print(z, "sigmoid=", round(sigmoid(z),3), "relu=", relu(z), "swish=", round(swish(z),3))
运行结果直观:ReLU 在负输入直接归零,Sigmoid 把大幅值压得温吞,Swish 在大正值时几乎等于原值、在大负值才接近零——三种脾气当场可见。
选型时别只盯着曲线
激活函数不是孤立的旋钮。同一网络里,输出层常配专属函数(回归用线性、二分类用 Sigmoid、多分类用 Softmax,见 1.3),中间层才轮到本节这些花样。而且激活和初始化、归一化、学习率是联动的:选了深饱和的 Sigmoid 却不配好初始化,第2章的反向传播会立刻用"梯度消失"惩罚你。
死亡神经元的现场与查抢救
ReLU 的负区被一刀切死后,最让人头疼的是"静默地死掉"——神经元既不报错,日志也看不出异常,就是死活不动。现场往往是这样:训练到某一阶段,某些神经元的输出一路保持为全 0,权重更新拿到的梯度恒为 0,等于一个废卒。查起来有个笨办法:训练后把某一层所有神经元的激活存下来,画个直方图,看有多少堆在 0 那个尖上。堆得越高,死得越多。
抢救思路顺着"为什么死"来分:一是初始化不当,权重一开始把预激活推进了负区,人还没学会就凉了;二是学习率过大,头几步就把神经元冲进负区出不来;三是长期没有负向监督需求,它就是被优化器冷落了。对策分别是:换 He 一类的初始化、把学习率调小、以及把死区和 Leaky ReLU / PReLU 换着用,故意在负区留一丝坡度当氧气。
一个容易做错的地方
很多人以为"所有 ReLU 层都会死神经元,所以全换成 GELU 就没事"。实际工程里,普通深度任务用 ReLU 配好初始化、学习率同样可行;GELU 的优势主要体现在大模型那种又深又宽的Transformer上。真盯着每一层的激活直方图去调,比盲目换激活函数更能定位问题。
一节自查:给图配解释
回头看本节那张对比图,试着不用文字,自己在心里回答三问:Sigmoid 在两端的导数大约是多少?ReLU 在负区导数是多少、输出是多少?如果我想让"梯度在穿多层时尽量少被削弱",优先挑哪两款?答得上这三问,说明你不仅认识了物,还理解了它为什么被需要——这正是第2章反向传播要用的全部直觉。
本节要点回顾
- 没有非线性,多层等于白叠,表达能力被锁死在线性
- Sigmoid、Tanh 双端饱和,是梯度消失的天然温床
- ReLU 正区梯度恒为 1,普及度最高,但要防死亡神经元
- Swish、GELU 更温和,常见于 Transformer,代价是计算略重
- 激活要和初始化、归一化、学习率放一起权衡,别单点调参