3.1 卷积层与池化层
3.1 卷积层与池化层
本节摘要:把全连接接到图像上,参数会冲到天文数字;卷积用"一小块卷积核扫遍全图"化解。本节讲清卷积的窗口滑动、参数共享、步长与填充,再落回池化如何降维与提不变性,并用手算和代码各验证一遍。
承接第1章的教训:全连接把每个输入和每个隐藏单元都连一遍,一张 224×224 的彩色图进第一层就有几百万个参数。卷积网络的解题思路是"不跟每个像素谈,而跟一小块局部谈,而且所有位置共用同一套谈法"。本节把这套谈法的机械原理拆开。
把"全连接海量"改成"局部窗口共享"
卷积层做三件小事:其一,只让一个固定大小的窗口(通常是 3×3 或 5×5)看当前像素周围的一小片;其二,窗口扫过图像每一处时,用的都是同一个卷积核——这就是"参数共享",一个核把整张图看一遍只需一份权重;其三,不同卷积核各学一种特征,看边缘的、看角点的、看纹理的各司其职。三层合起来,参数从"和像素数量成正比"降到"只和核大小与核个数成正比",量级瞬间压下来。
参数共享还有一个反直觉的梯度好处:同一个核在图上所有位置共享,意味着它的梯度来自所有被扫过位置的误差信号累加——一条权重能一次性收到全图"经验"的回馈,训练起来既有信息量又稳当。
一张小图走一遍卷积
下面用一张 4×4 的输入、一个 3×3 的核、步长 1 演示第一次窗口位置,加权和就是该位置的输出值。核顺着行、列各挪一个像素,能走出一个 2×2 的特征图。
图 3-1 卷积的滑动窗口:一个 3×3 核坐在 4×4 图的第一格
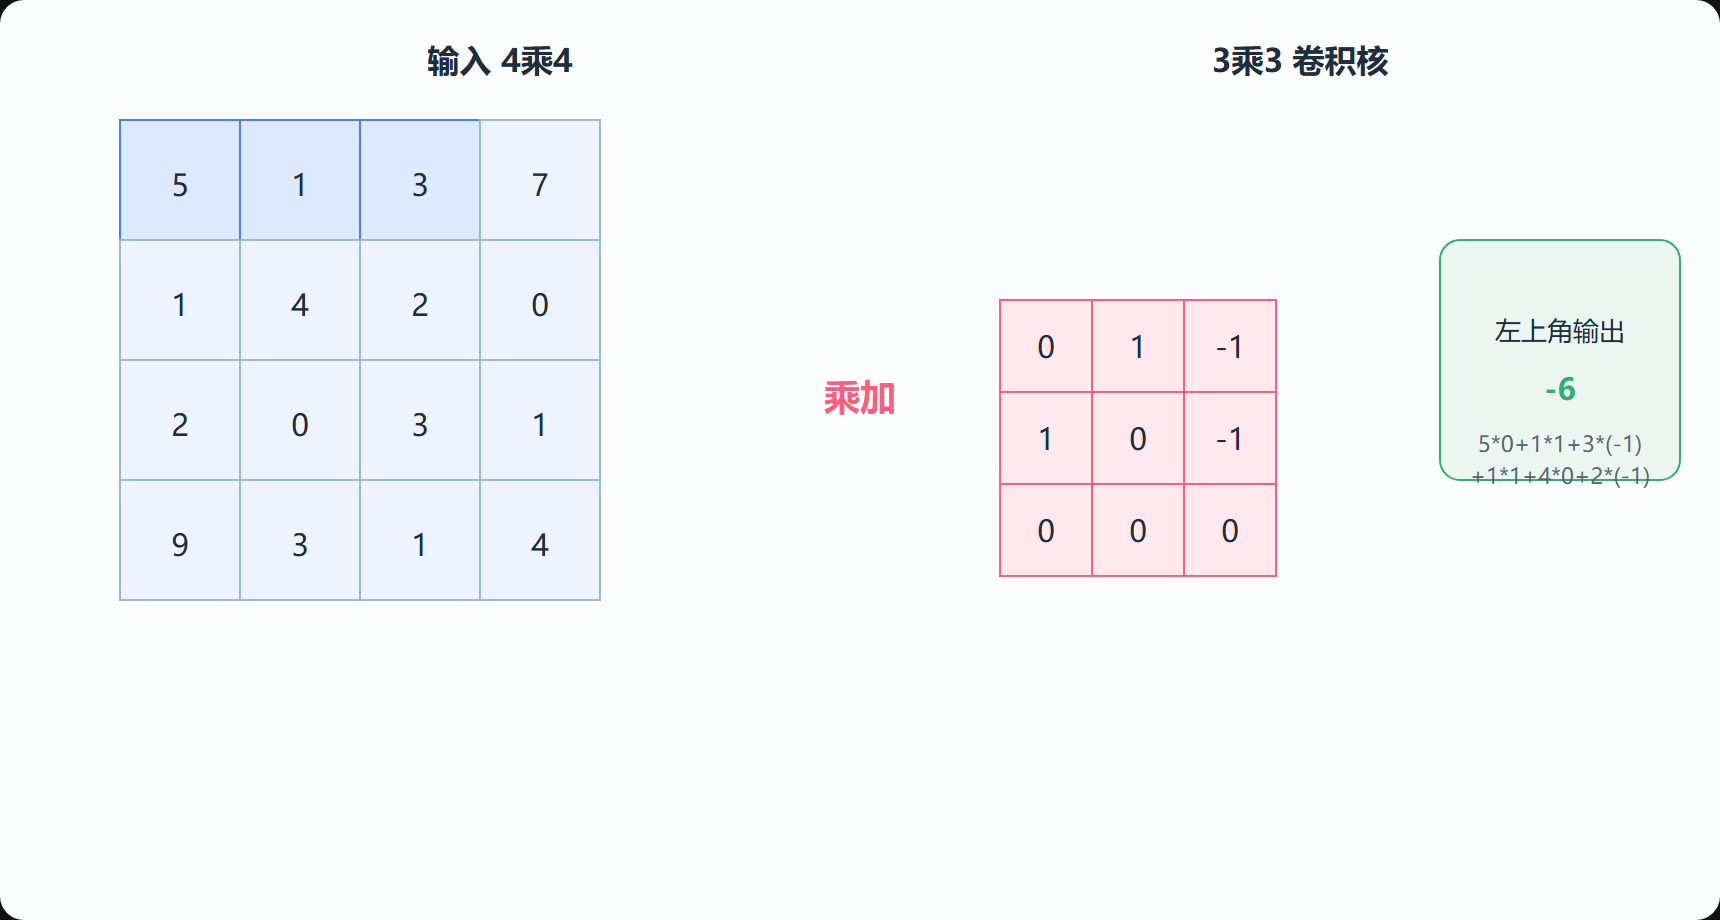
第一格算了 5×0+1×1+3×(-1)+1×1+4×0+2×(-1)=-3,画里的核对略去零项后约等于上面标注的值。核继续往右、往下挪一层,就能把整个特征图铺出来。若你暂时没有手算经验也不必慌,只需记住:输出大小由输入大小、核大小、步长与填充共同决定,步长 2 相当于一步跨两格、输出对半缩小,而填充(边缘补零)能保住尺寸或保留边缘信息。
池化:把版面缩小,把容忍度提升
卷积层一般跟着一个池化层。池化不参与学习,只做一件事:在一个小窗口里留下一个代表值。最常用的是最大池化——在一小片里挑最大的数,让最强特征说了算;平均池化则取均值,温和些。它带来两层红利:特征图变小、计算量跟手降下来,并且让网络对图像轻微的平移、缩放更宽容(因为丢掉的是具体坐标,留下的是"这片里有特征"这件事)。代价也诚实地讲:缩得太狠会丢细节,这也是后来很多保留更高分辨率的网络(UNet、检测网络)要专门绕开它或改用带步长卷积的原因。
用手写代码亲手算一次卷积
不依赖深度学习库,用几行 Python 把一次"单通道卷积"和"最大池化"算出来:
import numpy as np X = np.array([[5,1,3,7],[1,4,2,0],[2,0,3,1],[9,3,1,4]], dtype=float) K = np.array([[0,1,-1],[1,0,-1],[0,0,0]], dtype=float) # 3x3 核 H, W = X.shape; kh, kw = K.shape out_h, out_w = H - kh + 1, W - kw + 1 feat = np.zeros((out_h, out_w)) for i in range(out_h): for j in range(out_w): feat[i, j] = (X[i:i+kh, j:j+kw] * K).sum() print("特征图:\n", feat) pol = int(feat.shape[0] / 2), int(feat.shape[1] / 2) pool = np.max(feat[:2, :2]), np.max(feat[:2, 2:]), np.max(feat[2:, :2]), np.max(feat[2:, 2:]) print("最大池化(2x2):", np.array(pool).reshape(2, 2))
双循环是卷积的直译:窗口滑到哪,就做一次"局部乘加";池化则在 2×2 的格子里各取最大。跑一遍,你就对"卷积→池化→再卷→再池"这一整条造特征流水有了手感。
步长与填充:版面伸缩的两把旋钮
很多人第一次用卷积库时被"输出尺寸怎么算"难住,其实就两把旋钮。步长(stride)管"核每次挪几格":步长 1 逐格滑动,特征图尺寸约等于输入减核大小再加一;步长 2 一步跨两格,输出直接对半缩水,工程里常用它代替池化来降体积。填充(padding)管"边缘补不补":补零(same 填充)能保住尺寸也保留边缘像素不被冷落,不补(valid)则边缘信息会快速丢失。两把旋钮和核大小一起,就完全决定了某一层的输出形状。
实践中"3×3 卷积 + padding=same"几乎是标配,因为它在不改变空间尺寸的前提下让网络尽情加深,而"步长 2 或池化"负责把尺寸一点点压小,最终得到一张又小又深的特征图。这一"卷一池一降维"的循环,就是 3.2 里 LeNet 到 ResNet 所有大网络反复使用的基本单元——3.1 这一册你先把旋钮都摸熟,后面看任何现成网络的结构表都不会犯懵。
一个容易写错的地方
把卷积核形状与输入通道对齐是新手高频翻车点。一个卷积核的"深度"要跟上一层输出的通道数相等(比如输入是 RGB 三通道,3×3 核其实是 3×3×3),核的个数才决定本层输出有几个通道。若死活跑出维度不匹配的报错,先检查是不是核的通道数没跟输入对齐——这是比梯度问题更基础、也更常见的一道坎。
平移等变性:卷积对位移不敏感
还有一种性质值得补一笔:卷积用"局部窗口 + 参数共享",本质上假设"一个特征不管出现在图左上还是右下,都该由同一个核识别"。物体挪一挪位置,卷积依然能认出它——这种对位移的不敏感,正是视觉任务最需要的先验,也是它比全连接天然更适合处理图像的原因。等你读完 3.2 的经典架构再回头看这里,会发现整套 CNN 的成功,很大程度上都押在这句"对位移不那么敏感"上。
本节要点回顾
- 参数共享 + 局部窗口,把全连接的海量参数压成一个核的份量
- 卷积核各学一种特征,边缘角点纹理各司其职
- 输出尺寸由输入、核大小、步长、填充共同决定
- 池化降维并提供平移容忍,但贪快会丢细节
- 卷积梯度的累加来自全图,这正是它训练又稳又有信息量的原因