3.2 经典CNN架构:从LeNet到ResNet
3.2 经典CNN架构:从LeNet到ResNet
本节摘要:把卷积与池化拼起来,会经历几代标志性的"装配方案"。本节顺着 LeNet、AlexNet、VGG、Inception 走到 ResNet,重点看更深网络如何被残差连接"抄近路"救活,并解释每个里程碑改良了什么。
有了 3.1 的积木,本节看看这些积木历史上是怎么一代代拼出纪录的。它们之间有一条清晰的暗线:大家都想做得更深、更宽,但每深一层就离梯度消失更近一步,于是每一代架构都在为"更深也不怕"想办法——这正是全书"反向传播演进工坊"主线在视觉分支上的展开。
从 1998 到 2015:一代比一代深
LeNet(1998,手写数字)最先证明"卷积+池化+全连接"这条路能走通:几个卷积池化把 28×28 的小图压成特征,再接全连接输出 10 类。AlexNet(2012,ImageNet 一战成名)把套路放大:更深、更多卷积核、引入 ReLU 激活和 Dropout,还配上 GPU 并行,把精度顶上一个台阶。VGG 则用一个朴素但极端的原则刷满了存在感——深度为王,整齐地堆叠 3×3 小卷积,一路堆到 16、19 层,靠"小核堆叠"实现了与大核一致的感受野还不怎么费参数。Inception 另开一系,在同一层并行用不同尺寸的卷积核再把结果拼起来,让网络自己挑"该看多宽"。
到了 VGG 那样的深度,训练开始吃紧——这就引出全章的转折点。
更深反而更差?残差连接登场
直觉上"越深越好",可当深度堆到某个阈值,实验却出现怪现象:更深的网络训练误差竟然比浅的还高。不是过拟合——训练误差本身下不去,说明优化出了问题;梯度一条长链层层相乘,很容易在中途磨没。2015 年的 ResNet 给了一记巧招:残差连接(恒等捷径)。普通模块学的是"直接输出 H(x)",残差模块改学"残留量 F(x)=H(x)-x",再把输入 x 原封不动加回来,输出 H(x)=F(x)+x。
这一改,反向传播立刻获得一条"高速通道":误差可以从输出端沿恒等捷径近乎无损地一路直抵最深的层,不经过任何卷积加权,梯度消失的困扰被绕开了大半。于是层数从二三十层直接冲到一百多层甚至上千层,精度还能继续涨。
图 3-2 普通模块 vs 残差模块:梯度怎么抄近路
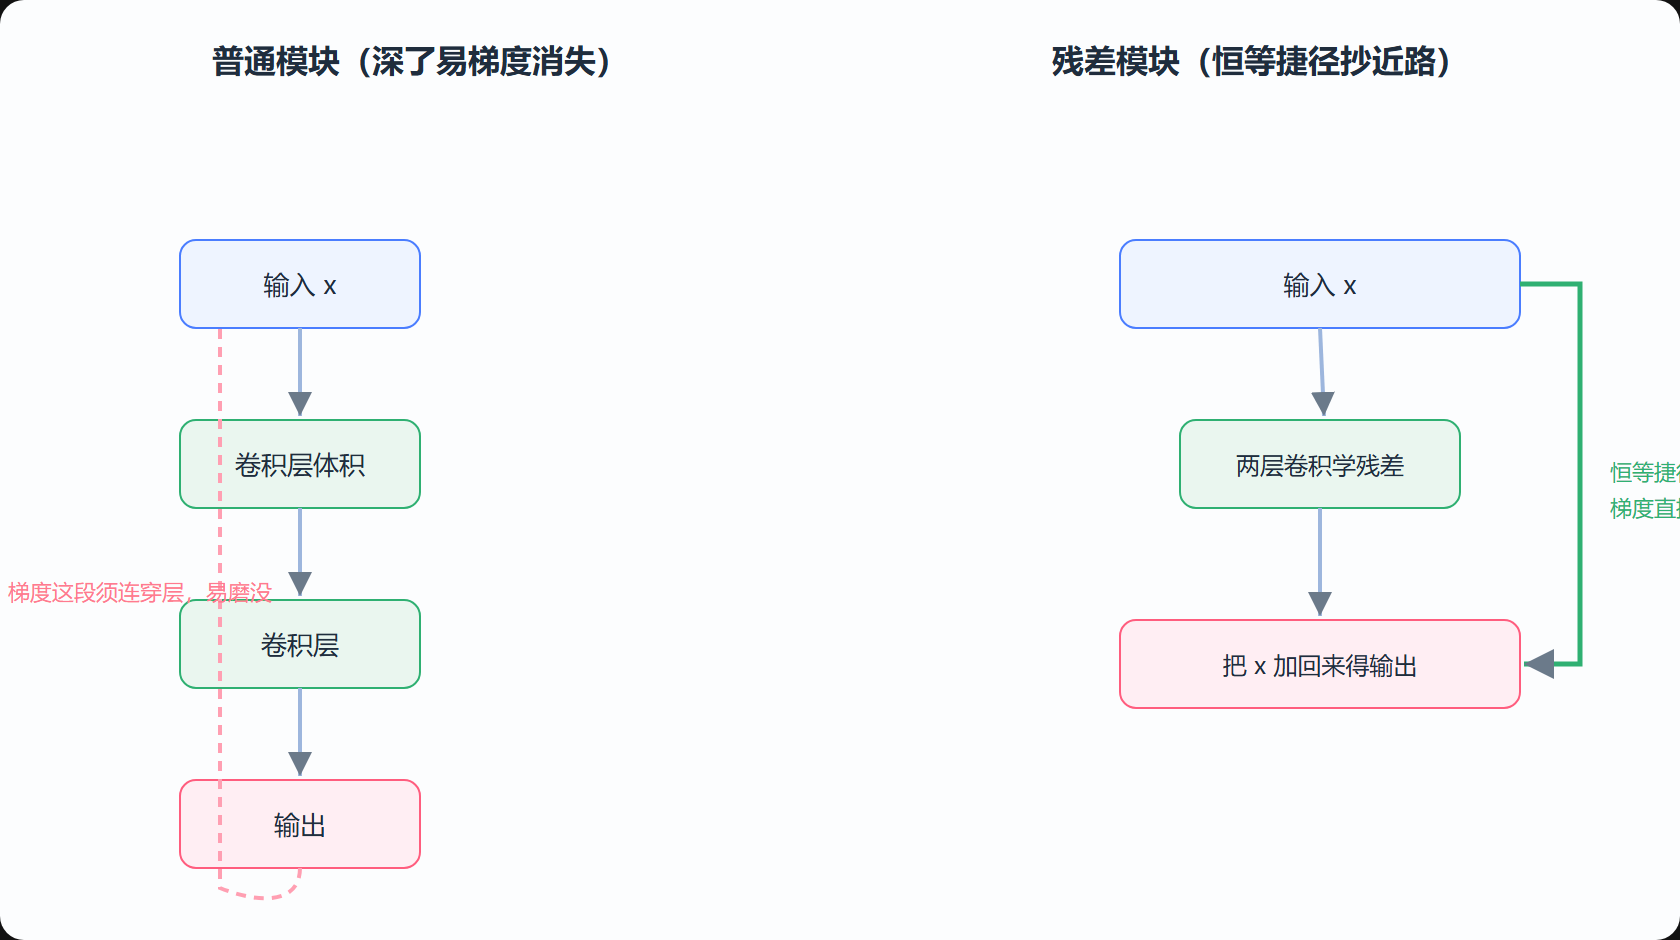
右边那条从输入端一路不加裹绕直接连到输出的虚线,就是残差的全部秘密:梯度优先走这条近路,剩下的卷积路径只是补差。
把残差块写进代码
残差块的实现其实一眼能看穿——主线算一遍卷积,旁路把输入原样加回来:
def residual_block(x, filters, kernel=3): h = x # 两次卷积 + ReLU 的常规路径 c1 = Conv2D(filters, kernel, padding="same", activation="relu")(h) c2 = Conv2D(filters, kernel, padding="same")(c1) # 恒等捷径:把输入加进卷积结果 out = Add()([c2, x]) return Activation("relu")(out)
关键就在 Add()([c2, x]) 这一行:它把输入直连回输出。前向时输出多交代一点信息,反向时梯度多一条不用翻山越岭的通道。堆叠这样的块,就能安全地把网络做深。
从一组对比看演进脉络
| 架构 | 年份 | 核心贡献 | 在"梯度/深度"上的解法 |
|---|---|---|---|
| LeNet | 1998 | 卷积思路奠基 | 浅层即可 |
| AlexNet | 2012 | 规模化 + ReLU + GPU | 用 ReLU 缓解饱和 |
| VGG | 2014 | 小核堆叠加深 | 深度堆到 19,极限 |
| Inception | 2014 | 多尺度并行 | 提高宽度与效率 |
| ResNet | 2015 | 残差连接 | 恒等捷径让超深可训 |
看出规律了:越往后,大家越把力气花在"如何在加深的同时不丢梯度"上——直到残差用一个几乎是结构性的改动,把梯度消失这条老路彻底绕开。这条线到后面的 Transformer 里还会以另一种形态(残差 + LayerNorm)再次出现。
残差另一面:批量归一化为什么常和它同出现
只讲残差、不提它的黄金搭档有点片面。实际现成网络里,残差块内部几乎总夹着 BatchNorm(见 2.4):先卷积、再批量归一化、再激活。原因在于残差虽给了梯度一条近路,但块内那条卷积路径的数值尺度仍然敏感;BatchNorm 把每次输入标准化,让这条主路径梯度稳、学习率能放大。两者互补,一个治"梯度穿太深会消失",一个治"各层尺度乱让训练飘"——所以第 5 章的 Transformer 也把残差 + LayerNorm 当成固定搭配,道理是同一个:主干抄近路,路径求稳定。
一个自查:为什么越深反而更差
把"越深误差越高是优化问题不是容量问题"再嚼一遍:容量大意味着理论上能记住更多映射,可优化器找得到找不到是另一回事。深度一上来,每个参数平均分到的梯度变小,网络很容易"能表达却训不出来"。残差解决的就是这个执行层的困境——它不增加表达能力,而是让已有的深网络真正能被梯度带着学会。想通这一点,你就不会被"加深网络"这个流行口号带着走而不究其所以然。
参数脱不了钩:VGG 的大坑
深度之外,参数规模是另一条暗线。VGG 靠小核堆叠把层数做深,可几个大全连接层接上去,参数直奔亿级——存模型、跑前向、上显存都吃力。ResNet 在做出残差的同时,也顺手用全局平均池化替换掉大的全连接层,让参数量大幅回落。这一进一出提醒你:读一个现成网络的"结构表"时,别只盯层数和精度,参数总量、浮点算量和内存占用同样决定它放不放得进你的显存。后来 MobileNet、EfficientNet 这类"又轻又准"的模型,优化的也正是这几笔账。
本节要点回顾
- LeNet 奠基,AlexNet 靠 ReLU+GPU 规模化,VGG 靠小核堆叠加深
- Inception 多尺度并行,在宽度上做文章
- 更深的网络训练误差更高是优化问题,不是容量问题
- 残差连接用恒等捷径给梯度一条不衰减的高速通道,深层因此可训
- 残差 + LayerNorm的搭配,在后面 Transformer 里会再次登场