4.1 序列数据与RNN结构
4.1 序列数据与RNN结构
本节摘要:语言、语音、股价都有一个共性——顺序很重要。本节讲把"顺序"翻译成网络语言的关键设计:参数共享 + 滚动隐藏状态,并用手写一个字符级 RNN 的步骤理解每一步是怎么把上一刻的记忆带过来的。
承接第3章:那里的输入是带空间结构的图像,这里的输入换成了带时间结构的序列。普通全连接层对序列有几处先天不足——它不记得"上一刻说了什么",也不在乎"先后顺序"。本节把这些不足对应的设计逐条补上。
顺序信息不能丢,全靠一个滚动的记忆
序列最关键的属性是先后。"猫追狗"和"狗追猫"一字不差,意思天差地别;股票的前一天总是先于后一天。全连接层把输入当一个整体打包处理,天然不带"时序"。RNN 的解决办法很朴素:让网络每走一步,都把这一步的答案和这一步的记忆一起滚进下一步。也就是在每个时间步,隐藏状态既受当前输入影响,也受上一个时间步的隐藏状态影响。
这条链子的妙处是参数从头到尾只有一份:同一个权重矩阵在 t=0、t=1、t=2 每一步都被复用。它带来两件事——其一,模型量不随序列长度增长;其二,网络被迫去学"对不同位置一视同仁的处理规则",而不是为每个位置各设一套。这正是它与第3章卷积"参数共享"互通的精神:一个规则,全图(全序列)通用。
把循环画成展开图就一目了然
写代码时,循环天然是"同一个函数被调用多次";画图时,我们把它"摊开"成时间轴上一连串重复的单元,更易看清数据的流向。
图 4-1 RNN 的时间展开:同一份参数,被时间轴串起来
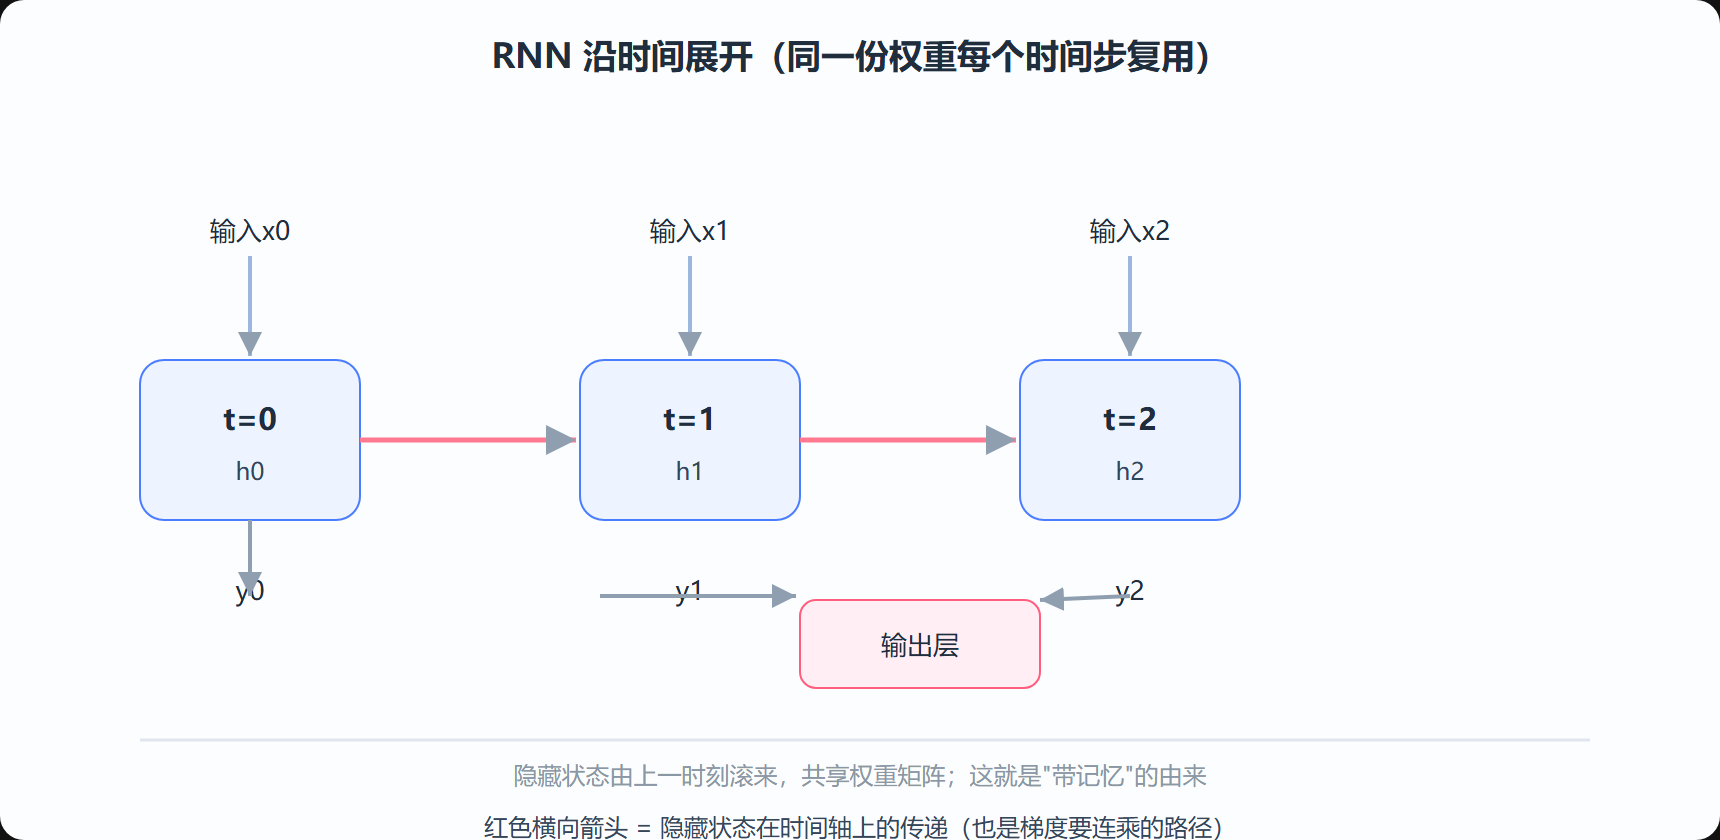
图中每个阴影块是同一个 RNN 单元在不同时刻的样子(画的虽是三个框,权重却是一份);红色横向箭头就是"记忆承接",同时也是下一节梯度要在时间轴上连乘的那条通路。
一个隐藏单元到底在算什么
最朴素的 RNN 单元每走一步做三件事:把当前输入乘上输入权重矩阵、把上一时刻隐藏状态乘上隐藏权重矩阵、两者相加再过一个 Tanh 得到新的隐藏状态;随后可选地把隐藏状态映射到输出。写成算式就是 h(t) = tanh( W 乘 x(t) + U 乘 h(t-1) )。不必背符号,记住"新记忆 = 旧记忆的加权 + 当前输入的加权,再压一压"就够。Tanh 把隐藏状态压在负一到正一之间,防止数值跑飞。
用字符级 RNN 感受"一个字憋出下一个字"
把"话"拆成字或词的过程叫切分(token 化),喂给网络的是每个 token 的索引。下面是一个最小字符级 RNN 的一步前向,感受记忆怎么滚:
import numpy as np # 词汇表就 5 个字符,用一个 5 维 one-hot 表示当前输入 char_to_idx = {c:i for i,c in enumerate("xyza.")} x = np.zeros(5); x[char_to_idx["y"]] = 1.0 # 当前字符 y W = np.random.default_rng(0).normal(size=(6, 5)) # 输入+隐藏 混合权重 U = np.random.default_rng(1).normal(size=(6, 6)) # 隐→隐 h_prev = np.zeros(6) h = np.tanh(W.dot(x) + U.dot(h_prev)) # 新记忆 = 输入 + 旧记忆 print("上一时刻记忆:", np.round(h_prev, 3)) print("本时刻记忆:", np.round(h, 3))
把同样的代码在 x、y、z 上多跑几个时间步,你会清楚地看到 h 里沉淀着前面几个字符的"余温"——这就是 RNN 记忆的最小演示,也是后面做文本生成、机器翻译的种子。
记忆到底记了什么:一个直觉实验
把"猫 追 狗"按顺序喂进一个训练好一点的 RNN,走到"狗"时,它的隐藏状态里既码着"狗"本身的语义,又拖着"猫""追"的余温——顺序之所以重要,正因为这些余温是"谁在谁前面"留下的痕迹。你可以做个极朴素的思维实验:把词语顺序打乱后重新喂,RNN 最后的隐藏状态就会和原来不一样,输出的预测也会跟着变。把这句话反过来读,你就理解了"顺序信息不能丢"在工程上意味着什么——丢失顺序,等于丢失了模型做判断最关键的那一部分输入。
RNN 在这方面的局限也随之浮出来:它的记忆全靠一个隐藏状态一路滚,滚得越远,早期信息被后来者覆盖得越严重。这也是为什么切分时很多人喜欢"反向再喂一遍"或"双向接两遍",好让记忆从两头都能看——这个念头会在 4.4 的序列到序列里派上用场。
一个自查
只想确认你是否看清了循环的"共享"二字:同一个 RNN 单元在所有时间步上用的是同一份权重,那么"模型参数总量"是随序列长度变,还是与序列长度无关?答案是无关——这正是它和"每个时刻各配一套参数"的全连接在预算上的根本差别,也是你理解后面 LSTM、Transformer 为何都延续共享这套设计的起点。
参数共享带来什么:不只省内存
参数共享在 RNN 里还有一层卷积里见过的好处:它让"处理规则"不随位置而变。无论"猫"字出现在句首还是句尾,网络都用同一套权重去理解它——这符合语言直觉:同一个词在不同位置担当的语法角色可以不同,但它对应的"查词典"能力应当是统一的。反过来说,若为每个位置各放一套参数,模型既要学"位置"又要学"语义",样本量早就撑不起了。正因共享,序列可以任意长,模型都不必为长度预支参数——这是 RNN 能一视同仁地吃下变长序列的底气,也是下一节梯度要在时间轴上连乘的那份"共享权重"所付代价的开端。
变长输入怎么进网络
真实序列长短不一,模型得用统一方式接住。常见做法是把 batch 里的句子 pad(补零)到一样长,再配合掩码让补的零不参与记忆更新;batch 越大、补得越多,浪费越明显,所以也有人按长度排序去分组、减少补的量。这一点是落地 RNN 前的第一道坎:写模型结构不难,让"长短不一的序列"进得去、又不让填充位影响学习,才是工程上真正磨人的地方。
本节要点回顾
- 序列的先后是信息,全连接先天接不住,RNN 用滚动记忆兜住
- 参数在时间轴上共享一份,模型量不随序列长度涨
- 新记忆 = 旧记忆加权 + 当前输入加权,再过 Tanh 压幅
- 时间展开把循环摊成重复单元,红色横向箭头是记忆(和梯度)的通路
- token 化是先决步骤,字符级 RNN 是最小的记忆演示台