4.2 梯度消失与爆炸及其对策
4.2 梯度消失与爆炸及其对策
本节摘要:RNN 的时间展开让反向传播变成"时间轴上一长串连乘",连乘的宿命就是要么小到消失、要么大到爆炸。本节讲清病根的数学直觉,再给三路对策:梯度裁剪治爆炸、更好的初始化解与门控(预告 LSTM/GRU)治消失。
刚在 4.1 里看到梯度沿横向箭头在时间轴上传递,本节就要面对这条路径的宿命。它把第2章"链式法则连乘"的原理,放到"时间维度也很长"这个新战场上——这正是本章命名为"梯度的时间之旅"的原因。
时间轴上的一长串连乘,是谁都躲不过的麻烦
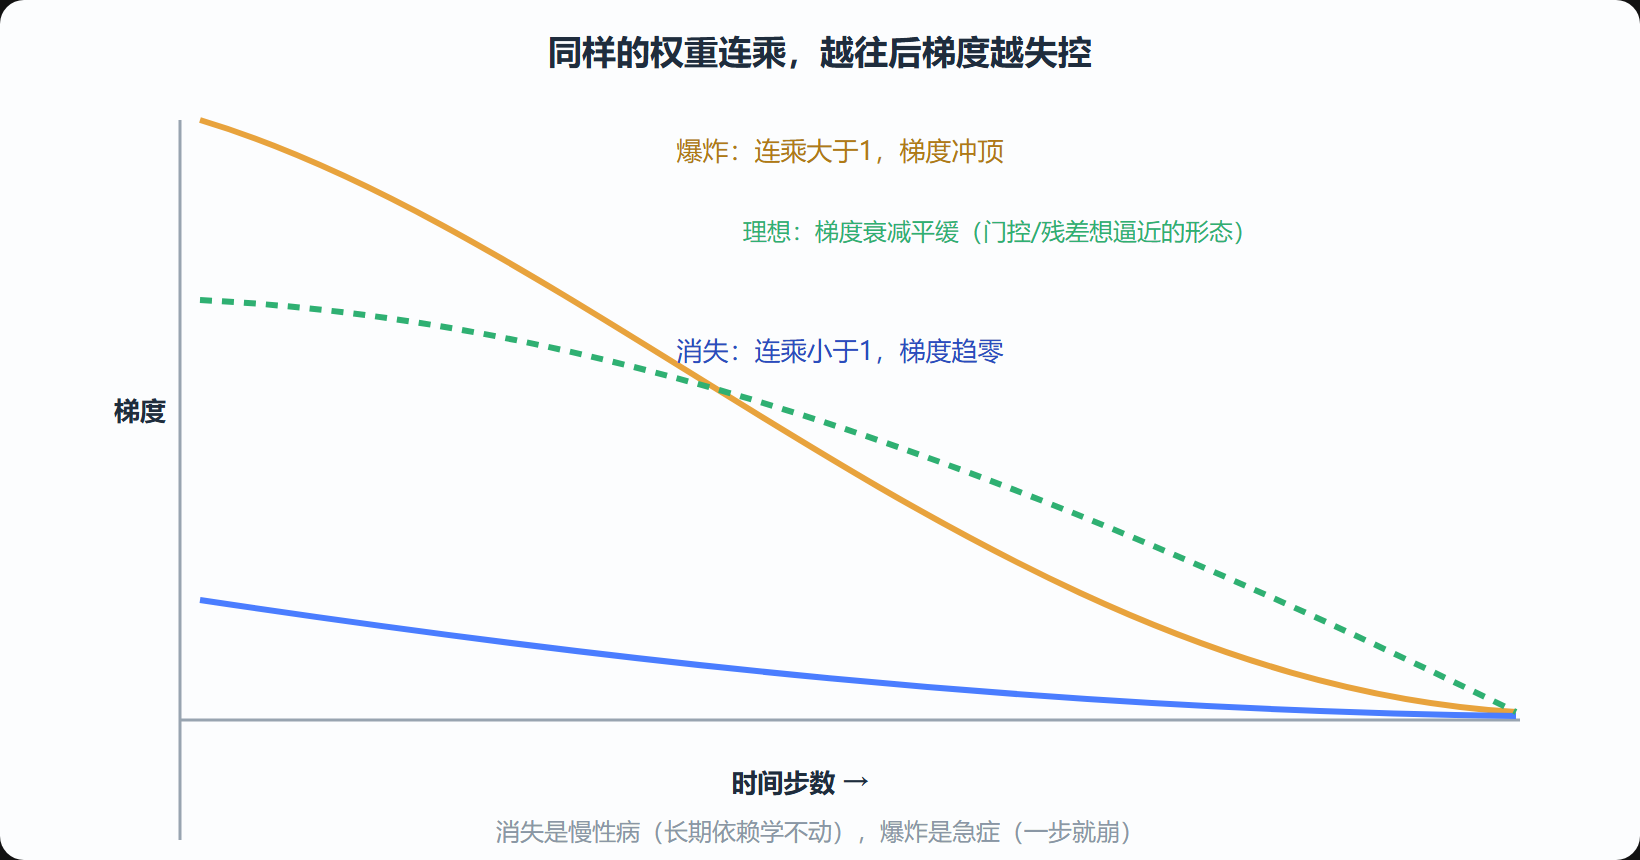
反向传播到时间深处,误差每往回走一个时间步,就要乘一次隐藏层权重和激活的导数。于是走过 T 个时间步,就相当于把同一个"缩放因子"连乘 T 次。性质很简单:这个缩放因子小于 1 时,T 次连乘一路跌向零——梯度消失,远处时刻的信息一点学不到;大于 1 时,T 次连乘一路冲上天——梯度爆炸,一更新就把参数掀翻。RNN 用的 Tanh 激活导数最多为 1、通常远小于 1,所以现实中消失比爆炸常见得多,而爆炸虽然少见,一旦发生训练直接崩。
消失的病名也叫"长期依赖难学":开头出现的关键词,走到结尾时对梯度的影响已经淡到泥牛入海,"他从小就学古典吉他,如今成为著名演奏家"这种长距离的回指,早把线索磨没了。
图 4-2 梯度随时间步数一路连乘的走势
三路对策,各管各的病
治爆炸——梯度裁剪。这一招最直接:算完梯度后,如果它的模超过某个阈值,就把它按比例压回阈值之内再更新。爆炸的伤害在于"一步乾坤大挪移",裁剪把这一步的暴冲按住,训练就跌不出深渊。它实现极简、几乎是零成本的护栏,作者建议所有深度模型都备上。
治消失——门控与前缀改良。消失根在"连乘",最彻底的解法是不让信息只走连乘那条窄路——给循环单元装上"读、写、忘"的门(4.3 的 LSTM/GRU),或沿用残差式的捷径(第3章学过),让梯度有直达通道。其次好使的是更好的初始化:把隐藏权重矩阵初始化得接近单位阵,让缩放因子一度接近 1,给训练一个好开场;再配合 ReLU 这类正区导数恒为 1 的激活,也能缓解(但 Tanh 在 RNN 里更常用以稳定数值)。
治数值病——逐层监控。实践里常配合检查"梯度模长",一旦出现极大值就是爆炸前兆,极小值则是消失信号。把这套监控写进训练循环,等于给反向传播装了个仪表盘。
用代码直观感受"连乘多少次就多狠":
import numpy as np rng = np.random.default_rng(0) alpha_ok = 0.9 # 缩小因子 alpha_bad = 1.1 # 放缩因子 for t in (5, 20, 100): print("t=", t, "稳定场景梯度~", round(alpha_ok ** t, 4), "| 放缩场景梯度~", round(alpha_bad ** t, 2))
看着数字随 t 变大:稳定场景一路跌到小数点后,放缩场景转眼冲到天文数字。模型里那个"缩放因子"就是连乘的主角,它的值决定了 RNN 是"记不住"还是"跑飞"。
从病根想到:这条路为什么一定要修
回头串一下主线:第3章靠残差给深层卷积"抄近路",本节 RNN 的时间链同样需要"抄近路"——门控和残差思路殊途同归。明白了这一点,再去读 4.3 的 LSTM/GRU,你就知道那些看起来繁复的门,其实都是在给梯度修一条不必翻山越岭的高速通道。
辨别你碰上的是哪一"极"
工程上手先得会分诊。把现象和病因对号入座:训练损失一开始就发疯式地震荡或直接 NaN,多指向梯度爆炸——此时立刻上梯度裁剪,那把阈值(比如 1.0 或 5.0)通常一次就稳住;训练很稳、损失一路降,但长距离依赖怎么都学不会(比如让网络记住开头才出现的关键词,到结尾却毫无反应),这才是梯度消失的典型现场,光裁剪救不了它,得上门控、残差或初始化改良。说白了,爆炸是"急症、好救",消失是"慢性病、得换药"。把这两极分清楚,才不会在错误的方向上猛灌药。
一个指标帮你看清数值健康
每轮反向传播后把所有权重的梯度取模长打印出来,你会看到随时间步数的分布形态:若模长随历史变短而断崖式缩小,就是消失的曲线;若某些时间步模长突然冲到几千几万,就是爆炸预警。把这条"梯度模长监控"写进训练脚本,等于多长了一只眼——4.2 标题里的"对策",本质就是围绕这只仪表盘在做文章。很多人忽略它,等到训练崩了才回头找原因,其实提前盯着仪表盘能省一整个debug周期。
爆炸为什么"少见却要命"
梯度消失是温水煮青蛙,梯度爆炸却是瞬间炸锅。爆炸多发生在 RNN 长序列、或深层网络的某些层里:梯度模长在某个时刻骤增到几万几亿,一步更新就把参数推到让损失变成 NaN 的深渊。它的危险不在于"损失大",而在于"数值直接失效"——训练日志里丢出 inf / NaN,多半就是它。所以前面说的"梯度裁剪",本质上是个几十行就能写完的保险丝:算完梯度,模长超过阈值就按比例缩放,把暴冲摁回去。它几乎不影响正常的训练走势,却能在最凶险的一刻兜住整局。
把两种"修"的主次排清楚
发现梯度问题时,别急着上最炫的招,走一个实用顺序:先看是不是爆炸——损失 NaN 或剧烈震荡,直接上梯度裁剪,通常一步就稳住;再排是不是消失——训练很稳、但长依赖怎么都学不动,这时才轮到上门控、换初始化、加深层采用残差式捷径。把 2.4 说的"逐层监控梯度模长"长期挂着,等于在它爆发前就有了预警。一句话做结:裁剪治"急症"、门控治"慢性病",错位用药只会越帮越忙。
一个盯数值的仪表盘
除了靠梯度模长,还可以顺手看激活值和权重的分布。若某些层权重越训越小、趋于塌缩,或激活逐渐堆在某个固定值,往往就是消失的外在表现;若日志里跳出 inf 或 NaN,爆炸基本实锤。把这两类监控写进训练循环,配合早停和梯度裁剪,等于给反向传播装了一块能提前报警的仪表。很多人等到训练崩了才回头找原因,其实先盯住这层仪表,往往就能省下一个完整的排错周期。
本节要点回顾
- BPTT 在时间轴上连乘这一点,是消失与爆炸共同的总根源
- 消失是慢性病:长期依赖学不动;爆炸是急症:一步就崩
- 梯度裁剪简单且必要,直接按住爆炸
- 门控与残差理念治消失,让梯度有直达通道
- 初始化接近单位阵 + 合适的激活,给训练一个健康开场