4.3 LSTM与GRU:门控的进阶
4.3 LSTM与GRU:门控的进阶
本节摘要:上一节说"让梯度有直达通道"能治消失,本节就是那条通道的两个代表作。LSTM 用细胞状态 + 遗忘/输入/输出三门给记忆装开关,GRU 把门瘦身成两个;本节讲清两者的读写机制、参数对比和选型取舍。
承接 4.2 开的药方:光靠初始化治标,治本要靠"给循环单元装门"。本节把 LSTM 与 GRU 这两扇门拆开看个仔细——它们是第4章的主角,也是现在几乎所有序列模型的底座之一。
一根能合法"直通"的传送带:细胞状态
LSTM 的关键,是额外给单元加了一条横贯时间的"细胞状态"传送带(通常记作 C)。它有两个特权:其一,它每一刻都只被"很轻的话"修改——记得(保留)多少、忘掉多少,都由一小撮门来决定,而不是被一个大权重矩阵全盘重写;其二,正因为变动很轻,误差信号可以沿这条传送带近乎无损地往回传,梯度消失的老病就此缓解。这跟第3章残差"让信号走近路"思路如出一辙,只是这次用在了时间轴。
传送带两侧站着三个门:遗忘门决定上一刻的记忆保留多少,输入门决定此刻的新信息写入多少,输出门决定把处理好的记忆吐出多少去影响隐藏状态。三个门各输出一个 0 到 1 之间的"开度",再分别与要过节的内容逐项相乘。
图 4-3 LSTM 单元:细胞状态传送带与三扇门
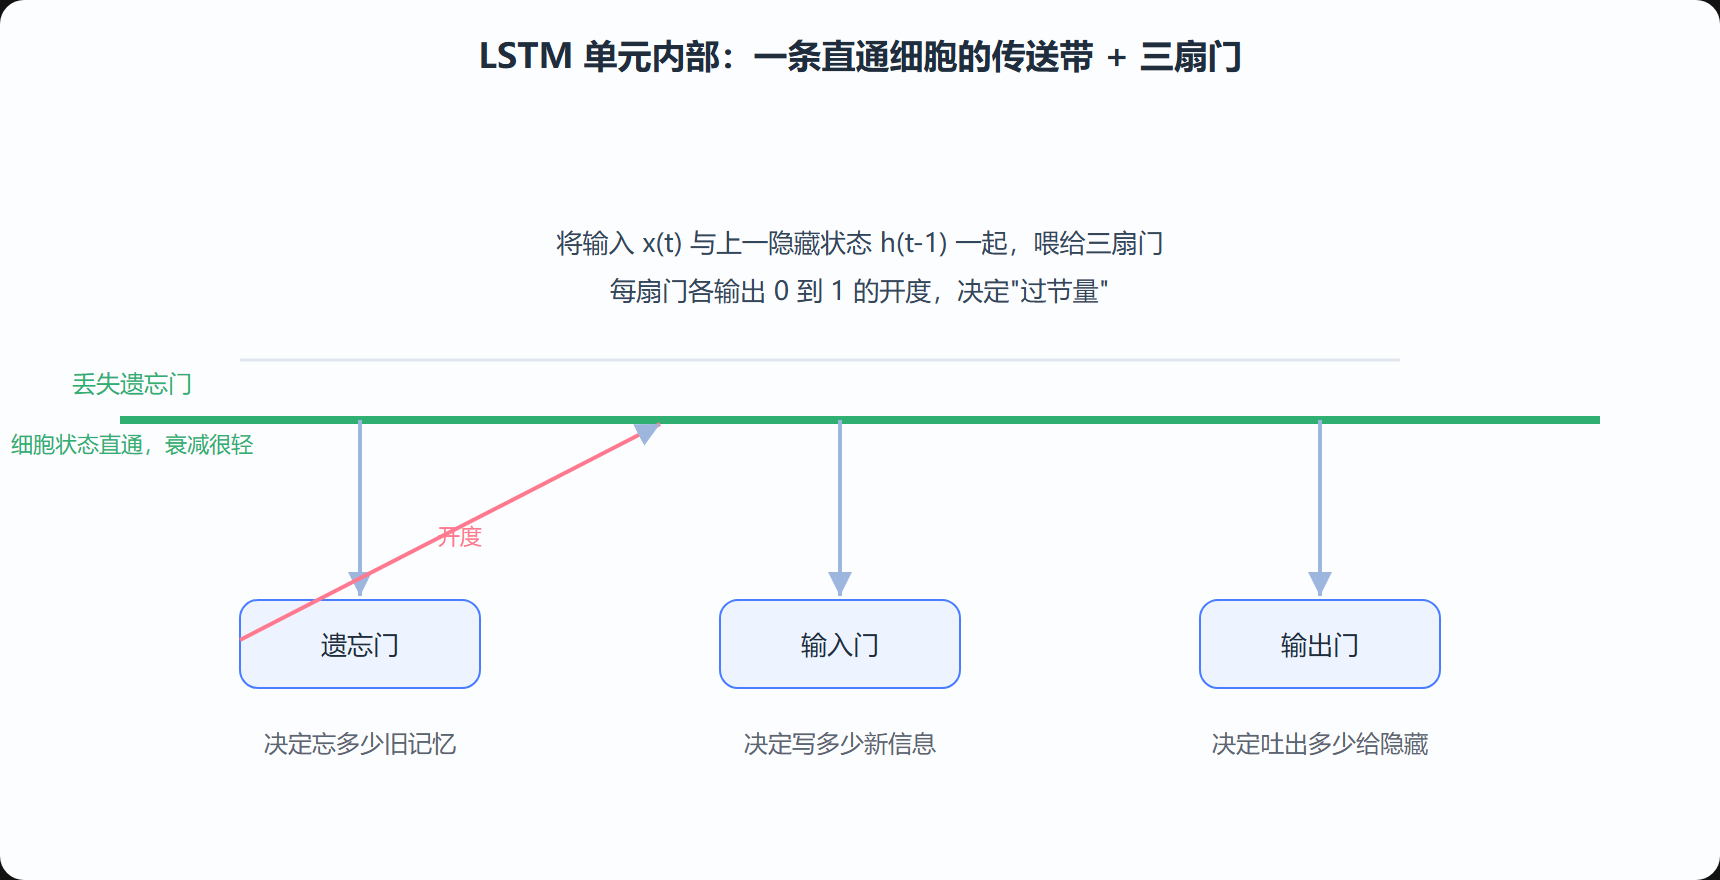
图里最上面那条粗绿线就是传送带:遗忘门 0.9 就留下九成,0.2 就只留下两成——每一刻都只做大改动所要求的轻微变动,这是它能长时间记住东西,也让梯度得以一路上行到下得去的原因。
GRU:把三扇门瘦身成两扇
LSTM 好用,但三个门加起来参数不少。GRU 的出发点是"能不能更省还差不多好用"。它取消独立的细胞状态,只留一个隐藏状态,并把遗忘与输入合并成一道更新门(决定"旧信息留多少,新信息又添多少"),另有一道重置门(决定"上一时刻的记忆对该不该用上")。门从三减到二,参数自然减下来,结构也更清爽,在很多任务上效果与 LSTM 不相上下甚至收敛更快。
| 模型 | 门数 | 关键状态 | 参数量 | 特点 |
|---|---|---|---|---|
| 朴素RNN | 0 | 隐藏状态 | 少 | 记忆弱,易梯度消失 |
| LSTM | 3(遗忘/输入/输出) | 细胞+隐藏 | 多 | 长记忆强,参数最重 |
| GRU | 2(更新/重置) | 隐藏状态 | 中 | 更省,效果接近LSTM |
用一句话选型
没有普适最优,只有场景偏好:任务要求极长依赖、参数又舍得花,LSTM 打底;追求轻量、部署紧凑或数据量中等,GRU 往往更顺手;至于深层堆叠两种结构都行。库里的调用其实一句话的事:
import tensorflow as tf inputs = tf.keras.Input(shape=(None, 8)) # 不定长序列,8维特征 x = tf.keras.layers.LSTM(64, return_sequences=True)(inputs) # 或改 GRU(64) x = tf.keras.layers.GRU(32)(x) out = tf.keras.layers.Dense(1, activation="sigmoid")(x) model = tf.keras.Model(inputs, out) model.summary()
model.summary() 能直接列出两层各自的参数量,亲眼对比 LSTM(64) 与 GRU(32) 的轻重。怕三分钟热度记不住门太多,就记住一句实务口诀:需要长记忆、常驻多参数选 LSTM;想轻量、够用就好选 GRU。
门控治的是结构病,不是万能膏药
门控缓解了梯度消失,但没免费解决一切——序列太长、语义太复杂,单靠 RNN 的隐藏状态仍然吃力(翻译长句就常卡)。这正是第5章注意力的登场理由:与其让所有记忆都塞进隐藏状态,不如让模型直接回看输入的任意位置。到那一步,你会看到"长程依赖"又换了一种更彻底的解法。
把三扇门各想成一个旋钮
别被"遗忘门、输入门、输出门"吓到,它们说到底就是三个 0 到 1 之间的缩放旋钮,分别管"旧记忆留多少、新信息加多少、吐给隐藏多少"。你把图 4-3 那根传送带想象成一条水渠:遗忘门是渠闸(放多少旧水过去),输入门是进水口(掺多少新水进来),输出门是出水口(对外放多少水让下游看)。三扇门的开度都由当前输入和上一时刻隐藏状态共同决定,是学出来的,而不是人写的规则。抓住"它只做很轻的修改、因此梯度能走直通道"这一点,整节的门再多也不会乱。
一个动手把记忆变长的直觉
GRU 比 LSTM 少一扇门,参数更省,但如果你的任务真是那种"开头提到、隔二十步还得回看"的超长依赖,GRU 的简并往往不如 LSTM 稳。工程里常常这样起步:先用 LSTM 或 GRU 各跑一版,看验证集上谁的长依赖表现更好,再决定投产;同一份数据、同一套预处理,只把头换掉就能对比。别太纠结理论谁优于谁——序列任务从来是以实测说话的领域。
门不是越多越好
别以为门数越多、能力就越强。LSTM 是三扇门、GRU 是两扇,但很多人会把"门数的复杂度"和"长记忆能力"直接画等号,这是误会。门的价值在于"能不能给梯度一条稳定通路、能不能按需读写记忆",而不在于个数多寡。在很多语言、时序任务上,GRU 用更少的参数打平甚至超过 LSTM;而一旦任务并非真正的"超长依赖",两扇门的 GRU 反而更不容易在有限数据上过拟合。所以选型时不必数着门多就去膜拜某一家,要以验证集上的实际长依赖表现为准。
划清门控的边界
门控缓解了"时间链上的连乘亏空",但没解决所有问题:它仍要求信息先装进隐藏状态,序列极长或语义极复杂时,这个"口袋"还是有限。这解释了为什么做 Seq2Seq 翻译长句时,学界会用注意力来"外挂"一个可直接回看的记忆库——那是第 5 章的主场。想理解这两代解法如何承前启后,先把本节"门控只是修路、并不是加宽路"想透,再看注意力就不会觉得突兀。
本节要点回顾
- 细胞状态传送带是 LSTM 治梯度消失的关键,改动轻、可直通
- 三扇门:遗忘管保留、输入管写入、输出管泄露给隐藏
- GRU 合并成更新 + 重置两扇门,参数量更省、效果接近
- 选型看依赖长度与预算:长且舍得用 LSTM,轻量用 GRU
- 门控治结构病不包治百病,更长依赖留给第5章的注意力接力