5.1 注意力机制原理与分类
5.1 注意力机制原理与分类
本节摘要:注意力让解码的每一步都回头扫描源序列并"按需取用",一举打破单上下文向量的长句瓶颈。本节从翻字典的直觉讲清查询、键、值的分工,再梳理软/硬、全局/局部、自/交叉等常见分类。
4.4 埋了个伏笔:单上下文向量撑不起长句。本节把这根刺拔出来——注意力机制。它不再要求"整句塞进一个向量",而是解码时每走一步,都回到源序列面前,挑自己现在最需要的那几个位置来读,这在整条主线上是又一次"给梯度抄近路"。
不背一整个句子,而是回头翻字典
想象你在翻译一个长句,翻到后半句卡住,需要确认前半句某个词的确切含义。老办法是把整句的意思背熟在脑子里(上下文向量)——越长越背不动;新办法是随时翻开原句,跳到你看的位置查。注意力就是这本"随书记住的字典"。
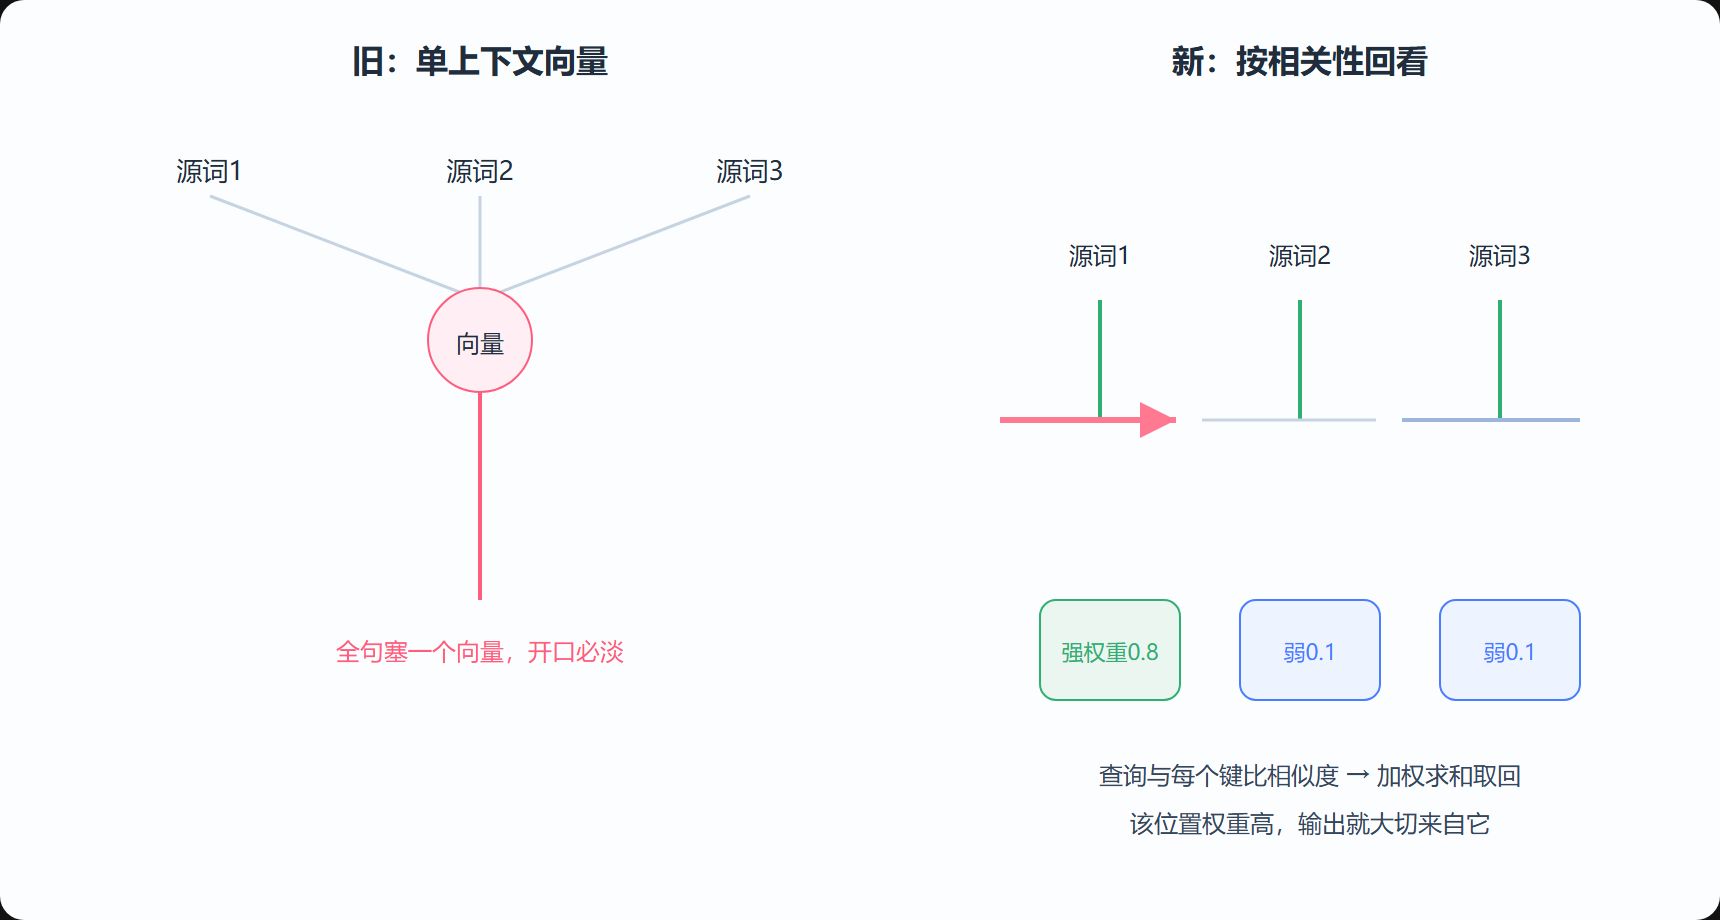
实现上有个比喻很好用:每个源词都有一个"键"(类似词条编号)和一个"值"(类似词条内容)。你手里有个"查询"(当前要填的词该联想什么),它和每个键挨个比一比相似度,得出每个源词的"权重",再用这些权重把各个"值"加权求和。相似度高的位置权重高,输出自然主要取自那句话。三步浓缩成两个问句:该看哪几个位置?每个位置看多重? 前者由查询 × 键决定,后者把权重归一化后乘到值上。
图 5-1 从单上下文向量到按需回看的注意力
把注意力分门别类
主题听起来宽,账目其实好理。按"权重的取法"分:软注意力让每个位置都按 0 到 1 的权重参与、通常可导、可反向传播,是主流;硬注意力则选一个或几个位置、其余为零,更像"随机挑一个",可解释但难训练,用得少。按"作用范围"分:全局注意力看全序列每个位置,效果强、计算重;局部注意力只在一个窗口内找,快但局限。按"来源"分:交叉注意力让查询来自身份不同的模块(如解码器查编码器的输出),自注意力则在同一个序列内部,用自己的位置互相参照——后者是下一个主角。
用一张小表把这几组对立收拢:
| 分类维度 | 一端 | 另一端 | 实务取向 |
|---|---|---|---|
| 权重形态 | 软注意力 | 硬注意力 | 几乎全用软 |
| 作用范围 | 全局注意力 | 局部注意力 | 语义长依赖要全局 |
| 查询来源 | 交叉注意力 | 自注意力 | 编解码用交叉、内部用自注意 |
注意力给梯度带来什么
回到主线最关心的问题:这对反向传播意味着什么。RNN 的梯度要连乘很多时间步的权重才够到远处;注意力则不管位置多远,输出对一个源词的"权重"几乎是一步到位的直接取用,梯度不用翻山越岭,只要走过一道不过分的加权。长程依赖从此不再由"记忆够不够长"支配,而由"权重分配得准不准"支配——这是整本书主线里最釜底抽薪的一次改良。
先用一个直觉来自查
你不需要马上背 Q、K、V 的那套矩阵(那是 5.2 的事),先检验自己是否真懂注意力:给定"北京是中国的首都"要生成"Beijing",解码"Beijing"时,一个训练好的注意力应该把多数权重压到"北京"这两个字上,而不是雨露均沾。想一想——"该看重哪里"本身就是学出来的,这是注意力最妙的一点,也是它区别于窗口扫描的地方。
这不是免费午餐:注意力的代价
抄近路不是白拿。全局注意力的代价随序列长度呈平方增长——每个查询位置都要跟所有键打一次分,序列从 100 涨到 1000,打分次数要涨一百倍。这解释了为什么长文本上会出现局部注意力、滑动窗口、稀疏注意力这些提速变体,也解释了后面 Transformer 为什么对长序列那么计较。看懂代价,你才能看懂 5.3 里学习率要预热、以及后续一代代模型都在想办法给注意力"减重"的动机。
注意力白送的彩蛋:可解释性
注意力还有一个副产品——可解释性。因为每个位置的输出都由一组权重加权而来,推理时你可以把那组权重画成热图,直接看出"生成这个词时,模型最看重输入序列的哪几个词"。它不是唯一解释,却是深度模型里极少数"自带可视化"的地方。这算是给 7.3 埋的一个伏笔:当我们需要给一个黑箱模型讲道理时,注意力热图常常是第一条能摸到的线索。
分门别类记住一句就够了
除了按权重形态、作用范围、来源分类,注意力还能按"打分用什么结构"分:点积注意力、加性注意力等。多数现代模型都选用缩放点积(5.2 详述),因为它实现简单、能被矩阵乘法加速。这些分类记住大方向即可,真正要紧的只有那一句:注意力 = 按相关性的加权取回,其余都是尺度与工程上的变化。
一个把键值讲透的比喻
当别人问你注意力是什么,可以用"会场点名"来记忆:查询像"我现在想问的问题",键像"每个参会者的姓名牌",值像"每位参会者真正要说的话"。你拿着问题问遍全场,看谁的名牌跟问题最搭,就重点听谁发言,最后把听到的内容按搭配合并。想清楚这个比喻,Q、K、V 的分工就再也不会忘——查询定"找谁",键定"能被找",值定"给什么"。
和静态表示比,注意力赢在哪
传统词向量把每个词钉成一个固定向量,无论上下文如何都一个样;注意力则让"某个位置该贡献多少"随上下文动态变化——同一句里的"苹果",谈水果和谈手机时,它对"吃"还是"用"的注意力权重完全不同。这种"上下文相关"正是注意力的灵魂:它不是把信息存成静态档案,而是每次根据"当前要什么"现算现取。
它一开始其实是来救"旧范式"的
注意力的那段历史值得留个心眼:它起初并不是作为"新范式"横空出世,而是为了救"旧范式"——给 RNN 编解码器补一个病根。理解这一点很重要,它提醒你注意力是"贴在旧模型上的解法一步步演化、最终被推到台前"的结果,而不是凭空掉下来的结构。把这一节收进一格:注意力之所以重要,不只是让翻译效果高了一档,更是它教会了我们"让信息被按需取用,而非死记硬背"。带着这份"上下文相关"的直觉,下一节你就不会被 Q/K/V 的矩阵绕晕。
本节要点回顾
- 注意力三步:查询×键比相似度 → 归一化成权重 → 加权求和取回
- 打破单上下文向量瓶颈,长句也能按需取用
- 软注意力主流,硬注意力训练难;全局视野强、计算重
- 交叉注意力跨模块,自注意力同序列自参照
- 梯度的路径大幅缩短,长程依赖从"记忆"变成"分配权重"