5.2 自注意力机制详解
5.2 自注意力机制详解
本节摘要:5.1 把注意力的直觉讲通,本节把它落成能算的机器。先把查询、键、值分别用矩阵投影算出来,再写成一行缩放点积公式,然后看为什么要除以根号维数,最后推多头的动机与做法——读完你能手推一次自注意力的矩阵形态。
自注意力是 5.1 那个"翻字典"直觉的自我引用版:序列里的每个位置既出查询、又出键、又出值,互相参照。上一节我们看了一个解码器去查编码器,这一节把场景缩到一条序列内部,看任意两个位置如何互相打分。
从一句"每个都要看别人"开始
句子"猫 追 狗"里有三个词。自注意力要做的是:算"猫"的时候,回头看它跟"追"有多搭,跟"狗"有多搭;算"狗"的时候同理。重点在于这套打分由数据自己学出来,而不是靠人工规则——这正是上节末尾那句"该看重哪里本身就是学出来的"的具体落地。
查询、键、值从哪来
原始词向量只有一个。要造出不同的"查询、键、值",做法是给每个输入位置乘以三个不同的学习矩阵,做线性变换:
- 查询矩阵 W_q:把输入变成查询,表征"我现在要找谁"
- 键矩阵 W_k:把输入变成键,表征"我能被谁找到"
- 值矩阵 W_v:把输入变成值,表征"我真正想传递的内容"
于是"猫"这个位置变身成三份:q、k、v。它对"狗"的注意力权重,就看 q(猫)跟 k(狗)有多像;真正读进输出的,是"狗"的 v 乘以这个权重。查询管"找谁",键管"被找",值管"给什么"——三个角色分工清晰,网上很多图把这三行画得花哨,本质就这么点事。
缩放点积:一行里的大头账
打分那一步,最常用的相似度就是点积:两个向量对应位相乘再相加,越大越像。用矩阵写,一个序列全部位置同时算,就是:
Attention(Q, K, V) = softmax( Q K^T / √d_k ) V
拆开看这行:
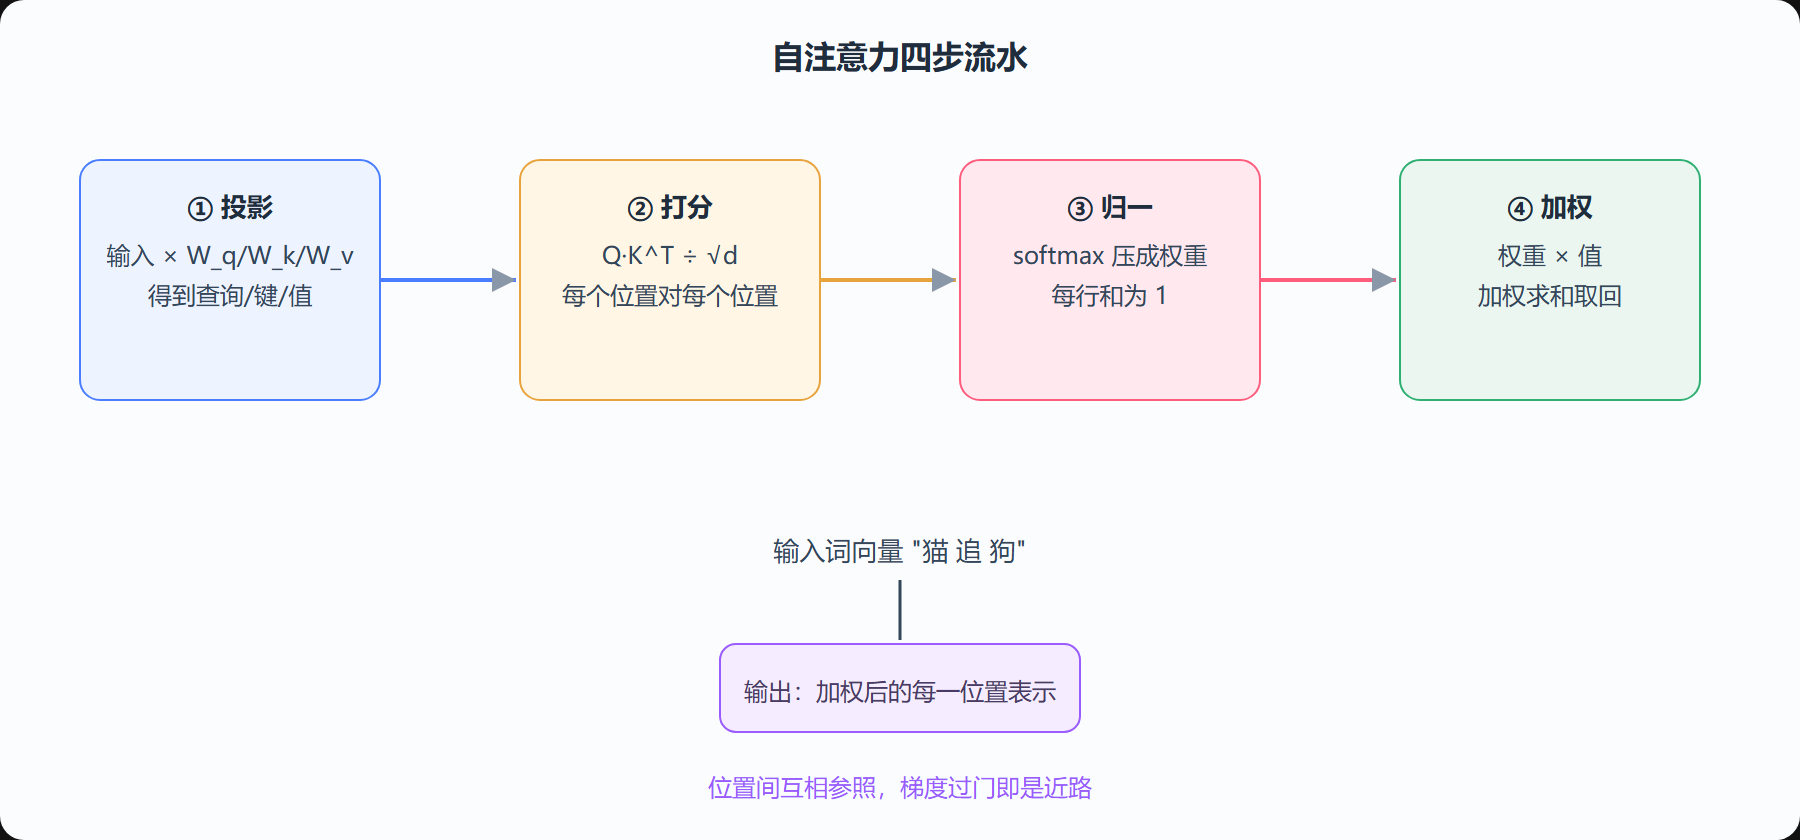
- Q × K^T:得到一张"每个位置对每个位置"的相似度表
- ÷ √d_k:缩放,防止数字太大,把 softmax 推到饱和区、梯度变小
- softmax:把每行压成和为 1 的权重分布
- × V:按权重把各位置的值加权求和,得到这一位置的输出
那一步缩放值得多说几句。当向量维数 d_k 很大时,点积的方差也跟着变大,会有一批量被压成极端的 0 或 1,梯度挤不进中间地带。除以 √d_k 只是顺手把方差拉回 1,是不给 softmax 使绊子的常规动作,不是玄学。
图 5-2 自注意力的四步:投影 / 打分 / 归一 / 加权
多头的动机:别只盯一种关系
一个位置可能同时在找"主谓关系"、又要找"指代关系"、又要找"它离前文哪个词最近"。让同一套 Q、K、V 只打一套分,容易只抓住一种强调的关系。多头就是并行开好几个注意力头,每个头用自己的一套投影矩阵,学习不同类型的依赖,最后把几路的输出拼起来再过一次线性层。每个头其实没改公式,只是在"不同投影空间"里各自做一遍缩放点积,做营收前多接一个拼接与线性投影。
一个头像一份同义词词典,多头像同时翻了语法、地名、人物关系三册再合并意见。合并前还要过残差连接和 LayerNorm,那是 5.3 收进整体结构时再看。这里先记下它"用多套投影把多种关系并行分解"这层用意。
自加一层直觉:权重是学出来的对齐
回到"猫 追 狗"想验证理解:如果训练得当,"追"这一行的输出里,"猫"和"狗"两个位置的权重都会偏高——它俩在语义上都跟"追"有关。这种"关心谁由数据决定"的特性,也让一个问题浮出来:位置信息并没被散步进模型,模型会不会分不清顺序?这就是 5.3 要补的位置编码要解决的问题,本节先在此悬着这个钩子。
自注意力靠"全并行"赢也靠"平方计算"愁
自注意力一度在这里完胜 RNN:RNN 必须一个时间步挨一个时间步地跑,自注意力却把一句话的所有位置同时开算,吞吐一下就拉开了。可它换来的是绕不开的代价——打分矩阵把任意两个位置都算一遍,序列长度为 L 时是 O(L²),长文本一上来就扛不住。于是有了各种近似:把序列按窗切开、限制打分范围、或用局部注意力叠几层全局注意力。想看懂后面模型怎么在"上下文"与"算力"之间取舍,先记住这一句:自注意力赢在并行与远距离,愁在平方级的计算量。
多头到底在看几种关系
可以把多头想象成一组各司其职的"视角":头 1 专抓主谓、头 2 专抓指代、头 3 专抓距离接近。这些分工不是人预先写死的,而是训练时让数据把每种投影矩阵自己训成"一个靠谱的视角"。这也是多头往往比单头效果好的原因——它把"该看什么关系"这道判断题,从一个人单挑,变成让一组专家各自投完票再汇总。回忆 5.1 的"该看重哪里是学出来的",多头就是把这句"学"又往前推了一大步。
一个最小的自注意力走一遍
把"打分-归一-加权"落成最小数字:设两个词的表示分别是向量 u、v。构造一个简化的查询 q = W_q·(u)、键 k = W_k·(v),先把它们点积得一个标量相似度,经 softmax 归一化成权重,再把这个权重乘到值向量上,就得到这步的输出。你在纸上把每一步数字抄一遍,就彻底拆开了自注意力的面纱,也不会再被网上那些花哨的矩阵动图唬住。真正跑一次,是学自注意力最值回票价的一件事。
除以根号维度再补一刀观察
把"除以根号维度"再感知一次:当两个高维向量各自已有一定长度时,点积很容易变得很大,softmax 的输入一把间距拉大,输出就偏向极端、梯度小到没法学。除以根号维度把"输入的规模"拉回恒定,让 softmax 始终落在"有梯度可学"的中段。一句话记:缩放不是调出什么玄学,只是给 softmax 一个"别滑进饱和区"的固定护栏。
本节要点回顾
- 三投影:同一输入经 W_q、W_k、W_v 得到查询、键、值,角色分工不同
- 缩放点积:
softmax(QK^T/√d)V,除 √d 只为把方差拉稳、别让 softmax 饱和 - 多头并行:多套投影在各自空间打关系,再拼接合并,捕获多种依赖
- 权重是学出来的:对齐关系不靠规则,靠梯度一路调出来
- 位置信息缺失:留给 5.3 的位置编码来接