5.4 预训练模型与多模态扩展
5.4 预训练模型与多模态扩展
本节摘要:Transformer 结构成熟后,行业的玩法从"为每个任务单独训模型"变成"先在大语料上预训练、再小规模微调"。本节看清 BERT 与 GPT 的路线之分(双向理解 vs 单向生成),然后顺着这条主线看它如何蔓延到图像、语音、视频构成的多模态世界。
5.3 搭出的是 Transformer 的"骨架",这一节看它如何成为如今大模型的共同底座。"预训练 + 微调"是这套结构带来的最大方法论转变,也是让梯度主线第一次真正发生在"海量数据"身上的地方。
预训练:先把"语感"磨出来
早先的深度 NLP 模型面对一个新任务,要么从随机初始化从头训,要么用词向量当输入,但整体仍是每任务一训。Transformer 的出现改变了打法:先在超大规模、画线即可拿到的无标注文本上,用自监督目标把模型"磨"几周,学出一套通用的语言表示,再在新的小任务上微调。这就是"预训练"。
它之所以可行,靠的是自注意力能并行地处理超长文本,吞吐量大到足以吃下整个互联网级别的语料。主线上的说法是:梯度的大部队先花在"理解语言"上,再花在"服从任务"上,而不是一开始就两眼一抹黑地随机起步。
BERT 与 GPT:双向与单向的分岔
同样是 Transformer,预训练目标不同,走向了两种气质迥异的模型:
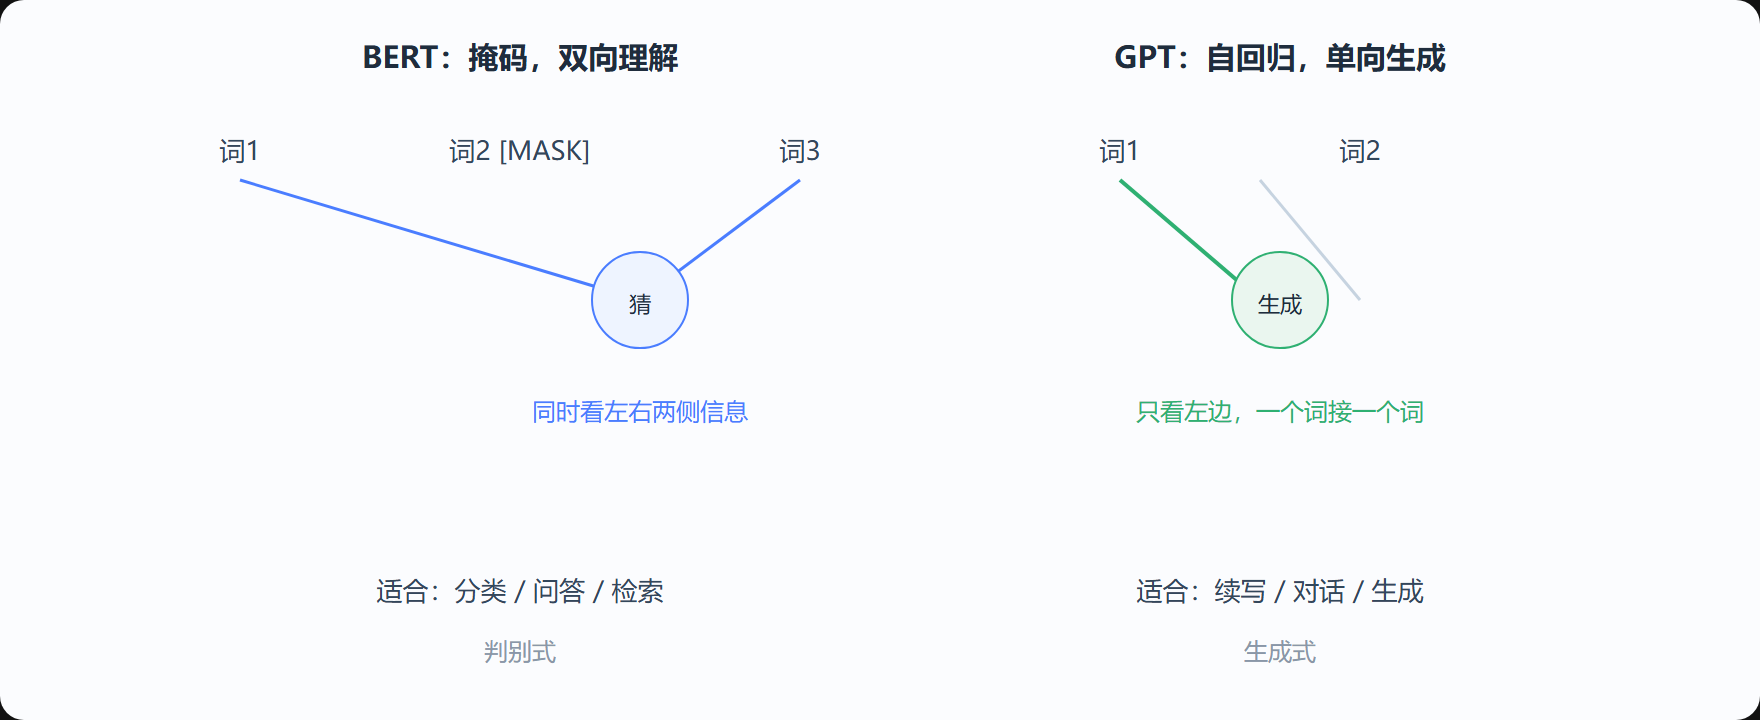
- BERT 用掩码语言建模:随机盖住句中某些词,让模型从上下文两端猜。它学到的是双向理解——看词时会用到它左右两边的信息,适合做分类、问答、检索这类需要"读懂全文"的任务。
- GPT 用自回归语言建模:给定前面的词预测下一个。它天然是单向生成——只利用左侧信息,适合做续写、对话、生成。它的解码器一路叠大,逐步成为如今生成式大模型的主力。
一句话区分:BERT 像"读完再回答",GPT 像"接着往下写"。前者做理解(判别),后者做生成。二者没有高低,只是预训练目标把注意力的"看得多远"和"能不能看右边"这两点锁死成了不同的能力。
图 5-5 BERT 与 GPT:双向看 vs 从左往右
微调 vs 提示:让预训练模型干新活
有了大模型后,"让它干活"也有两条路:
- 微调:拿任务数据把预训练模型再训几步,改改最后的输出头,专刀专用,效果好但每任务要动模型。
- 提示/指令:不动模型权重,只是把任务描述成一个"问答"或"续写"的文本喂进去,让生成式模型直接给答案。省事、灵活,但依赖模型本身的能力。
近年生成式模型越来越强后,后者的比重在不断上升,也衍生出"给模型看几个例子的提示(few-shot)"这类做法。站在主线上看,这两条路说到底都是尽量少地重新移动梯度,把大模型的既有能力借来用。
迈向多模态:不是换能手,是同一套思想
注意力并不在乎输入是字还是一个格子、一个时间片段。于是把图像切成 patch、把音频切成帧,同样丢进 Transformer 编码,就得到多模态大模型。共同的接头是:把不同模态都"向量化",喂进同一套注意力结构,让模型在"图配文字"、"视频配音"这类对齐上学到跨模态的联系。对主线而言这意味着:梯度可以跨模态地流动,模型向量化的立足点从"词"一步步扩展到"世界的碎片"。
这就是为什么前几章打包的 CNN、RNN 和注意力,最终能在一个模型里共存、各司其职:视觉的局部结构交给卷积式的归纳,时序与依赖交给注意力。读到这里再回头看第 1 章的起点,会明白整本书其实一直都在讲同一件事——让梯度以更稳、更省、更远的方式穿过网络。
"规模"大到一定阶段,能力是涌现出来的
参数从亿级涨到千亿级时,模型会冒出很多刻度之外的本领——语料、参数量跨过某个阈值后,忽然学会翻译、推理、对话等原本小模型干不动的技能,学界称之为"涌现"。这不是某个公式能直接推出来的,而是规模带来的量变:当注意力能把海量上下文同时吃进、再用自回归规整得井井有条,那些长程的规则就被"磨"出来了。这句话的另一面是现实的门槛——训练要的算力与数据只有头部团队负担得起,多数团队靠"借用预训练权重"享受这份红利,这正好对应第 7 章 7.2 讲的迁移学习。
多模态不是"多一个模态"这么轻
把图像切 patch、把音频切帧,再丢进同一个注意力结构,听起来顺理成章,落地却卡在"对齐"两字:一张图配一句话,"哪段声音对应哪个词"要在训练里由模型自己学出来。跨模态注意力、对比学习(把图与文的表示拉近)、多模态融合层,都是围绕"对齐"展开的招。明白这一点,你会理解多模态大模型的瓶颈往往不在结构,而在"让不同模态互相咬合的数据与目标"。这也是它对第 5 章那套思考的又一次验证:规律都在,只是对象从"词"扩大到了"世界的碎片"。
预训练到底在"练什么"
预训练模型学的不是"某一个任务",而是"语言本身的统计规律":什么词常挨着什么词、什么样的句子结构说得通。这份"语感"一旦被磨出来,几乎不用再问"具体要干嘛"——因为任何下游任务都要先理解语言。这也是为什么同一份预训练权重,能同时服务翻译、分类、问答这么多任务:它们共享的语言底座是同一个。
"指令"才是把能力接出来的钥匙
有了大模型后,能不能用好它的关键,常常不在模型本身,而在"怎么把需求描述给模型"。指令工程讲的正是这套"把需求翻译成模型听得懂的话"。它和微调并不互斥:指令给"短时、可改"的能力,微调给"持久、定向"的能力,实践中常两者混用。站在主线上看,指令本质也是不动梯度、尽量少改权重地"借用已有能力"——前面讲的"少动梯度"思想,在这里体现得最极致。
本节要点回顾
- 预训练:在海量无标注文本上磨语言表示,再到小任务上微调
- BERT 双向理解(掩码猜词)用于判别类任务;GPT 单向生成(自回归)用于生成
- 微调改权重,提示不动权重,指令式玩法比重上升
- 多模态是同一套思想:把图像/音频向量化,喂进同一注意力结构
- 全册收束:CNN、RNN、Transformer 都是为了梯度更稳更省更远