5.3 Transformer:编码解码与位置编码
5.3 Transformer:编码解码与位置编码
本节摘要:5.2 有了自注意力这块砖,本节把它垒成 Transformer:编码器堆叠注意力 + 前馈网络 + 残差与 LayerNorm,解码器在中间再插一层交叉注意力;随后解释位置编码为何必须有、正弦位置编码怎么加;最后讲几点让它训得动的工程习惯。
Transformer 这个名字常被当成"注意力 + 一堆层"的代名词。5.2 造出的是单块注意力,现在要回答:这些块怎么搭,才能让一个文本或图像进得去、出得来,而且整条反向路径上的梯度还稳得住。
编码器:堆叠 + 残差 + 归一
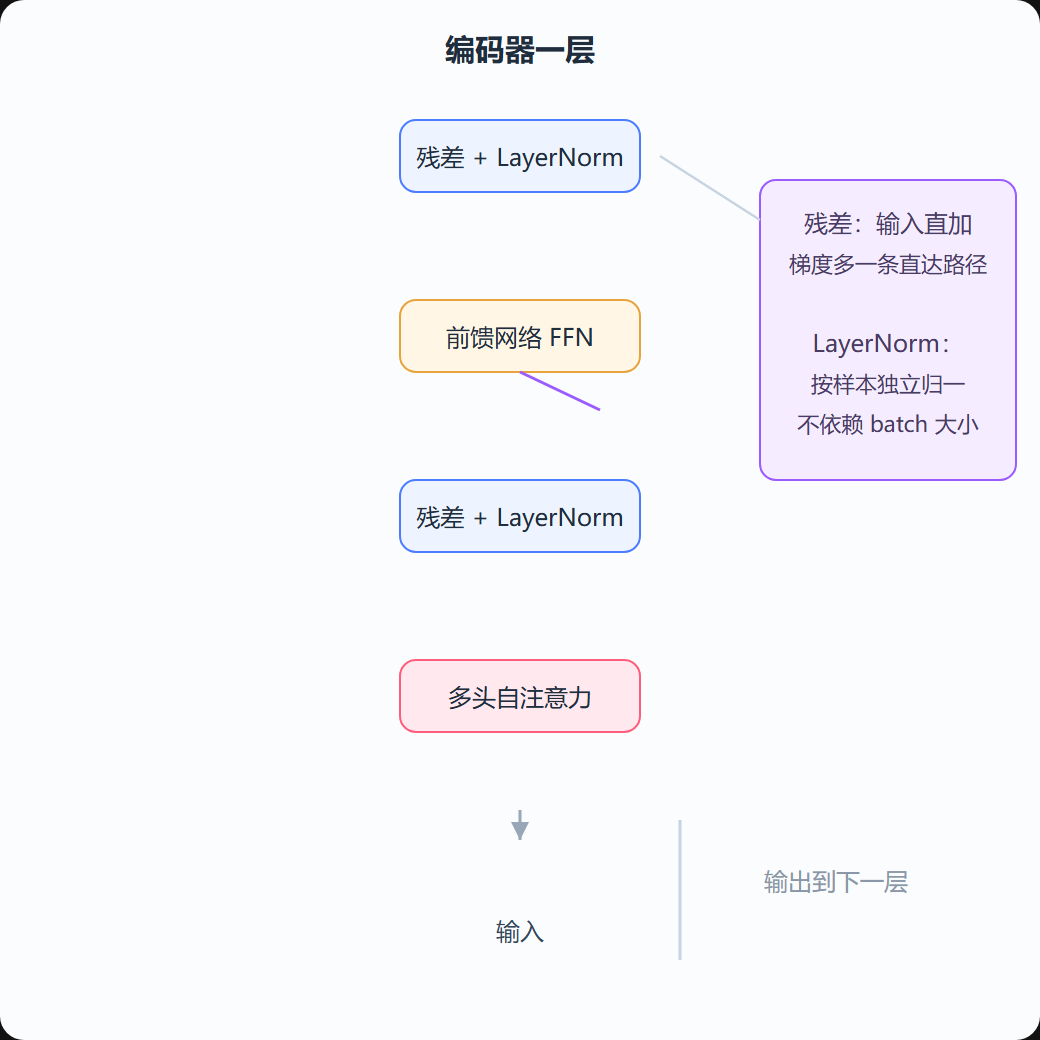
一个编码器层不是只有一个注意力,而是把它和一个小型前馈网络串起来,外面再包上残差和归一化。每一层的顺序大致是:
- 多头自注意力:看同一序列里所有位置互相参照
- 残差连接:把输入直接加到输出上,为梯度让出一条直路
- LayerNorm:把这一层的激活拉回稳定尺度
- 前馈网络:一个两层的全连接,给每个位置来一次独立的非线性变换,再同样过残差 + 归一
这样一层层叠起来,就组成了"又深又能训练"的关键:残差让深度不再逼仄梯度,LayerNorm 稳住数值尺度。这里用的归一化是 LayerNorm 而不是前面第 2 章见过的 BatchNorm——它不依赖 batch 大小,且对每个样本独立归一,更适合 Transformer 这种 batch 可能很小、序列不等长的场景。
图 5-3 编码器一层的装配次序
解码器:多出来的交叉注意力
解码器依旧堆叠注意力和前馈,但每个解码层里有两处自注意力、一处交叉注意力:
- 自注意力(掩码):生成第 t 个词时只能看前面已生成的词,不能偷看未来,所以用一个上三角掩码盖住"未来"的注意力
- 交叉注意力:让解码器用"自己的查询"去查编码器的键和值——也就是回去参考整句输入
- 接着的前馈、残差、归一和编码器如出一辙
一句话,编码器负责把输入读成一组表示,解码器负责在生成每一步时既参考自己已写出的内容,又回头参考输入——正是 5.1、5.2 那套直觉的完整搭架。
位置编码:没有顺序的自注意力缺了什么
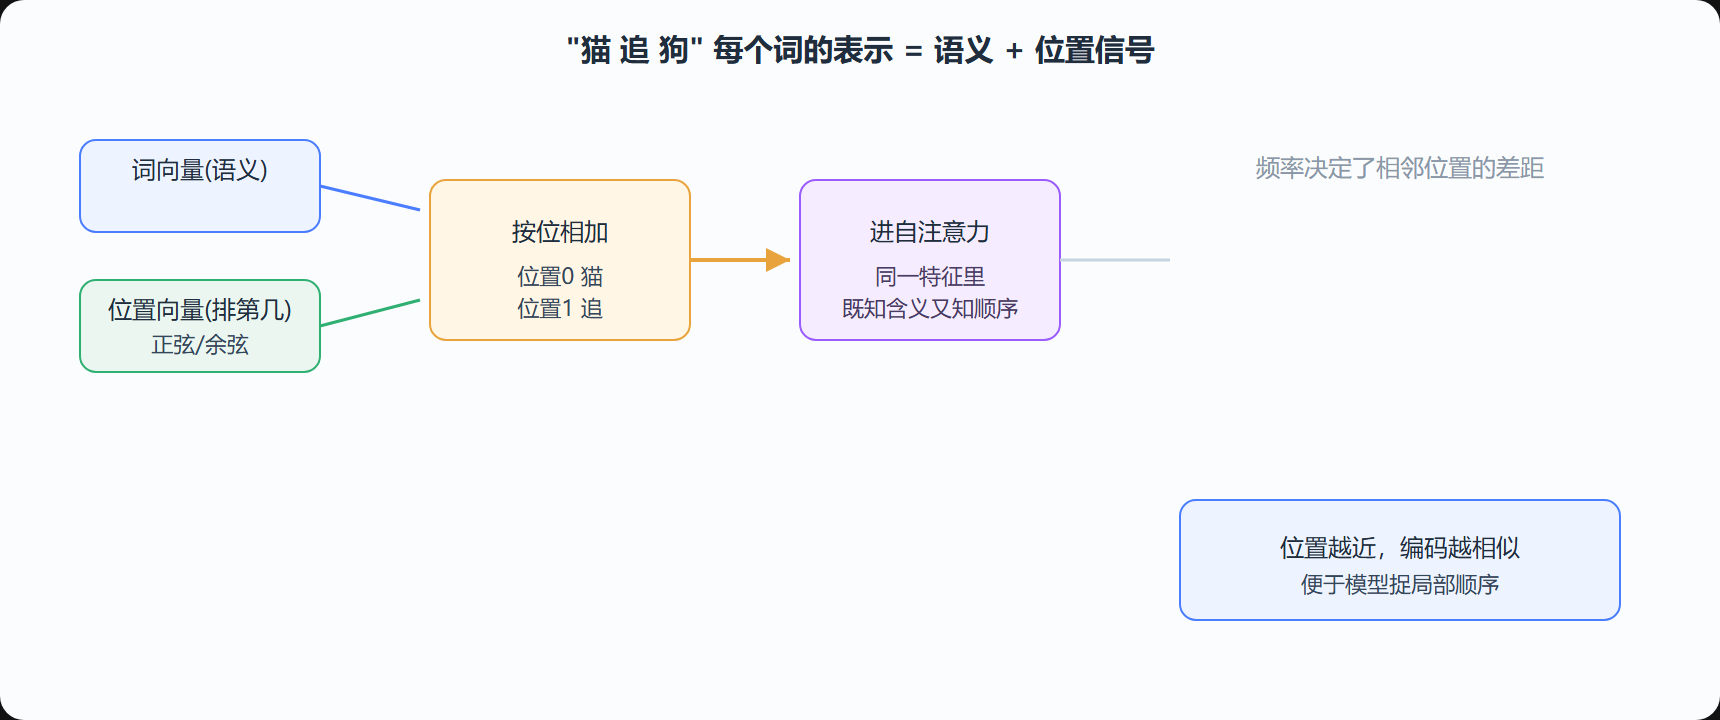
自注意力有一个没解决的麻烦:它是排列无关的。把"猫追狗"换成"狗追猫",注意力打出的分一分都没变,因为每个位置拿到的信息不含"我排第几"。位置编码就是给每个词向量额外加上一个关于它在序列里的位置的信号。
最简单的想法是给每个位置带上一个可学的向量(位置嵌入),经典的 Transformer 用的是正弦位置编码——用不同频率的正弦、余弦,让每个位置得到一个独一无二的向量,且相邻位置的编码相差较小,便于模型捉到局部顺序。具体的做法是直接把词的语义向量和位置信号按位相加,让模型在同一份特征里既看到"什么意思"又看到"排第几"。
图 5-4 位置编码:把"排第几"揉进向量
怎么把 Transformer 训得动
结构立起来后,工程上有几句话值得记:
- 注意力代价随序列长度平方增长,太长会算不起,成了后面模型要改进的重点之一
- 学习率要先预热再线性/余弦衰减,作用于大模型能防止一开始就爆(和第 2 章的调优一脉相承)
- 标签平滑、Dropout 这类规整手段照常用,别因为模型强大就省
- 解码是自回归的:学过词一个接一个出来,训练时用掩码强制只看过去
别把 LayerNorm 和 BatchNorm 混
这里用的归一化是 LayerNorm 而非前面见惯的 BatchNorm,原因值得记住:BatchNorm 在一整批样本的所有位置 / 通道上算统计量,而 LayerNorm 只对单个样本自己的所有维度做归一。Transformer 的 batch 常常很小、序列又不一定等长,BatchNorm 那种"跨样本求均方差"的统计量会抖得很厉害,LayerNorm 却天然稳定。这也是它固定陪在残差身边的原因——残差管信息直通,LayerNorm 管每一块的数值尺度,一对搭档配合默契。
位置编码到底"编码"了什么
正弦位置编码那句"不同频率",落到底层是这样:给序列里每个位置 i 配一对正弦 / 余弦值,频率随维度交替变化——越靠后的维度周期越长。低维部分能拉开"相邻位置",高维部分能拉开"很远的位置",于是任意两个位置的相对位移都能被模型读到(挪了几步会体现在可预测的相位差上)。它并非唯一做法,近年也有可学的位置嵌入、旋转位置编码,但它们最初都为了同一件事:让排列无关的自注意力重新认识"顺序"。
解码为什么非要"掩码"
解码器那个"防偷看未来"的掩码,背后是个硬要求:训练时必须模拟推理时的场景——推理时第 t 个词只能依赖它之前生成的词,所以训练也强行让第 t 个位置在自注意力里看不到它往后的任何词。具体做法是在 softmax 之前把未来位置的注意力权重用一个很大的负数盖成负无穷、让它们归零。这一笔既是训练 / 推理一致性,也是自回归模型的立身根本。理解之后,5.4 里 GPT 的"单向生成"也就顺理成章——它正是把这种自回归解码一路做到极致的结果。
一次把残差与归一在线上排清
残差与归一化的组合位置是有讲究的:先让残差把输入并上,再做归一,内外核一致——残差保证信息与梯度有直达近路,归一保证每条路径的数值尺度不至于失衡。记住"主干抄近路、支路求稳定"这一对,你就握住了几乎所有现代深度块(包括后面更大的模型)的装配逻辑。心里带着这对搭档,读任何 Transformer 变体都会顺手很多。
掩码是不可省的纪律
解码器这个"防偷看未来"的掩码虽是工程细节,却是"不自回归不成 Transformer"这条纪律的落点——训练时必须和推理保持一致,否则生成阶段会像偷看了答案一样在分布里开倒车。写代码时务必把它保留下来,而不是靠"反正最后都一样"去省掉它。
本节要点回顾
- 编码器层:多头自注意力 + 前馈 + 残差 + LayerNorm 叠起来
- 残差让梯度有直达路,LayerNorm 不依赖 batch 大小、稳住尺度
- 解码器多一个交叉注意力:参考输入序列,另有掩码自注意力防偷看未来
- 位置编码是自注意力排列无关的解药,正弦编码按位相加进词向量
- 工程三件事:注意力平方复杂度、学习率预热、自回归解码