6.1 生成对抗网络 GAN
6.1 生成对抗网络 GAN
本节摘要:GAN 让两个网络互相较劲——生成器造假、判别器抓假,两者在一个极小极大博弈里互相逼着进步。本节讲清损失从哪里来、为何训练容易反复摇摆,以及几招常用稳定手段,最后把它放回"梯度往哪走"的主线。
前面几章的损失都来自"预测和标签的差"。GAN 换了个玩法:不给生成器一个明说"什么样算好"的答案,而是让一个判别器来当裁判,边当边升级。生成器写的图,真不真,由判别器说了算;而判别器越强,生成器被迫越写越像真的。
造假的与抓假的
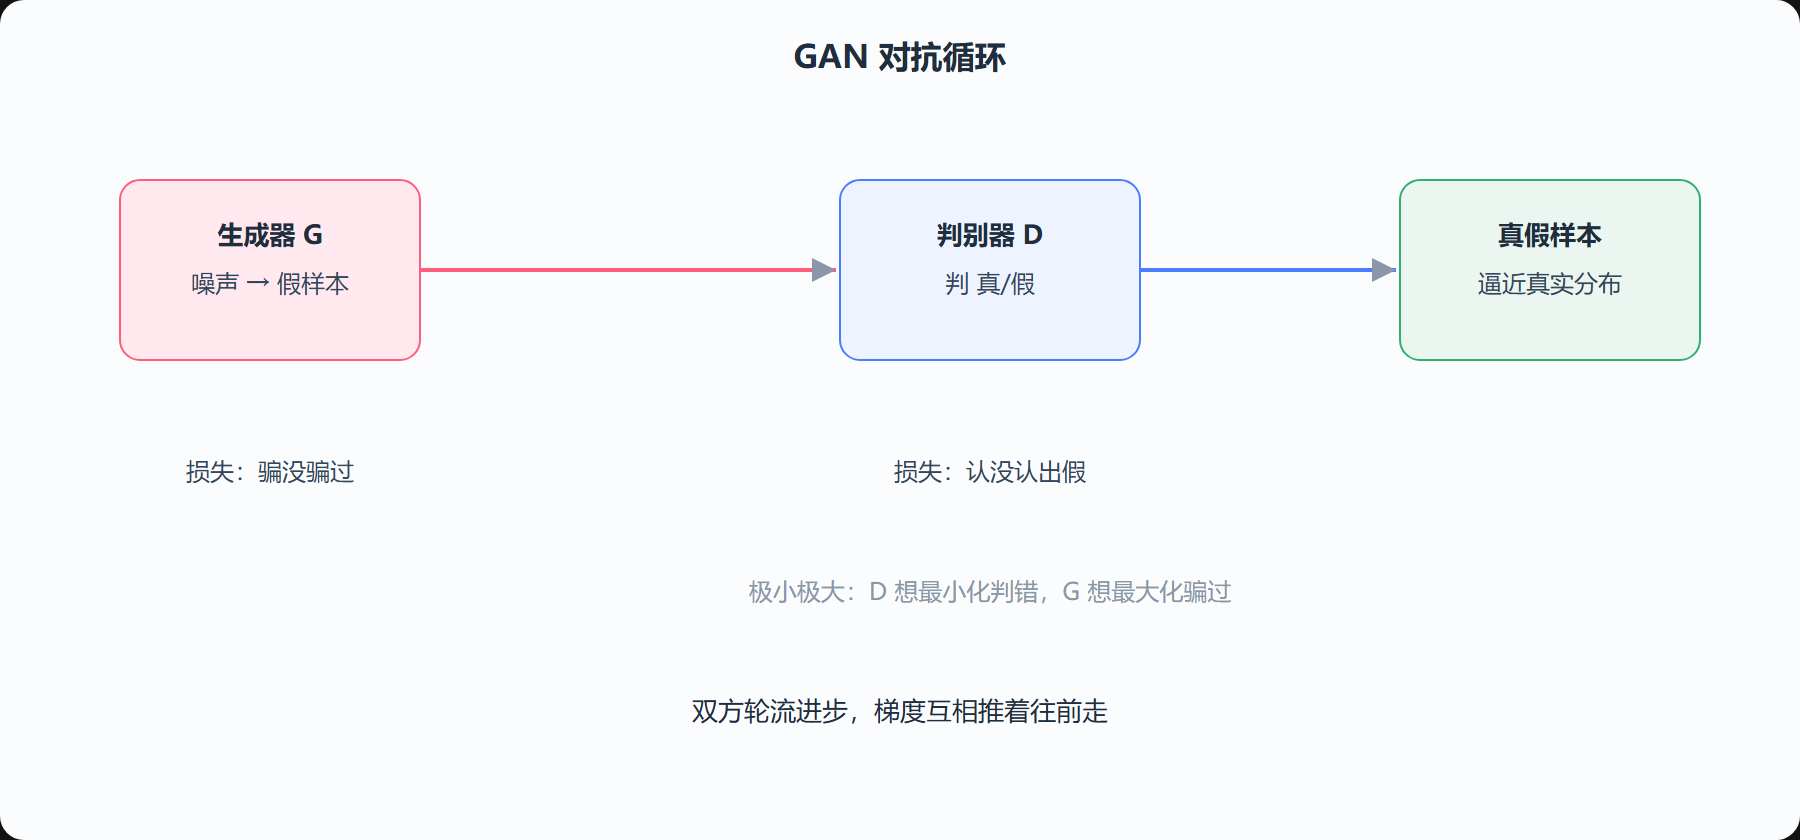
把两方摆到台面上:
- 生成器 G:从随机噪声里变出一张像样的样本,目标是骗过判别器
- 判别器 D:接收一张图,判断它是"真"还是"假",目标是把假货认出来
两者你一步我一步地练:判别器使劲练鉴别,生成器在"没骗过"的信号下使劲练伪造。这不像监督学习的单一损失,而是双方轮流上升的对抗。
图 6-1 对抗训练的一轮循环
一个极小极大的目标
把双方的拉扯写成一行,就是常见的对抗损失形式:判别器 D 想让它对真图判"真"、对假图判"假";生成器 G 想让 D 对生成的图判"真"。损失既不是最小化一个绝对差,而是两方在一个极小极大博弈里互相牵制——D 努力把损失压低,G 努力让 D 的错误变大。博弈达到某种平衡时,生成的分布就贴近真实分布。
正因如此,它和前面每章都不同:没有一个"标准的正确答案"当锚,真伪的标准由对抗中动态形成。这也是"梯度往哪走"这个问题第一次不是定向的、有唯一解的。
为什么 GAN 难训
对抗听起来很妙,落到工程上却常常翻车:
- 双方不平衡:判别器练得太强,生成器得不到有效的梯度信号,怎么折腾都被一眼识破,停在原地。
- 模式崩塌:生成器找到一个"能骗过"的窄分布就赖着不走,只输出几种样本,多样性消失。
- 训练震荡:双方交替上升经常来回咬,loss 不单调,很难盯出一种平稳的收尾。
稳住的办法不少:用梯度惩罚约束判别器别太爆,用谱归一化把权重尺度拉回合理范围,或者改用 WGAN 这类换掉距离度量的变体。它们共同的思路是给对抗这匹野马套上缰绳,让梯度不来回乱甩。
GAN 的位置:生成模型的一支强军
在今天,纯 GAN 做文本和稳定大图时已渐渐让位给扩散模型(6.2),但它的对抗思想、模态翻译、高辨率编辑等场景仍常常被征用。对主线而言,GAN 的遗产是把"损失可以来自另一个正在学习的网络"这层边界拉开了——这也让下节讲的 VAE 与扩散显得有对照可言。
这一点决定性的不同:梯度往哪走是不定的
前面每个模型的优化,都有一个明确的下降方向;GAN 却要让两个网络对同一个打分互相拉扯——判别器想让自己的输出向"真/假正确"靠近,生成器想让判别器对它的输出判"真"。这等于一个想往上、一个想往下,目标函数并不凸,也没有一个摆在明面的"全局最优"。正是这种"方向互相牵制",让梯度下降在 GAN 里不再保收敛,反而可能陷进永无休止的摇摆。这也是为什么 GAN 训练被形容成走钢丝,而不是稳定的下山。
三个难处,一个生活化的对号入座
把难的三个点放进更生活的图景:造假者与鉴定师互相斗智。鉴定师一眼识破,造假者失去反馈、越做越僵——这是梯度消失;造假者钻研出唯一一种像画法,靠它骗过鉴定师就不肯学别的——这是模式崩塌;两人水平此消彼长、来回拉扯,谁也稳不下来——这是训练震荡。这三面镜子,把对抗直观映射成工程难题。稳住它们靠的并不是某一段公式,而是梯度惩罚、谱归一化、换度量(WGAN)这一串"给野马套缰绳"的手法。
GAN 走过,留下更宽的边界
今天纯 GAN 在做大图和稳定生成上已渐渐让位给扩散模型(6.2),但它在图像到图像、风格迁移、超分辨率等场景仍是常客。对主线而言,GAN 最重要的遗产是把"损失可以来自另一个正在学习的网络"这层边界真正拉开了——它证明监督信号不一定要是贴好的标签,也可以是一场动态博弈的产物。理解了这一步,下一节"重建误差"与"去噪误差"这两种温和玩法就有了可比对的参照系。
判别器与生成器该各练多少步
工程上最常见的一个旋钮是双方练步的节奏:先让判别器多练几步、站稳了再审生成器,能避免生成器对着一个瞎判的裁判瞎学;但判别器又太强又会把生成器梯度冲掉。于是各家给出各种节奏调度,本质都是在"裁判太弱、太强都不行"之间找平衡。这一点也解释了为什么 GAN 复现那么挑细节——不是某一两个超参在起作用,而是整套博弈节奏都要人盯着。实际操作上把两个网络的学习率、更新步数当成一个整体去调,别孤军动其中一个。
一个可以手写的最小目标
用伪码把双方目标写一行,对照着读比背术语快:判别器让 D(真图)→1、D(生成图)→0;生成器让 D(G(噪声))→1。训练就在"D 努力让这两句得分正确,G 努力让后一句骗过 D"的来回中推进。你不需要真把数学展开,只要记住"判真得分、拆穿假货、骗过裁判"这三句,就能在脑子里模拟一轮对抗过程。
和"自监督"相比,GAN 特别在哪
自监督(比如 5.4 的掩码猜词)和 GAN 都是"无标签也能学"的范式,但机制一个向东一个向西:自监督的信号来自数据内部某段可预测的目标(如被盖住的词),GAN 的信号却来自一个同龄的、正在变强的判别器。前者依赖"预设一个可预测的任务",后者不预设任何真假标准、让标准在对抗中自己长出来。这一步之隔,正是"损失从哪来"这个母题的两种典型答案。
把 GAN 放进主线再看一次
把 GAN 放回主线想一次:它没有标准答案,却依然要用梯度。所谓对抗,不过是把"答案在哪个方向"这道难题,交给两个互相质检的网络在训练中自己解出来。理解到这一层,再回看前面所有"给梯度找路"的手法,会发现它们其实是同一个母题下长长的一串变奏——区别只在于,GAN 连"标准答案"本身也让它在对抗中动态长出来。
本节要点回顾
- 两方博弈:生成器造假、判别器抓假,轮流升级
- 极小极大目标:没有绝对标准,真伪标准在对抗中动态形成
- 三大难处:失衡、模式崩塌、训练震荡
- 稳住手段:梯度惩罚、谱归一化、WGAN 等换度量
- 主线定位:把"损失来自哪里"的边界第一次真正拉开