6.2 变分自编码器与扩散模型
6.2 变分自编码器与扩散模型
本节摘要:同样是生成模型,VAE 走"压缩成隐变量再重建"的路子,扩散模型走"一步一步加噪再一步一步去噪"的路子。本节分别讲清它们的损失从哪来、生成怎么发生,再做张对照表收束,并指出扩散如何在稳定上胜过前两者。
上节 GAN 用对抗逼出真实分布,这一节的两位主角不打对抗,各自给出更温和的生成方式:VAE 学一个能把样本"压扁再松开"的隐空间,扩散模型则从噪声里一步步"洗"回一张图。理解它们,重点在它们的损失分别是重建误差和去噪误差——方向不一样。
VAE:压进去再松开
自编码器是"编码压缩 + 解码还原":编码器把输入压成一个隐向量,解码器把它还原回输入,用重建误差当损失。普通自编码器只学到了"如何复现训练集",拿中间那个隐向量当输入时未必能生成像样的新样本,因为它的隐空间是稀疏、没规律的。
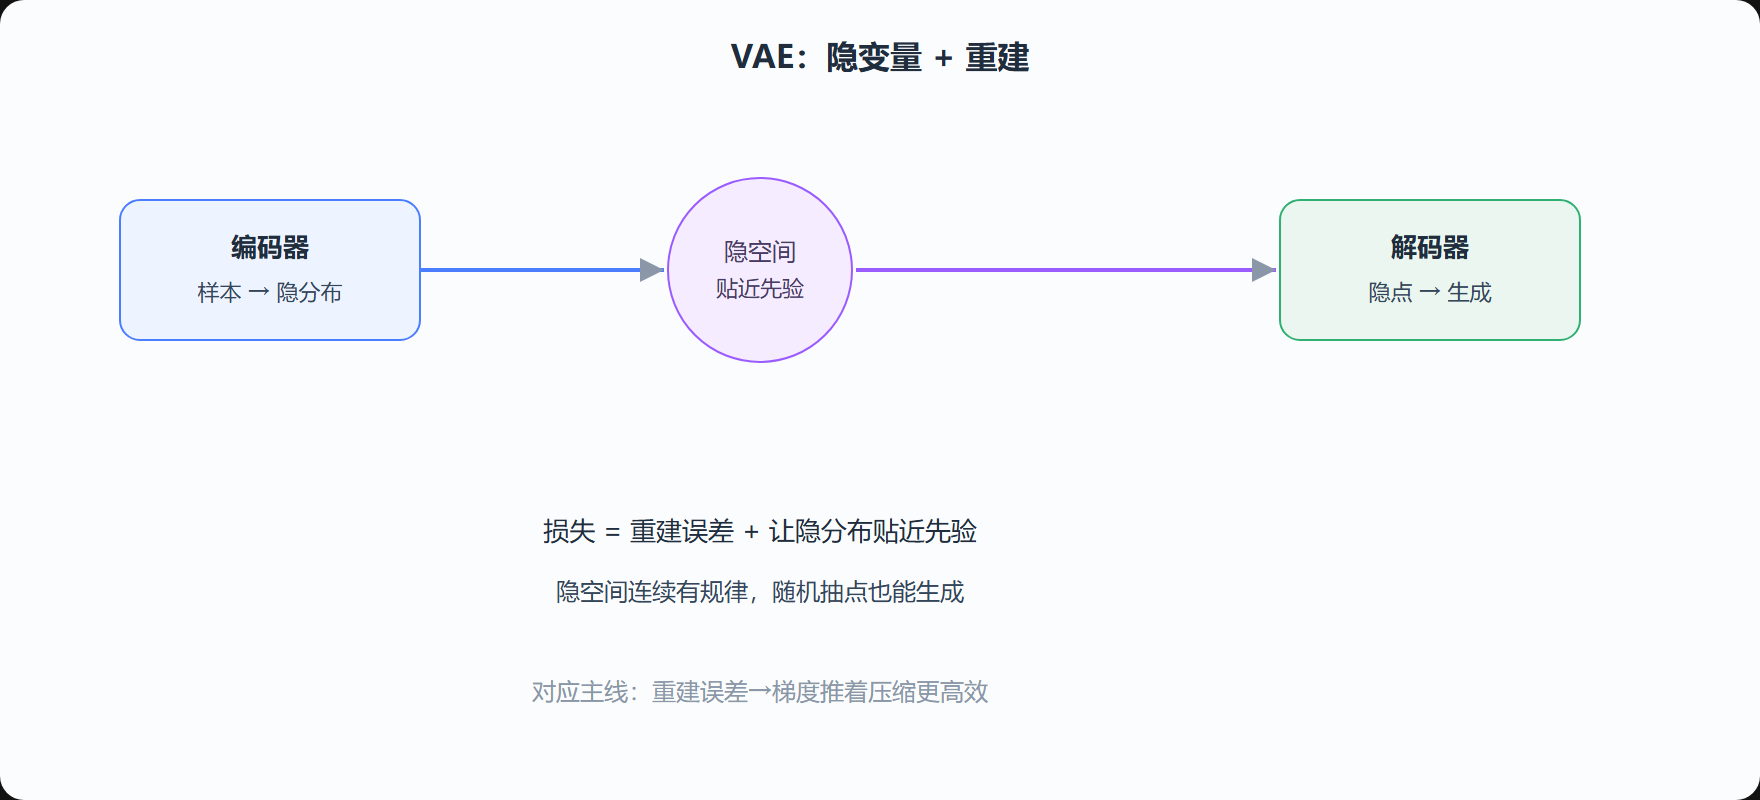
VAE(变分自编码器)的改进是:让隐变量不是单一确定值,而是一个带稀疏正则的概率分布,要求编码器输出的隐变量尽量靠近一个简单的先验(通常是一个标准正态)。这么做的好处是隐空间被"糊平"成连续的、有规律的网格,从里面随便抽一个点,解码器都能还原出合理的东西——生成能力就来了。它的损失 = 重建误差 + 一个让隐分布贴近先验的项,后者起正则作用。
图 6-2 VAE 的压缩与生成
扩散模型:加噪再洗回来
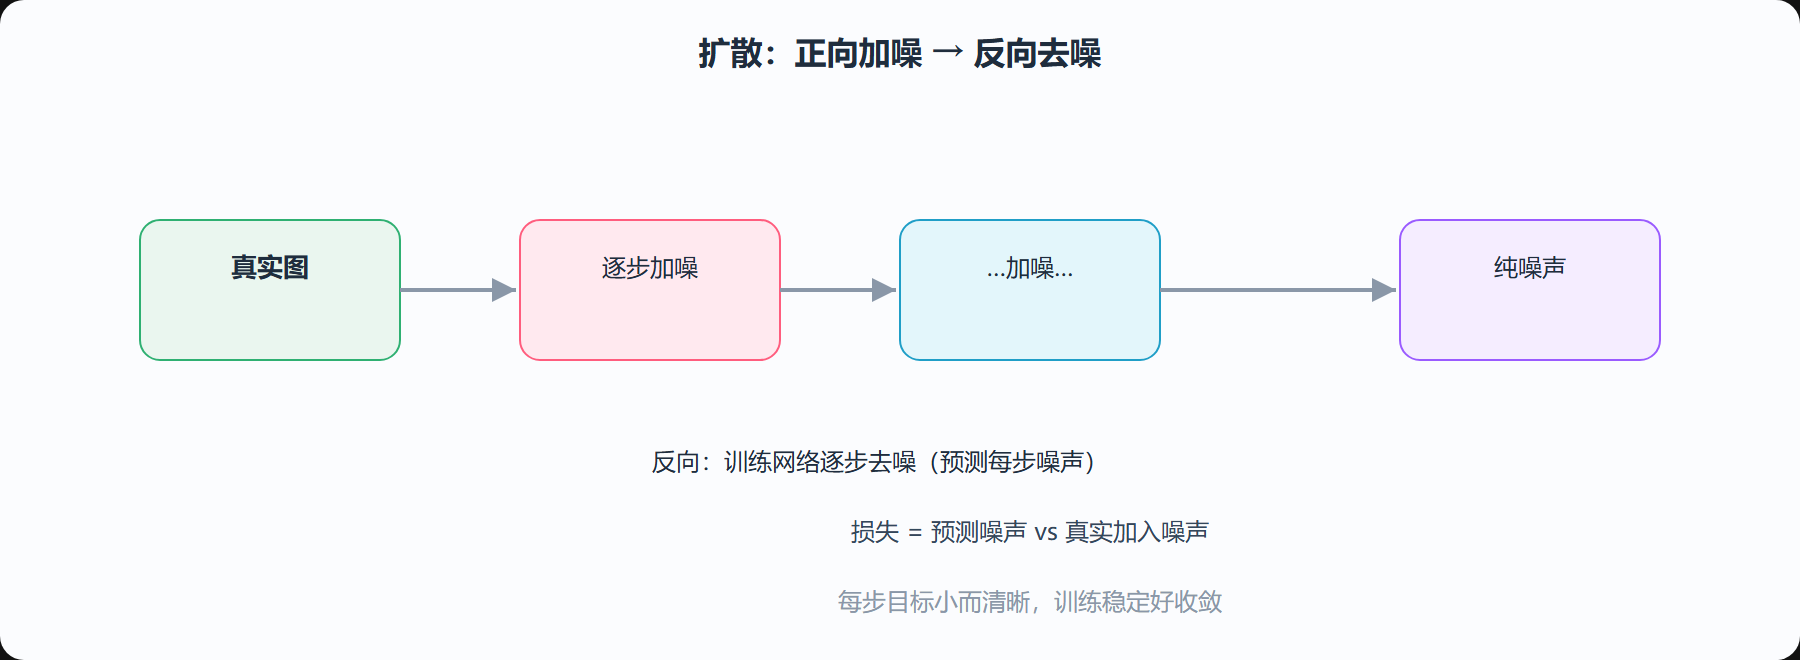
扩散模型换了一个更直观的骨架。正向过程:把一张真实图像逐步加噪,加到最后彻底变成一片毫无结构的噪声,这一路每一步由训练数据给出确定的"加噪目标"。反向过程:训练一个网络,从纯噪声出发,逐步去噪,一路"洗"回一张图像,它在每一步学习"上一步的噪声有多大"。
损失因此就是去噪误差:模型预测的噪声和真实加入的噪声之差。生成时,先随机抽一个噪声,再让网络一步步把噪声挤掉,得到样本。因为每步只预测一个很局部的去噪,训练目标清晰、稳定,不打架——这正是它比 GAN 好训、比 VAE 生成质量更细的原因。
图 6-3 加噪—去噪闭环
一张对照表收束
| 方法 | 玩法 | 损失 | 优点 | 短板 |
|---|---|---|---|---|
| GAN | 造假 vs 抓假 | 对抗 | 采样快、清晰 | 难训、模式崩塌 |
| VAE | 压扁松开 | 重建 + 先验 | 结构清、好收敛 | 生成偏糊 |
| 扩散 | 加噪去噪 | 去噪误差 | 稳定、质量高 | 采样慢(逐步去噪) |
放到主线上一句话:这三家都在设计"什么样的损失能让梯度把生成推向真实分布",GAN 用对抗,VAE 用重建 + 先验,扩散用逐步去噪——手法不同,目的相同。
"隐空间是连续的"到底方便了什么
VAE 两个亮点里,最该抓的是"连续"。普通自编码器的隐空间可能是断断续续的几小团,彼此之间没有路;VAE 因为加了"贴近标准正态"的先验,把隐空间"糊"成一片连续、平坦、中间没有沟壑的房间。于是在里面随便采一点坐标,解码器都能给出一个说得过去的样本;在两个点之间插值,还能得到介于两者之间的过渡图。这就是生成与"被理解"之间的桥梁:一个空间只有连续,才谈得上可采、可插、可探索。
扩散为什么在"稳定"上笑到最后
扩散最大的优势藏在"目标清晰"四个字里。它每走一步只让网络去猜"这一步加进图的噪声有多少",目标简单、确定性高、梯度稳;GAN 要跟一个正在变的裁判打架,VAE 的隐空间先验与重建误差之间也有权衡。而扩散把"复杂的整体生成"拆成许多"简单的局部去噪",每步独立可训,配合重参数化后的稳定梯度,就在生成质量与训练稳定上双重占优。代价也诚实——生成要顺着整条去噪链一步步走,比 GAN / VAE 慢得多。这三家的高下,本质都在"梯度目标清不清晰"上见真章。
重建误差为什么"还不够"
普通自编码器只背得下"如何复现训练集",但那个隐空间其实没规律——训练集之外的中间点解码出来往往一塌糊涂。VAE 用"让隐分布贴近标准正态"这一招,把原本东一块西一块的隐空间"熨平"成连续、无沟壑的地板。正是因为平,随机采点、之间插值才都安全。读懂这一步,就不用花太多精力纠结"为什么叫变分",先抓住"它让采样变安全"这个物理意义。
一行损失怎么看
VAE 的损失 = 重建损失 + 先验正则。前者逼着"从隐变量能还原回原图",后者逼着"隐变量的分布别太野、尽量贴着标准正态"。这两项在互相打架:正则太强,重建就糊;正则太弱,隐空间又回到无规律。工程里常调这两项的配比,而这一拉一扯的平衡,正是 VAE"偏糊但可控"的来源。
为什么能"反向传播进随机采样"
VAE 中间有个"从分布采样隐变量"的动作,而"采样"本身不可导。它靠重参数化技巧绕开:不直接采 z,而是先采一个标准噪声 ε,再用 均值 + 标准差 × ε 拼出 z。这样随机性从 ε 注入,均值与标准差却仍然可导、能接受梯度。这一个小把戏,是整个 VAE 能训练起来的地基。
扩散采样慢,怎么治
扩散生成慢,是因为要顺着去噪链一步步走很多步。加速有两个方向:要么用更少但更聪明的步数(不同采样器的差别主要在这),要么用蒸馏把多步去噪压缩成一个更快的学生。理解这一点,就明白为什么"扩散质量好"与"生成要快",在当下一直是两条竞速的赛道。
工程上怎么挑那三家
补一个工程常用的直觉:选 VAE、扩散还是 GAN,往往不是"谁最好",而是"当下你更在乎什么"——生成要稳、质量要高,选扩散;要即时、能接受一定训练难度,选 GAN 或 VAE;要想端到端好训、结构清晰,VAE 最省心。把这些权衡记住,等你真的接到一个生成需求,就能按"质量、速度、稳定性"这三个抽屉去挑工具,而不是被宣传话术牵着走。
只要把「损失长什么样、梯度朝哪走」这两个问句挂在心里,无论面对哪种生成模型,你都能三句话把它放回这条主线。
本节要点回顾
- VAE:隐变量从确定值变成分布,加先验正则,隐空间连续可生成
- 扩散:正向加噪、反向去噪,损失是去噪误差
- 对比:GAN 快但难训,VAE 稳但糊,扩散稳又细但靠时间换
- 主线:三种方式殊途同归,都在把梯度往真实分布推