6.4 图神经网络 GNN
6.4 图神经网络 GNN
本节摘要:图像是规则网格,卷积顺手就能用;可很多数据是"图"——分子、社交网络、推荐关系,结构不规则。图神经网络用"邻居聚合"替代固定网格卷积,为这类结构提供匹配的归纳。本节对比图与图像的结构差异,讲清聚合与消息传递思路,再落到典型应用。
第 3 章 CNN 之所以好使,靠的是"图像是整齐的网格,大家位置固定"。可现实里大量数据是一张图:分子里原子连成键,社交网络里人与人连着关系。图的节点数量不定、邻居数量不定、也无所谓全局顺序——这套规则网格的卷积就不称手了。图神经网络(GNN)做的就是给这类"不规则结构"造一套卷积的替代品。
图和图像,差在哪
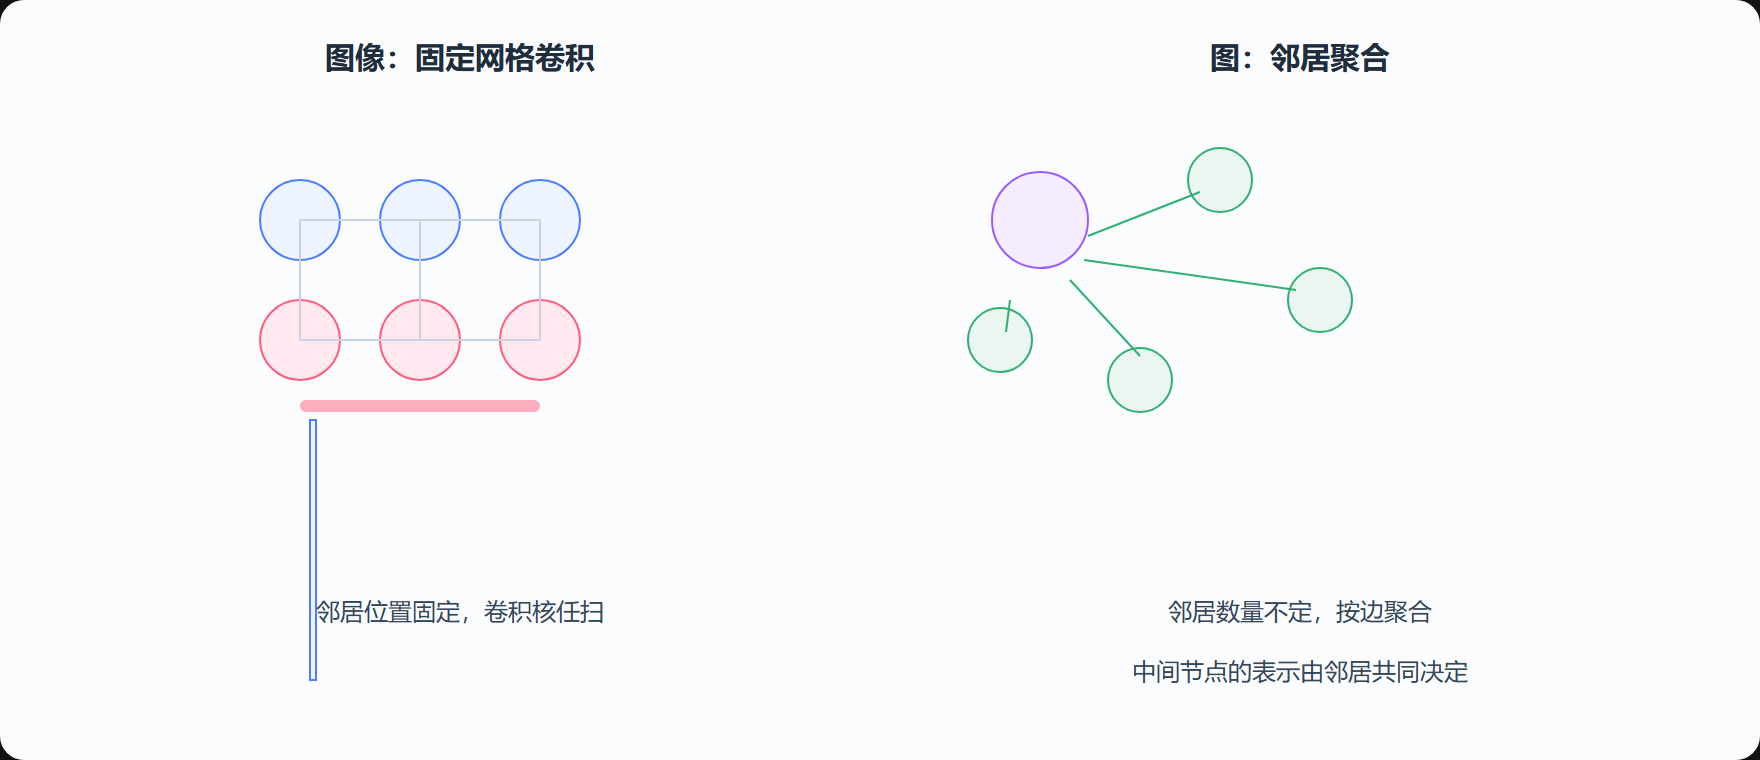
图像你随时能问"第 i 行第 j 列是谁";图却没有"第几个邻居"恒定的说法。一张图中,节点 A 连着 3 个邻居,节点 B 连着 7 个邻居,它们彼此异构。CNN 那个"固定大小的卷积核扫过去"的前提失效了。于是 GNN 的核心假设变成:一个节点的表示,应当由它和邻居们的信息共同决定——这就是"邻居聚合",也叫消息传递。
图 6-5 从固定网格卷积到邻居聚合
消息传递:一层的灵魂
一层 GNN 大致这样走:
- 每个节点把自己的"消息"发给邻居(带上当前表示)
- 每条边上的权重决定这条消息的分量(可以学出来)
- 节点收到所有邻居的消息,加上自己的表示,一起聚合、过个非线性变换,得到新表示
多叠几层,消息就能沿着边传得更远,节点它也就"看见"两跳、三跳以外的信息。这和第 3 章的"卷积核越大看得越广"是对位的关系,不过这里看多远由多层堆叠决定,而不是由一个核的大小决定。
图卷积写成一行
图卷积常用的写法是:一个节点的新表示 = 一个可学权重 × 它自己 + 邻接权重加权过的邻居之和,再过一个归一化和非线性。看起来和 CNN 很像,但关键差别是卷积核的作用对象换成了一组不固定的邻居,邻接结构来自图本身。也正因为结构来自图,GNN 对"换张图、节点顺序打乱"是稳定的——这是图数据最看重的性质。
它用在哪里
只要数据是"节点 + 边"的结构,GNN 就大有用武之地:
- 分子与材料:原子是节点、化学键是边,预测性质、找新分子
- 社交与推荐:用户/物品节点、互动边,做链路预测与推荐
- 知识图谱与推理:实体节点、关系边,做补全与问答
- 物理与交通:路网、粒子系统,做动力学与流量预测
图网络与主线
对主线而言,GNN 在回答"结构先验怎么融入归纳"这个问题——CNN 用网格的先验,注意力用自适应的权重,图网络用显式的图结构。它常和 Transformer 搭配(图注意力网络就是一个方向),也是深度学习中结构建模的一环。基础设施没变,只是在哪聚合、按谁聚合换了规则。
叠太深会遇上"过平滑"
GNN 也有自己的病:层数堆到很多时,每个节点不断聚合邻居、而邻居又来自更广的范围,大家的表示会逐渐趋同、彼此几乎分不开——这叫过平滑。这和第 3 章"深了更好"并不矛盾:CNN 的深是加信息,GNN 的深却常常等于信息被平均掉。所以 GNN 的层数通常不深,越深越要配上残差、跳连这类手段,防止表示糊成一片。这是理解"为什么 GNN 很少做成百层"的关键。
一张图上的局部与全局
GNN 的聚合是"局部"的——每个节点只跟直接邻居交换消息,想"看见"两跳外的信息得靠多层堆叠。这带来一个现实约束:一个节点的最终表示,严格取决于它几跳以内能覆盖的子图,太远就够不着。于是在图上做"整图分类"这类任务时,会看到全局池化、图级读出(把全图所有节点表示汇总成一个图表示)等设计。抓住"局部聚合 + 全局读出"这一对,你就会看懂很多 GNN 架构为什么两端都在做文章。
为什么"换张图、打乱节点"还能稳定
这是 GNN 特有的宝贵性质。卷积网络靠固定网格,GNN 的聚合完全由边(相邻关系)决定,跟节点编号、排列顺序无关。同一个分子,原子编号怎么排都一样,GNN 的输出保持不变。所有想用 GNN 的人,最先相中的往往就是这点结构性的不变性。理解它,你就明白为什么 GNN 能塞进"分子性质预测"这类编号可以随意变的科学任务里。
边还能带"种类与权重"
不只是节点有特征,边也常常携带信息:化学键分单键双键、分子间有作用力强弱、社交网络有关系亲疏。GNN 常把这些编码成"边特征",聚合时让不同边的消息按各自特征加权。这一步让 GNN 远比"只聚合节点特征"灵活,也是它在分子、知识图谱里表现好的原因之一。
从"网格"到"图",是归纳的解放
第 3 章卷积把"规则网格"当先验,第 5 章注意力把"相关性"当动词,本章 GNN 则把"图结构"自带进归纳——它不固定窗口,而是让结构自己说话。放眼一看,很多领域本来就是图:社交、分子、路网、代码依赖。所以 GNN 的价值,很大程度在于"给一大堆把结构藏在边里的数据,找到了一种匹配的骨架"。
聚合之后还要一个"读出"
讲完层的聚合,还有一层常被低估的"读出"。做"整图分类/回归"(比如预测一个分子有没有药性,或整个社交网络的密度)时,要把所有节点表示汇总成一个整图表示。常见的有求和、平均、最大池化,也有更高级的图级注意力。抓住"层的聚合(点与点之间)+ 图级读出(全图到一数)"这个两段式,几乎所有 GNN 应用的接法都能看懂。
一张图记住 GNN
如果想用一张图记住 GNN,就记四个字:邻居决定我。多层之后,这个"邻居"的半径会逐渐扩大,但一条消息始终只在相邻节点之间显式传递——这就是它与全连接、与卷积最本质的分界,也是它处理分子、社交这类"边即结构"的数据时的天然优势。往后的图注意力、异构图,全都踩在这四个字的地基上。
本节要点回顾
- 图 vs 图像:节点数邻居数不固定、无全局顺序,网格卷积不称手
- 邻居聚合 / 消息传递:节点的表示由自己和邻居共同决定
- 图卷积:可学权重 × 自己 + 邻居加权,按边聚合、归一化 + 非线性
- 多层:看得更远,结构来自图、对节点打乱稳定
- 场景:分子、社交推荐、知识图谱、物理交通
- 主线:把结构归纳从网格换成显式图结构,基础设施仍是反向传播