6.3 深度强化学习
6.3 深度强化学习
本节摘要:监督学习需要带标签的数据,强化学习却从"试探 + 奖赏"里自己长出策略。本节讲清智能体、环境、状态、动作、奖励这套框架,点出策略梯度与价值函数两条打法,再说为什么训练更贵、更会震荡,最后把它摆回主线。
前几章(包括 6.1、6.2 的生成)都需要一个目标答案来判断好坏。强化学习(RL)把这一套抛到一边:没有谁告诉你"这一步该按哪个键",只有环境在你做对时给奖励、做错时不给。模型要从一次次试错里,自己摸索出"什么情境下做什么动作能累计最多奖励"。
一套试错的走法
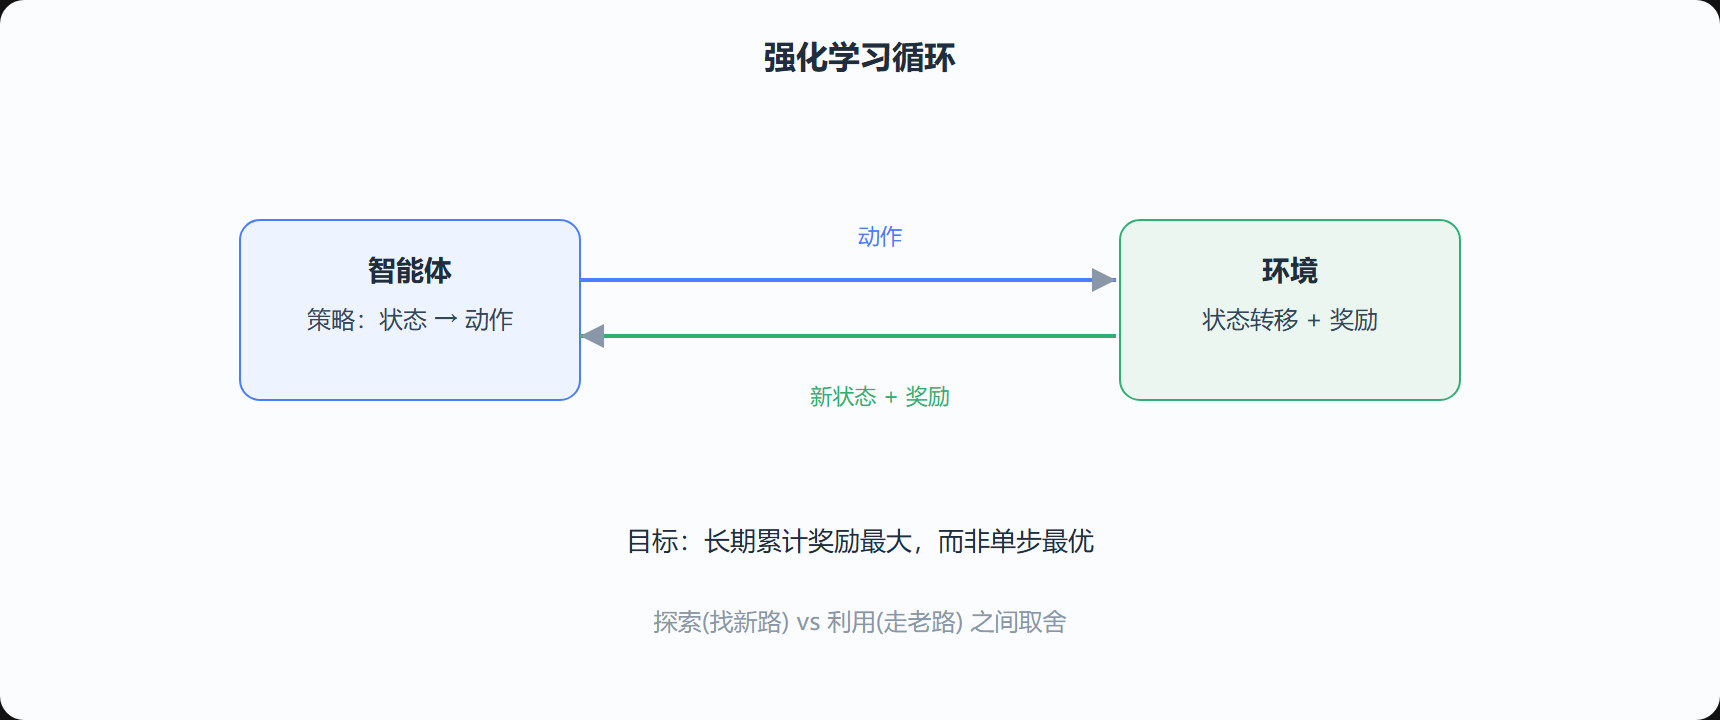
搭一个最小的局面:一个智能体在环境里,每步观察到当前状态,选出动作,环境回应新状态并给一个奖励。目标不是让某一步的奖励最大,而是让长期累计奖励最大。这里有个著名的取舍——探索 vs 利用:光利用已知的拿分路子会错过更好的新路子,光探索又总在捡芝麻。学习要在这两者间找平衡。
图 6-4 智能体与环境循环
两条主流打法
深度强化学习用神经网络来逼近 RL 里的部件,主流分两派:
- 策略梯度:直接让策略网络输出"该选哪个动作"的概率,反向传播时往奖励高的方向调整动作概率。简单直接,适合连续或不规则的动作空间,但方差大、更新波动猛。
- 价值函数(Q 学习):学一个"在状态 s 采取动作 a 的长期回报预期"——Q 值。决策时就挑 Q 值最大的动作。它把估价当目标,奖惩信号更稳。
其实两者往往结合(Actor–Critic:演员学策略、评论家学价值),用价值网络压低策略梯度的方差。工程里很常见,是 RL 里的"双剑合璧"。
为什么 RL 更贵、更容易翻车
RL 和前面的监督学习有几个根本不同:
- 没有现成数据集:样本靠智能体自己在环境里跑出来,跑一天就够烧,成本高且环境往往不可回放重演。
- 奖励稀疏且延迟:很多时候跑完一整局才能拿到一次奖励,梯度信号又慢又稀薄,模型不知道是哪一步做对。
- 非平稳:策略一变,之后看到的"状态分布"跟着变,学习的"标靶"自己在动,容易来回震荡。
所以 RL 特别看重"稳定与多样性的平衡",也常用回放缓冲、目标网络、奖赏归一化等手法——本质还是那句老话:让梯度不被延迟又稀疏的奖励带得乱撞。
RL 在主线上的位置
RL 与前面章节的关系是"换了监督来源而不是换引擎":同一套反向传播,只是损失变成了"对长期奖励的估计偏差",而不是标签差。也正因为如此,它常常与 CNN/Transformer 搭配(视觉观察、策略近端优化用大模型表示),在游戏、机器人、推荐这类"行动才有反馈"的问题上大放异彩。
一局只给一个奖,模型怎么知道错在哪一步
RL 有个经典难题叫信用分配:一场对局漫长,最终成败只给一个总奖励,模型很难判断"到底是第 30 步那记妙招、还是第 5 步那下失误决定了结局"。于是 RL 往往把长期回报一层层"回退"给中间的状态——价值函数干的正是在这件事:它估计"处在当前状态,往后的长期回报大约是多少",把遥远的成败折现回每一个当下。理解了信用分配,你就明白 RL 为什么比监督学习难:标签在最后一刻才诞生,而且摆不到中间的每一步上。
策略梯度的方差为何高
策略梯度的更新是用一次抽样回报去推动作概率的:这一局运气好、奖励高,就把这局的动作概率往上抬;运气差就往下压。问题在于单局抽样的波动极大——同一策略跑十局,奖励可能从 10 跳到 100,更新方向的方差被带得很猛。所以才有各种降方差手段:用价值函数做基线、优势函数、旧策略与新策略的比值裁剪等等。它们并不改变思想的骨架,只是让"这根本来就抖的指针"画得更稳一些。理解这一点,是看懂各种强化算法改进的钥匙。
奖励设计是一半学问
RL 里常被低估的是"奖励怎么写"。奖励太稀疏,智能体在巨大状态空间里基本学不到;奖励太密或写得歪,又会让它学会钻空子——在奖励函数的缝里取巧,而不是真正完成任务。所以工程上会做奖励塑形、给稀疏奖励补中间信号,有时甚至用学习到的奖赏模型来替代人手设计。理解"奖励即监督"这一点,你就抓住了 RL 比监督学习更"内向"的那一面。
采样-评估-学习的闭环为什么贵
监督学习一轮能吃进整批标签;RL 却没有现成标签,每一步都要"真的去走一局"才有回报样本。跑完一局才知道成功与否,累起来训练成本便远高于同等体量的监督学习。加上环境通常不可回放、每次策略一变看到的分布就变,RL 想"稳妥地复现一个结果"尤其费力。这也是很多 RL 成果人力与算力账单惊人的原因。
稳定训练的三件套
RL 常见的三个稳定器:回放缓冲(把过去样本存起来、打散相关性)、目标网络(用一个"慢更新"的版本自拟长期回报、防更新抖动)、奖励归一化(把不同量级的奖励拉回同一尺度)。它们不改变 RL 的思想骨架,只是让"难驯服的梯度"在一个工程框架里待得更稳。想快速补这块常识,把这三件套各自解决什么问题记住即可。
状态空间大,正是深度网络进来的理由
一旦状态空间大到像围棋、像机器人那么多自由度的关节,查表式的旧 RL 立刻失灵;深度学习正是因为能对"海量状态 → 动作价值"做泛化逼近才登上台面。这就告诉你 6.3 标题里的"深度"不是点缀——压在它后面的是"状态空间太大,只能靠表示学习去泛化"这个现实约束。
一句话给 RL 定位
用一句话给 RL 定位:它不是一套新引擎,而是把"监督"两个字换成"互动奖赏"的同一台反向传播。以后遇到 DQN、PPO、SAC 一堆缩写先别慌——心里默念一句"它的损失是对长期奖励的估计差、梯度朝奖赏高的分布走",多半就能跟上去。带着这个定位去读任何强化算法,都会比死记一堆公式轻松许多。
本节要点回顾
- 四要素:智能体、环境、状态、动作,奖励驱动长期目标
- 探索 vs 利用:平衡找新路与走老路
- 两派打法:策略梯度直接调动作概率,价值函数估长期回报,常用 Actor–Critic 合流
- 三大难处:无数据集、奖励稀疏延迟、学习标靶非平稳
- 主线:还是反向传播,只是损失换成长期奖励的估计偏差