7.1 框架与数据准备
7.1 框架与数据准备
本节摘要:好模型的一半秘密在数据与工程习惯里。本节讲选框架、建环境、管随机的规范,再展开数据的清洗、增强与划分,最后点出最隐蔽的坑——数据泄漏怎么来的、怎么防。
落到一个真实项目,最先接手的往往不是模型,而是环境与数据。框架选顺手、随机数管得住、数据喂得干净,后面调模型才谈得上"可复现、可比对"。很多人把大量时间花在数据工程上,就是因为模型再强,也救不了一泡坏数据。
框架与环境:把道理落到工具
如今主流的深度学习框架各有侧重,但共性是"自动求导 + 张量 + 训练环"。选择上不必纠结谁高级,关键是三件事:生态顺不顺手、跑得快不快、好上线不好上线。环境里更要紧的是纪律:
- 固定随机种子,让结果可复现;GPU 的多数库结果本身是确定性的,乱飞多半是没锁种子
- 管理好依赖版本,模型换个环境跑不出同样的数字,大多是版本漂移
- 用统一的实验记录(配置、指标、权重一起留档),不然回头根本不知道哪个版本怎么跑出来的
一句话:把"换台机器结果也得一样"当成底线,而不是玄学。
数据清洗:脏在哪,坑在哪
模型只在你看得见的数据上学。常见脏点:
- 缺失值:删、填均值、还是用模型补,取决于多少、有没有规律
- 异常值与噪声:手滑的标签、错位的字段,往往会悄悄把模型带偏
- 类别不平衡:正负样本悬殊,模型干脆全猜多数类,要看 F1、召回而不是只看准确率
清洗时最忌讳的是"凭感觉删数据"。每删一批,都应问一句:这跟要解决的问题是噪声还是真信号?删错了,模型学到的分布就假了一截。
数据增强与划分
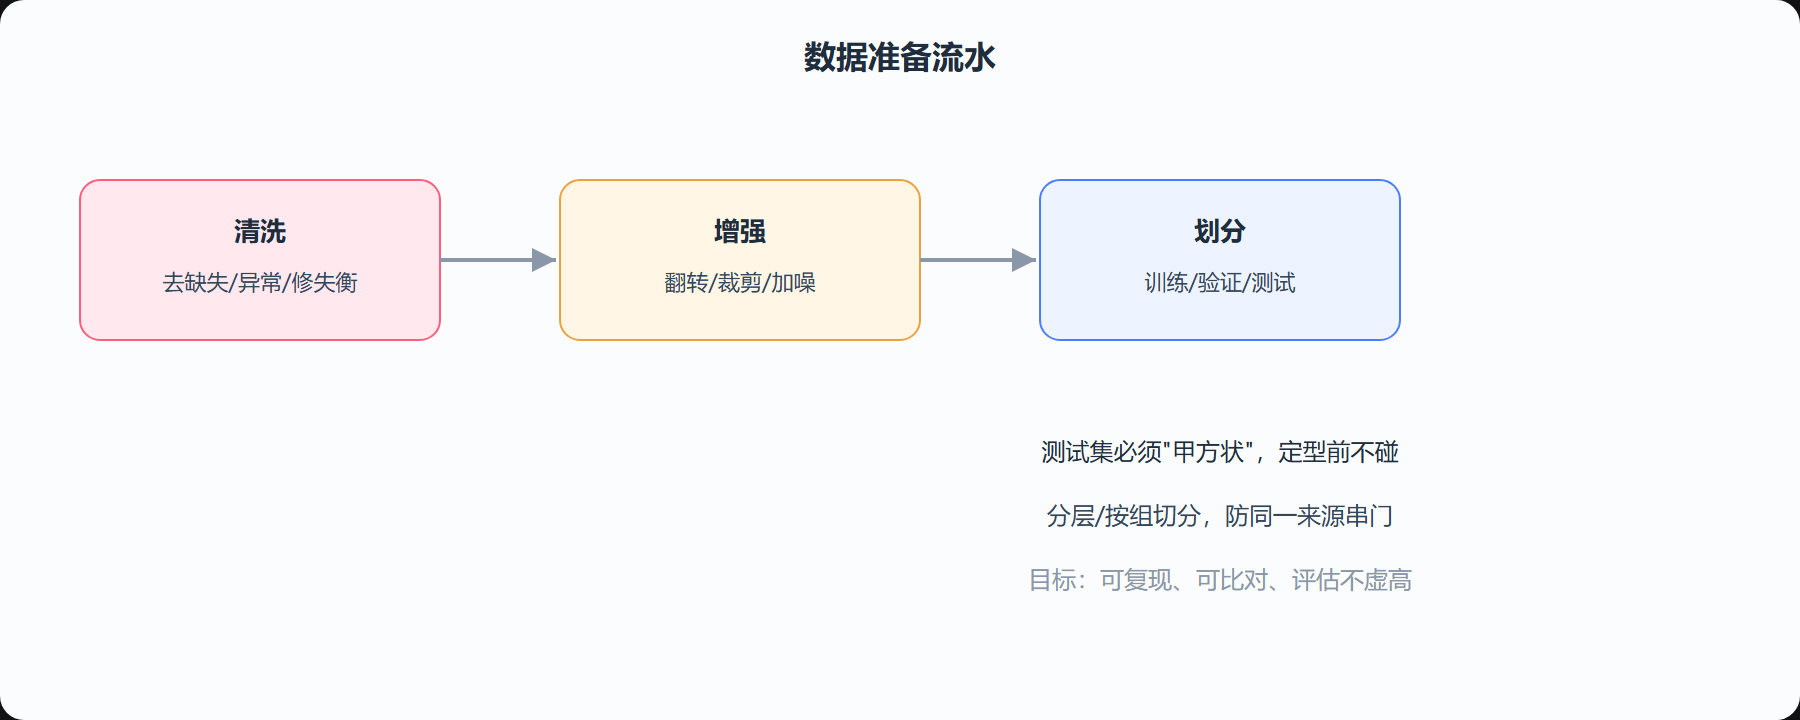
数据不够、或期望模型更鲁棒时,数据增强是既便宜又好用的办法:图像翻转旋转裁剪、文本同义替换、加轻微噪声。它的本质是给模型注入"这类变化不该改变答案"的先验,扩大有效样本量。
划分则要守住纪律:训练/验证/测试要有代表性,而且测试集必须保持"甲方状"——在全部调参定型前绝不碰。规范的划分讲究分层或按组切分,避免同一来源的样本"串门"导致评估虚高。
图 7-1 数据流水:清洗 → 增强 → 划分
数据泄漏:最烫手的暗坑
数据泄漏是指测试阶段的信息偷偷溜进训练,让评估虚高横行。常见情形:整体归一化的均值方差在划分前就用了整个数据集算、去重后还保留了同源样本、或者时间序列里未来数据混进过去。危害在于它会制造一种"模型神准"的假象,一上线原形毕露。
防泄漏的底线动作:先划分、再处理——所有的归一化、统计都只用训练集计算;做去重时把验证/测试先隔离;时序任务按时间切分而不是随机切分。
一份拿来即用的项目复盘清单
把 7.1 落成一张能常驻心间的清单:环境上,锁随机种子、固定依赖版本、每次实验留档(配置 / 指标 / 权重 / 数据版本);数据上,先审视来源与分布,再洗缺失、异常、类不平衡,按任务决定增强方式,把训练 / 验证 / 测试"三分天下"且绝不让测试提前进场;最后,在所有统计操作(归一化、去重、时间切分)之前先画好分割线。真把这些做到位,你会发现多数"复现不出"都源于环境漂移或数据泄漏这类小事,而不是模型本身。
增强也要贴着语义选
数据增强那句"变化不改答案"很好记:旋一张猫的图,它还是猫;把"非常好"同义替换成"极其棒",情感不变。增强帮模型学到"这些看似不同的输入底下是同一件事",从而挤出更多有效样本。但别什么都增——旋转适合不需要方向的任务,手写数字倒过来连人都难认,硬增只会添乱。所以增强要贴着任务语义去选,而不是无脑堆花样。这条小原则,和 3.3 那种图像增强的做法是一脉相承的。
一组反常识的"脏证据"
先说个反常识:很多"看起来很强"的模型,成绩其实来自数据泄漏造成的假象。最常见的三种——归一化的统计量用了整个数据集、去重时把验证集与训练集的同源样本一起去了、时序任务里把未来数据混进了历史。它们都不会在训练时报错,只在线上默默露馅。所以 7.1 花大量篇幅讲"先划分再处理",不是小题大做,而是每一条都对应一种真实发生过的翻车现场。
为什么随机种子值得锁一个
同样的代码,换个随机种子、换个 GPU、换个批次顺序,结果都可能上下浮动。工程上锁种子、固定依赖版本,是为了让"这次实验的差别到底是改动策略来的、还是纯随机来的"能够被区分开。不锁种子的结果,往往是几个实验的差异淹没在噪声里,根本无法判断哪个配置更好。锁定随机性,本质是给"对比实验"买到一根公平的基线。
一句贯穿三节的工作观
把 7.1 的标题翻译成一句话:数据与工程纪律,才是模型上限之外的第一道护栏。结构调得再花,数据脏、流程散、随机乱,都救不回来。带着这句话走完 7.2(迁移)和 7.3(上线),你会发现整章都在讲同一件事——让"好算法"在一个可信、可复现、可负责的底盘上落地。
清洗的尺度感:干净到够用就行
补一笔数据清洗的尺度感:清洗的目标不是把数据"洗到极致",而是让"数据的分布贴近你要解决的现实问题"。很多时候,一个直接又省事的基线是把异常值、缺失、类别失衡各看一眼,而不是把海量时间花在追求一份完美数据集上——过度清洗反而可能把真信号一并删掉。这条分寸的拿捏,正是数据工程里最体现经验的地方。
一种最隐蔽的泄漏:"未来的信息"
还有一种很隐蔽的泄漏是怎么都防不胜防的——用了"未来才有的信息"。比如训练时就用了测试时段才能拿到的整体统计,或特征工程里引入了由标签衍生出来的量。凡是在上线那一刻"手上还没有的输入",却在训练阶段被用到了,都算泄漏。识别它的办法很简单:想象自己站在上线那一刻,只有当时的输入,能不能复现这一次处理;不能,就把它挪到划分之后再做。
本节要点回顾
- 环境纪律:锁随机种子、管依赖、留实验记录,结果可复现是底线
- 清洗:缺值、异常、不平衡对症处理,别凭感觉删数据
- 增强:注入"变化不改答案"的先验,扩样本、促鲁棒
- 划分:测试集"甲方状",分层/按组切分
- 防泄漏:先划分再处理,所有统计只用训练集,时间去重防未来混入