7.2 迁移学习与微调
7.2 迁移学习与微调
本节摘要:自己从零训一个大模型又贵又久,迁移学习让你把别人在巨量数据上学好的权重借过来,只在自己小数据上做少量调整。本节讲为什么有效、冻结与微调的拿捏,以及何时该保持谨慎——也为第 5 章"预训练 + 微调"在这里做一次工程落地。
5.4 讲过"预训练 + 微调"是 NLP 的大趋势,其实这在视觉、语音早已是主流做法。核心理由一句话:在一张大数据上学到的东西,往往换到关联的小任务上也值钱。让模型清空重来是浪费,不如带着"底子"快跑。
为什么能"借"别人学的东西
网络前几层学的是更通用、更低级的特征——视觉里是边缘、色块、纹理,语言里是字词组成方式;越往后越接近具体任务。所以当新任务和训练时的任务同源时,前几层依然管用,只有最后偏任务的层需要重新调。这就是迁移学习的甜头所在:通用能力被保留,专有能力被替换。
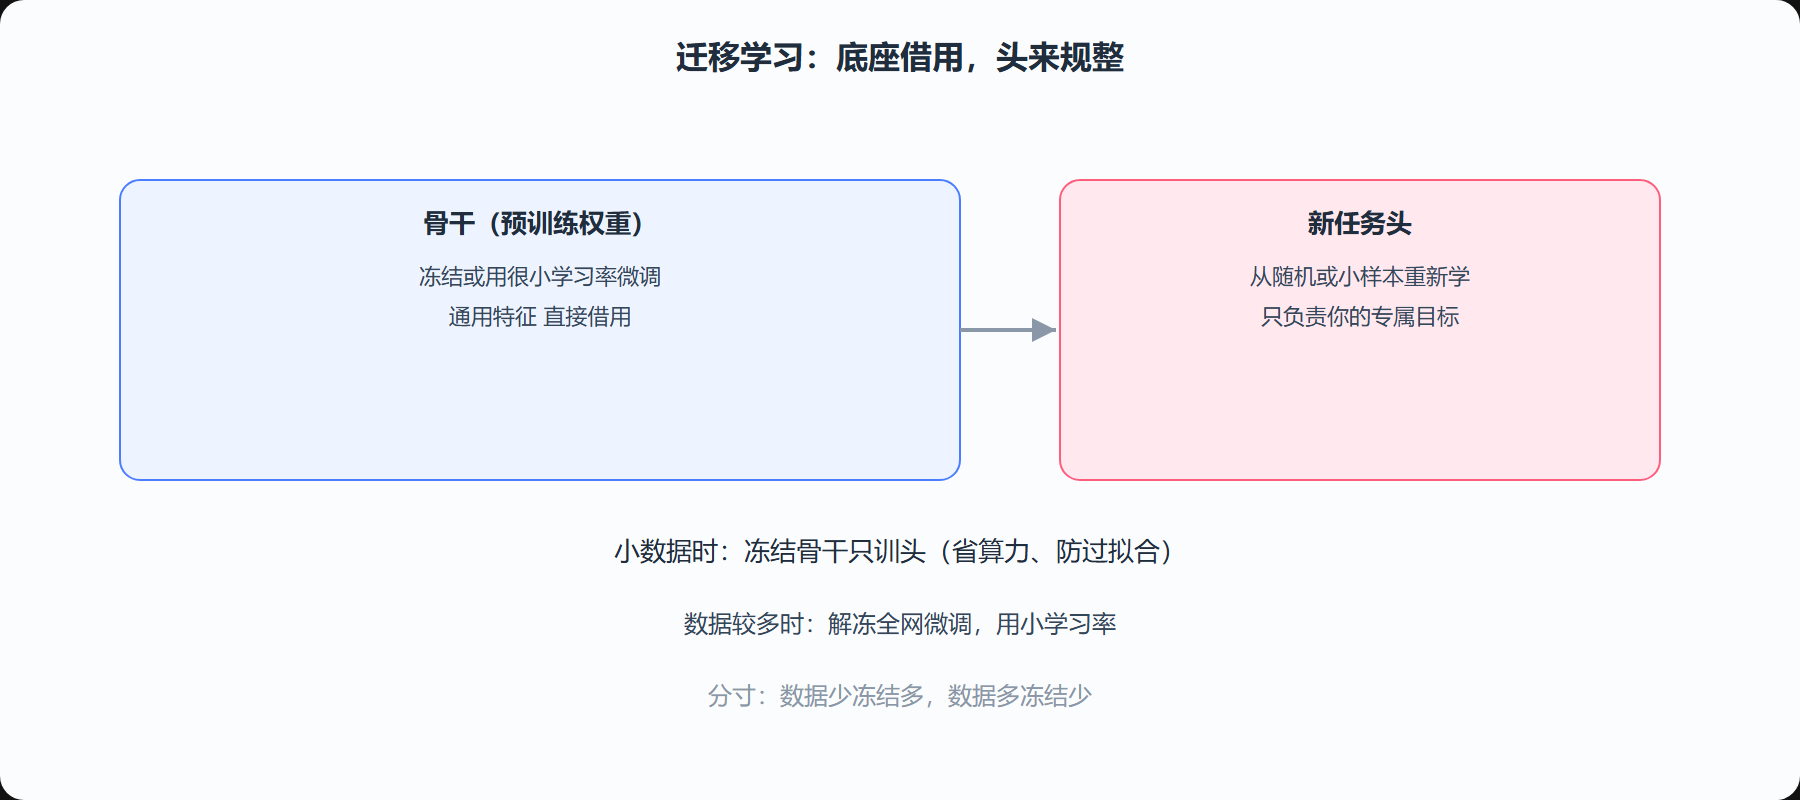
图 7-2 冻结与微调的分工
冻结还是微调:拿捏分寸
具体怎么用,取决于你有多少数据、以及新任务和预训练任务有多像:
- 数据很少:把骨干冻结(不更新),只训练最后的任务头。最常见做法,既省算力又防在小数据上把底子带偏。
- 数据中等偏多:解冻部分靠近任务头的层,让它们随数据微调。
- 数据很多:整网以很小的学习率微调,能更好地贴合新分布。
那"多大算大、多像算像"没有死清单,靠的是先冻结后逐步松开、用验证集盯着是否过拟合的实验方法。关键纪律是:给大模型的微调学习率要比从头训小几个量级——毕竟它已经站得很接近好位置了,梯度轻轻碰一下即可。
别一股脑借的几种情况
迁移学习也不是万能药。要注意:
- 预训练数据和你的任务分布差异太大(比如天气营销图片却用自然图像预训练),借的底子可能帮倒忙
- 领域特殊性很强(医学、工业数据)时,从头训或领域预训练可能更划算
- 用户说"直接白嫖别人的模型"时,别忘版权、合规与数据隐私这档子事
一句话,迁移学习的取舍本质是用"多大算力 + 多像的底子"换"多好的上线效果"——第 5 章预训练给全行业攒了底子,本节教你怎么花得值。
最便宜的判断:任务有多像
用不用迁移、能不能借别人的底子,最省事的判断是问:你的任务和它预训练时面对的是不是同一个"视觉 / 语言世界"。图像分类的骨干借给任何"看图懂常识"的任务都划算;可若你的数据是点云、医学切片这种和自然图像迥异的领域,硬借反而要网络先忘掉一堆没用的先验。实务把"同源度"当成一个小实验:先冻结跑一版看验证集,再逐步松开对比,用数据说话,而不是拍脑袋。
微调不是再一次"从头训"
微调不是简单的重训,它从已经停在好位置的权重起步,所以学习率要小几个量级,生怕一步踢歪;它也常配合分层学习率——越接近任务头的层给大一点的幅度,越靠前的通用层几乎不动。这些细节共同决定了微调是"轻轻地拨正",而不是"再来一轮轰轰烈烈的训练"。写代码时要把"哪些层冻结、哪些层用多大学习率"显式地表达出来,否则一不留神,辛苦迁来的底子就被一次大更新冲掉了。
一条反直觉却正确的收益曲线
迁移学习的收益,恰恰在小数据上最丰厚:数据越少,越无力从零训出稳定模型,借底子的价值越突出;数据一大,从头训也能逼近甚至反超,迁移的红利就被稀释。所以"数据少多依赖迁移、数据多少依赖迁移"是一句反直觉却正确的主线。想通这条曲线,你就不会在小数据上硬撑大模型,也不会在多数据时还死抱着迁移不放。
预训练权重到底压了什么
预训练权重之所以值钱,因为它把"一份海量任务里的常识"高度浓缩在少数参数里。你随手上线一个小任务,往往没有足够的样本去练出这份常识,直接从头训等于要从小样本里重新长出"世界怎么写"的直觉,当然吃力。迁移要做的,就是"把这份浓缩的常识挪过来 + 花小数据把末节拨正",两头都省。
一个"什么时候别信迁移"的检查
见到这三种情况,先按住想直接迁移的手:你的数据和预训练相差极大(医学切片 vs 自然图)、你的任务需要极强的领域特定(行业黑话远比通用语料重要)、以及你其实拿不到一张已经训干净的可靠权重。它们不意味着迁移一定失败,但意味着"借底子"这条懒路可能不如"专用训练"划算。每一条,都对应实务里有人踩过的坑。
知识蒸馏为什么总被一起提起
想在上线时把大模型"浓缩"成小模型,有个兄弟手段叫知识蒸馏:让小模型去拟合大模型输出的软概率,而不是盯死硬标签。它和迁移常被一起说起,但分工不同——迁移是"借一个大底子",蒸馏是"压出一个小体积"。工程上常常先做迁移(拿大的顺手),上线前再做蒸馏(变小省资源),两者合起来才是一条完整的落地链路。
该冻哪些层:前冻后放
一个常被新手问起的细节是微调时该冻结哪些层。经验法则是"越靠前越通用、越该冻结,越靠后越任务相关、越该解冻"——图像骨干的前几层学的是边缘色块,与具体任务关系弱,冻结它们既省算力又防止小数据干扰;靠任务头的层才需要放开去贴合你的目标。这条"前冻后放"的梯度,是迁移学习里最实用的一条操作口诀。
警惕"迁移答辩"式的自我感动
别让"借了预训练权重"这件事本身给你一种踏实感。如果换上权重后跑出的成绩还不如从头训,先别怀疑实现——回到"同源度"和"数据量"这两个变量上检查,是不是你的场景本就不适合借那个底子。判断迁移值不值,永远用"借了是否真的更好"这个实地对照来下结论,而不是心理上的安心。
迁移的主线意义
最后把迁移放回主线:它最大的贡献,是让"梯度不必总是从零开始"。过去每个任务都要从随机初始化把知识重新学一遍,迁移让模型站在一个很高的好起点上轻装上阵,只花一点训练量把末节拨正。这在算力与数据的双重约束下,几乎重塑了整个深度学习的推进效率——这也是为什么预训练-迁移-微调,会变成当下几乎所有模型的标准打开方式。
本节要点回顾
- 为什么有效:前几层是通用特征,可跨任务复用,只需换任务头
- 三种用法:冻结骨干只训头、松开部分层、整网小学习率微调
- 微调学习率:比从头训小几个量级,轻碰即到位
- 底线:数据少冻结多、数据多冻结少,用验证集盯着过拟合
- 别乱借:分布差异太大 / 领域特殊 / 合规数据隐私需谨慎