7.3 部署、可解释与伦理
7.3 部署、可解释与伦理
本节摘要:模型终于训好了,但"能用"到"送到用户手里又能扛得住",中间还隔着部署、可解释与伦理这三关。本节讲上线要权衡吞吐延迟内存量化、模型怎么被看见(可解释),以及公平隐私透明如何在工程里落地——收束全书"从看见梯度到负责任地送它上线"的主线。
前面几节把模型养大,本节处理它"离校上山"的问题。一个模型能否真的产生价值,决定因素往往不在训练指标,而在这三样不起眼却致命的东西:跑不跑得动、讲不讲得清、敢不敢担责。
部署:从实验到服务的三个瓶颈
训练追求"练得准",上线追求"跑得快、扛得住"。三个硬指标要提前权衡:
- 吞吐与延迟:延迟是单次请求到出结果的时间,吞吐是每秒能处理多少请求。两者互相抬杠——堆并行提吞吐,往往要拿延迟当代价。
- 内存与显存:模型参数、中间激活都吃显存;换更小的模型、用半精度,能腾出空间。
- 模型量化:把权重从 32 位压到 8 位甚至更低,速度飞涨、体积大减,代价通常是精度略有损失。对显存小、走边缘设备的场景是常客手段。
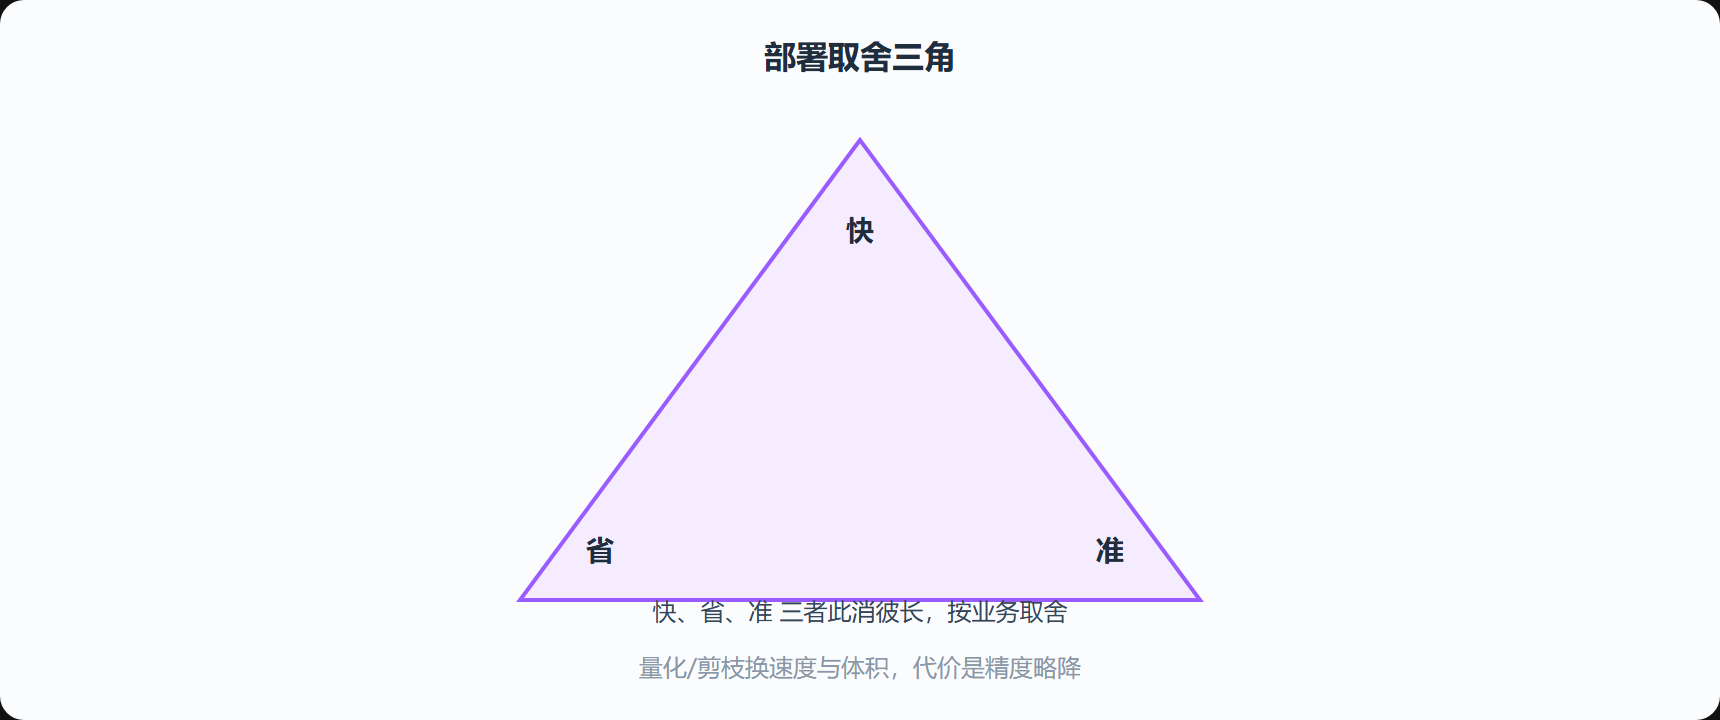
常见的上线路径:原样推理服务、或在部署前做量化/剪枝/蒸馏来瘦身。到底是"最快上线"还是"最省资源",要由业务来定,而不是由模型说了算。
图 7-3 部署的三条取舍
可解释:让模型"被看见"
模型给结论却不给理由,很难被信任。可解释性分两个方向:
- 事后解释:不拆开模型,只观察"输入怎么变、输出怎么动"——如用梯度/注意力权重看哪些特征关键、用 LIME / SHAP 这种近似方法给单个样本讲道理。
- 透明设计:先把模型做成好读的样子(如线性、浅决策树),或用注意力图、特征可视化这类结构自带的可视化。
真做起来要清楚:完全彻底的解释对深度模型常常不存在,工程里追求的是"够用的解释"——能说明主要依据、异常行为为何发生即可。而且它和主线也挂钩:前面所有章节的注意力图、梯度热图,本质都是同一件事——看看模型把梯度/注意力放在哪里。
伦理:能用,不等于该用
训练好的模型上线到真实世界,会撞到三个绕不开的责任:
- 偏见与公平:训练数据里带的历史偏差会被模型放大,用户画像、招聘、审批这些场景可能造成不公;要做的是拆指标、审计在不同群体上表现是否一致。
- 隐私:模型可能记住并泄露训练数据里的敏感信息;本地脱敏、差分隐私、数据最小化是常用防线。
- 透明与责任:无论模型是否给解释,出的错最终要有人担责;要明确边界、留审计日志、设闸限流。
一句话:AI 的成熟最后体现在"负责任"——不是能不能做到,而是愿不愿意为它兜底。这也正是本书末章最想让你记住的。
从梯度到负责任:全书闭环
如果把整本书串起来看,主线是"让梯度以更稳、更省、更远的路径穿过网络",而走到 7.3,这条主线的最后一公里不再是梯度本身,而是让梯度带出来的模型能被信任、被使用、被担责。测得出、讲得清、担得起——模型长路到此才算真正走完。
可解释是"够用即止",不是"全懂"
深度模型本质上是黑箱,"从第一个输入到最后一个输出为什么这么走"往往没有一个简洁答案。7.3 想纠正的正是这种"要百分之百解释"的执念:工程里追求的是"够用的解释"——能说明模型主要依据什么、某个异常行为大概因何而来、边界在哪。注意力图、梯度热图、LIME / SHAP 近似,都是在黑箱边上打几扇观察窗,而不是把箱子拆成零件。想明白"够用"二字,才不会在路上被"不可解释"吓退,也不会为了求全懂而不计成本。
三大原则背后,其实是一句人话
偏见公平、隐私、透明责任,听起来像合规部门的术语,落到模型开发者其实就是三句很朴素的话:怕你在性别、地域上不公平,就拆开按群体分别测;怕模型把敏感信息背出来,就脱敏、最小化、差分隐私;怕没人能对错误负责,就留审计日志、设闸限流、把边界写清楚。它们不是模型的数学,而是把数学产品化之后、愿意为它兜底的那一层取舍。
部署时"量化"最容易被低估
8 位甚至 4 位的量化,能把模型体积和推理时延同时砍下一大截,对边缘、手机场景几乎是刚需。误区是以为量化必然掉精度——现代的量化感知训练把误差控制得相当好,很多场景下精度几乎无损。理解量化是"精度与速度的交易"、但并不总是非此即彼的两难,能帮你把资源账算得更清。
上线的最后一里,监控比训练更磨人
模型上线后真正决定口碑的,往往不是训练时的指标,而是线上请求分布的变化——数据一漂移,曾经很准的模型很快变钝。所以成熟团队会盯"输入分布漂移、单样本极端值、峰值吞吐与延迟",而不是只看一个平均延迟。这一层的功夫,常被"模型很准"的表面成绩盖过,却最决定线上体验。
可解释里最容易起争议的"忠实度"
人人都想要"又准又能解释",但深度模型的解释通常只在局部成立。所谓"足够好的解释",是能说明主要依据、指出异常行为的来源、并把边界说清楚,而不是给出一个覆盖全样本的唯一因果链。把预期从"全懂"降到"够用",既避免掉坑,也避免为了求全而搭出昂贵的绕过方案。
伦理落地不靠口号靠制度
公平、隐私、透明要真正落地,靠的往往是一套工程制度:上线前的偏见审计、样本的分组评测表、数据最小化清单,以及出事故时的责任链与回滚预案。它们不产生新参数,却决定了一个产品敢不敢让模型在上线后继续运行。想通这一点,你会发现 7.3 的"伦理"不是题外话,而是模型工程师的分内事。
它们其实都指向同一个词
如果你把这章读到这里,会发现部署、可解释与伦理都指向同一个词:责任。它们不是训练之后的三个补丁,而是把一个"能算准的算法"变成"可交付、可托付的系统"所必需的三个侧面,恰好也是全书把梯度主线带向落地与担当的终点。测得出、讲得清、担得起,正是对"梯度终于变成产品"这句主线的最后回应。
本节要点回顾
- 部署三瓶颈:延迟/吞吐互杠、内存显存吃紧、量化换速度与体积
- 常见瘦身:量化、剪枝、蒸馏,按业务取舍"快省准"
- 可解释两路:事后近似(LIME/SHAP)与透明设计,追求"够用的解释"
- 伦理三关:偏见公平、隐私、透明责任,审计与脱敏防患于未然
- 全书闭环:主线最后一段是让模型被信任、被使用、被担责