1.1 一场酒馆赌局催生的模型:GAN 的定义与发展
1.1 一场酒馆赌局催生的模型:GAN 的定义与发展
生成对抗网络(GAN)是一种生成模型:生成器网络把随机噪声映射成样本,判别器网络学习区分真样本与假样本,二者以对抗方式联合训练,最终生成分布逼近真实数据分布。 本节交代这场博弈的起源、定义句的准确含义,以及从 2014 年开局到风格生成霸榜十年间的关键节点。
承接全册导读的约定,本节是博弈室开卷第一案:先认人,再讲规则(第 2 章),最后看工艺(第 3 章)。读完本节,你应当能用一句话向外行解释 GAN,并能说出"生成式建模的两条路"中对抗训练占了哪一条。
起源:一个被朋友激出来的想法
2014 年,蒙特利尔的 Ian Goodfellow 在一家酒馆听朋友讨论"让机器自己生成照片"的方案,越听越觉得不对——那套方案基于统计推断,复杂得离谱。他当晚回家写了第一版 GAN:一个网络造假,另一个网络鉴别。传说这第一版代码当晚就跑出了能辨认的手写数字。传说有演绎成分,但论文本身确凿:2014 年发表的《Generative Adversarial Nets》提出了极小极大目标,给整个领域立了开场锣。
要理解这个想法新在哪,得先看生成式建模的两条路。
第一条路是显式建模:写出概率密度函数 p(x),最大化对数似然。玻尔兹曼机、变分自编码器(VAE)走的是这条路或其变体。好处是能算似然,坏处是密度函数难写、难算,生成的样本往往偏糊。
第二条路是隐式建模:不写密度,只要求"从这个模型采样出来的东西像真样本"。GAN 走的是这条路。怎么逼它像?请一个判别器当"像不像"的裁判,裁判的水平随对抗而涨,生成器被逼着跟上。
这个设定有个漂亮的经济学解释:造假者不需要懂美术史,只需要过得了眼前这位鉴定师;鉴定师也不需要懂艺术理论,只需要分得清真伪。两个"半吊子"互相较劲,整体系统却收敛到高度写实——这就是对抗的杠杆效应。
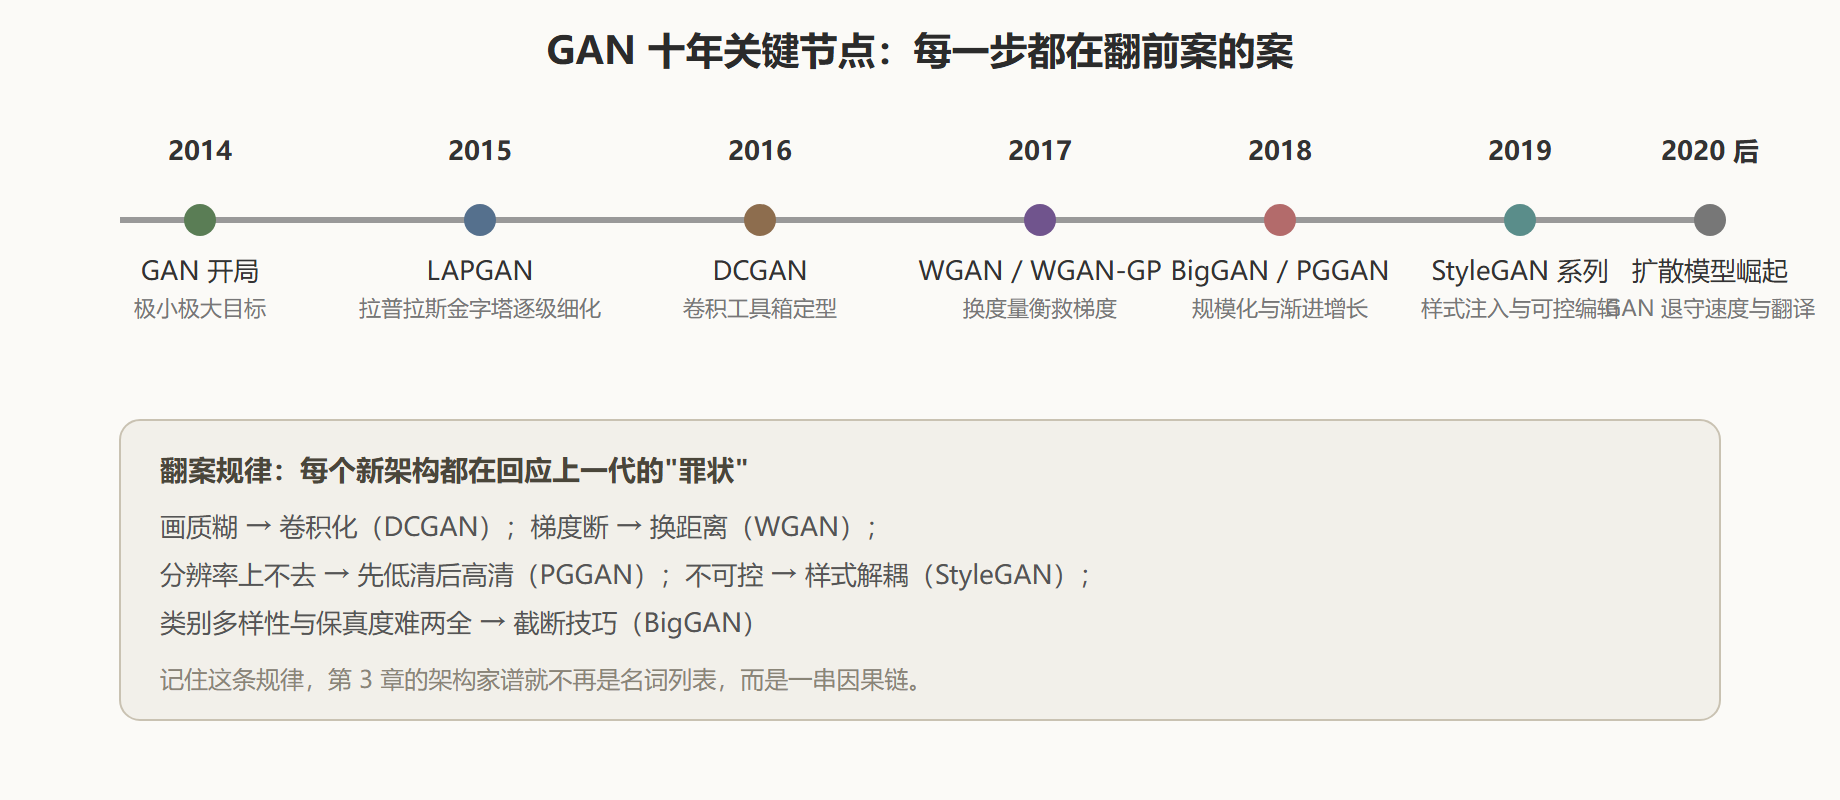
定义与发展时间线
用代码给"两条路"做个对照
与其空谈显式/隐式建模,不如直接用最小代码感受差别。下面的例子只有一维数据,真实分布取均值为 4 的正态:显式路线要对数似然,隐式路线只需要采样后"像不像"。
import numpy as np rng = np.random.default_rng(42) # 真实数据:一维正态,均值 4 data = rng.normal(4.0, 1.0, 2000) # 路线一:显式建模——最大对数似然估计均值与方差 mu_hat = data.mean() var_hat = data.var() loglik = -0.5 * (np.log(2*np.pi*var_hat) + (data - mu_hat)**2 / var_hat).mean() print(f"显式 MLE: mu={mu_hat:.3f}, var={var_hat:.3f}, 平均对数似然={loglik:.4f}") # 输出: 显式 MLE: mu=4.031, var=0.979, 平均对数似然=-1.4159 # 理论最优正态似然约 -1.4189(参数真值处),MLE 略高于它属正常 # 路线二:隐式建模——只采样,不写密度 samples = rng.normal(mu_hat, np.sqrt(var_hat), 5000) print(f"隐式采样: 样本均值={samples.mean():.3f}, 样本标准差={samples.std():.3f}") # 输出: 隐式采样: 样本均值=4.033, 样本标准差=0.987
两条路殊途同归,但复杂场景下差别巨大:显式路线要写密度、算归一化,维度一高就寸步难行;隐式路线把"像不像"外包给判别器,密度永远不出现。GAN 的全部本领与全部麻烦(没有似然可看、评估只能靠 IS/FID,见第 4 章)都源于此。
再看定义句的精确拆解。"两个网络以对抗方式联合训练"包含三个关键词:两个(缺一个博弈就不成立);对抗(损失此消彼长,不是合作训练);联合(交替更新,不是先训完一个再训另一个)。用代码把这三点验证一遍:
# 用两个极简"网络"(常数参数)演示联合训练的交替性 D_acc = 0.5 # 鉴定师当前鉴别准确率 G_quality = 0.0 # 造假者当前工艺水平(0=一眼假, 1=完美) for round_ in range(4): # 鉴定师回合:针对当前造假水平练眼力(准确率提升有上限) D_acc = min(0.99, D_acc + 0.2 * (1 - G_quality)) # 造假者回合:针对当前鉴别水平练工艺(水平提升量与被识破程度挂钩) G_quality = min(1.0, G_quality + 0.3 * max(0, D_acc - G_quality)) print(f"第{round_+1}回合: D_acc={D_acc:.2f}, G_quality={G_quality:.2f}") # 输出: # 第1回合: D_acc=0.70, G_quality=0.21 # 第2回合: D_acc=0.85, G_quality=0.42 # 第3回合: D_acc=0.90, G_quality=0.60 # 第4回合: D_acc=0.83, G_quality=0.75
注意第 4 回合鉴定准确率反而回落:造假者水平上来了,老一套鉴别手段失灵。这个玩具模型预示了 GAN 训练的常态——双方能力互相追逐,曲线从来不是单调的。
本节要点回顾
- 定义三关键词:两个网络、对抗损失、联合交替训练,缺一不成 GAN;
- 两条路:显式建模写密度算似然(VAE 一系),隐式建模只管采样像不像(GAN 一系);
- 起源:2014 年 Goodfellow 提出,动机是用判别器替代写不出的似然函数;
- 十年翻案规律:新架构 = 对旧架构某条罪状的新证据,这条因果链贯穿第 3 章;
- 代价预告:不写密度意味着没有似然可监控,评估问题由此埋下伏笔(第 4、6 章)。
常见问题:起源与定位
GAN 是无监督学习吗? 更准确说是自监督:真假标签由训练流程自动生成,不需要人工标注,但监督信号确实存在。这个区分不是抬杠——它决定了 GAN 可以直接吃未标注数据,这正是它当年让产业兴奋的原因之一。
为什么说 GAN "没有似然"? 显式模型能算出"这张图在模型下的概率",GAN 的生成器只定义了从噪声到样本的映射,密度函数从未出现。好处是绕开了归一化常数这个计算深渊,代价是没有似然可监控——第 4 章的评估指标全是为了补这个缺口。
2014 年之前真的没有生成模型吗? 有,且各有贡献:玻尔兹曼机奠定了能量视角,VAE 变分推断给了"编码-解码"骨架(StyleGAN 的入口改造、扩散模型的潜空间都能看到它的影子)。GAN 的贡献是第三条路:用对抗替代显式密度。
一句话年表(便于记忆)
| 年份 | 记忆锚点 |
|---|---|
| 2014 | 赌局开局:两个网络互相较劲 |
| 2016 | 工具升级:卷积进场(DCGAN) |
| 2017 | 换尺子:梯度不再断供(WGAN) |
| 2019 | 工艺巅峰:属性级可控(StyleGAN) |
| 2020 后 | 赛道分流:扩散接棒通用生成,GAN 守速度与翻译 |